
Guía para Principiantes sobre la Discretización en Modelos de Aprendizaje Automático
En esta página
La discretización en el aprendizaje automático desempeña un papel crucial al transformar datos continuos en formas más manejables y analizables. Muchos conjuntos de datos del mundo real incluyen valores numéricos que varían ampliamente, haciéndolos demasiado detallados para ciertos modelos o interpretaciones. La discretización aborda esto convirtiendo valores continuos en grupos o intervalos distintos.
Esta guía completa explora el concepto de discretización, explicando su definición, diversos tipos, aplicaciones en el mundo real, y las ventajas y desventajas de la técnica. Está diseñada para ser fácilmente comprendida tanto por principiantes como por estudiantes intermedios.
¿Qué es la Discretización en el Aprendizaje Automático?
En el procesamiento de datos, la discretización implica convertir datos numéricos continuos en grupos o intervalos discretos. Por ejemplo, la discretización puede transformar números como 3.2, 7.5 o 10.8 en rangos específicos como "Bajo", "Medio" o "Alto" en lugar de usarlos como números en bruto.
Considere un conjunto de datos con edades que van de 0 a 100. En lugar de ingresar edades en bruto en un modelo, estos valores pueden categorizarse de la siguiente manera:
- 0–18: Adolescente
- 19–35: Joven Adulto
- 36–60: Mediana Edad
- 61–100: Mayor
Al convertir valores continuos en rangos, la discretización simplifica los datos, mejorando el rendimiento de modelos de aprendizaje automático que funcionan mejor con entradas categóricas.
¿Por Qué es Importante la Discretización en el Aprendizaje Automático?
La discretización es particularmente valiosa en escenarios de modelado donde los datos continuos en bruto pueden introducir ruido o confusión. Modelos como los clasificadores Naive Bayes y los árboles de decisión a menudo se benefician de entradas categóricas en lugar de datos continuos.
Las razones por las cuales los practicantes de aprendizaje automático confían en la discretización incluyen:
- Mejora la interpretabilidad del modelo: Las categorías discretas son más fáciles de comprender.
- Simplifica los datos: Convierte datos continuos complejos en intervalos manejables.
- Reduce el ruido: Pequeñas variaciones en datos continuos pueden no contribuir a las predicciones.
- Ayuda a algoritmos específicos: Algunos modelos tienen dificultades con entradas continuas.
- Maneja mejor los valores atípicos: La discretización puede disminuir el impacto de valores extremos.
Tipos de Técnicas de Discretización
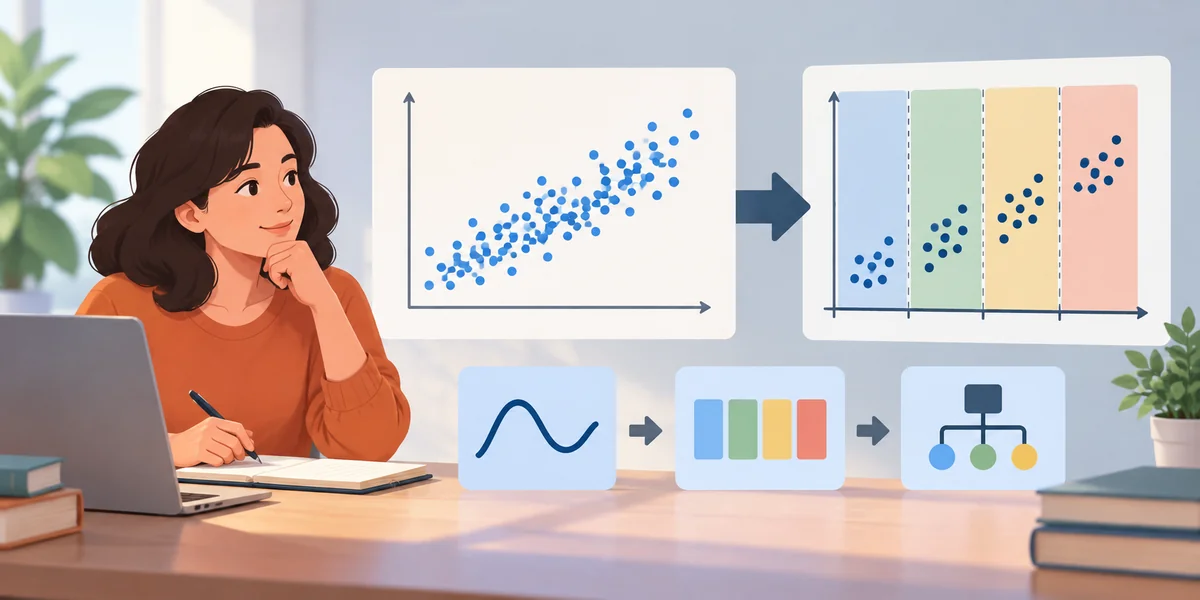
Los métodos de discretización pueden categorizarse en enfoques no supervisados y supervisados. La elección del método depende del conjunto de datos, el modelo utilizado, y el objetivo del análisis.
Discretización No Supervisada
Las técnicas no supervisadas descartan la variable objetivo, centrándose exclusivamente en la distribución de la característica de entrada. Dos técnicas principales no supervisadas son:
Binado de Ancho Igual
En el binado de ancho igual, todo el rango de valores se divide en intervalos de igual tamaño. Por ejemplo, un rango de 0 a 100 dividido en cinco intervalos sería:
- Intervalo 1: 0–20
- Intervalo 2: 21–40
- Intervalo 3: 41–60
- Intervalo 4: 61–80
- Intervalo 5: 81–100
Ventajas: Fácil de implementar y simple de entender.
Desventajas: Puede llevar a una distribución desigual de datos y crear intervalos vacíos o sobrecargados.
Binado de Frecuencia Igual
También conocido como binado por cuantiles, esta técnica asegura que cada intervalo contenga aproximadamente el mismo número de puntos de datos. Para un conjunto de datos con 100 valores y 4 intervalos, cada intervalo contendría 25 valores.
Ventajas: Distribuye los datos uniformemente a través de los intervalos y es efectivo para conjuntos de datos sesgados.
Desventajas: Anchos de intervalo desiguales y valores similares pueden colocarse en intervalos separados.
Discretización Supervisada
Los métodos supervisados utilizan la variable objetivo para formar los intervalos, buscando mejorar el poder predictivo de los intervalos. Un método común en esta categoría es:
Binado Basado en Árbol de Decisión
Este método emplea un algoritmo de árbol de decisión para dividir la variable continua en categorías, encontrando automáticamente los mejores puntos de corte basados en la distribución de la variable objetivo.
Ventajas: Produce intervalos optimizados para la tarea de aprendizaje y se desempeña bien en problemas de clasificación.
Desventajas: Puede sobreajustar los datos y es más costoso computacionalmente.
¿Cuándo Debería Usarse la Discretización?
La discretización no siempre es necesaria, pero es altamente beneficiosa en ciertos escenarios:
- Usando modelos categóricos como Naive Bayes o regresión logística.
- Cuando los datos contienen valores atípicos que necesitan suavizarse.
- Si las características son altamente detalladas, causando ruido en el proceso de aprendizaje.
- Para mejorar la interpretabilidad, especialmente en aplicaciones de negocios o salud.
- Durante la visualización, donde los datos agrupados son más fáciles de graficar y analizar.
Pros y Contras de la Discretización
Si bien la discretización ofrece muchos beneficios, también presenta algunas limitaciones.
Pros:
- Hace que los datos sean más fáciles de interpretar.
- Útil para modelos específicos de aprendizaje automático.
- Ayuda a reducir el sobreajuste en algunos casos.
- Asiste en el manejo de datos ruidosos o con muchos valores atípicos.
Contras:
- Pérdida de información: se eliminan las diferencias finas.
- Puede introducir sesgos si los umbrales de los intervalos no están bien definidos.
- Puede perjudicar el rendimiento de modelos que prefieren entradas continuas (como la regresión lineal).
Mejores Prácticas para la Discretización
Una discretización bien ejecutada puede mejorar significativamente la claridad y usabilidad del modelo. Aquí algunas mejores prácticas:
- Usar conocimiento del dominio para definir límites de intervalo significativos.
- Visualizar los datos antes de agrupar para entender las distribuciones.
- Evitar demasiados intervalos, lo que puede llevar a sobreajuste o complicar la interpretación.
- Probar diferentes técnicas y evaluar el rendimiento del modelo para elegir el mejor método.
- Asegurar el equilibrio de clases en los intervalos para evitar conjuntos de datos sesgados.
Herramientas y Bibliotecas para la Discretización
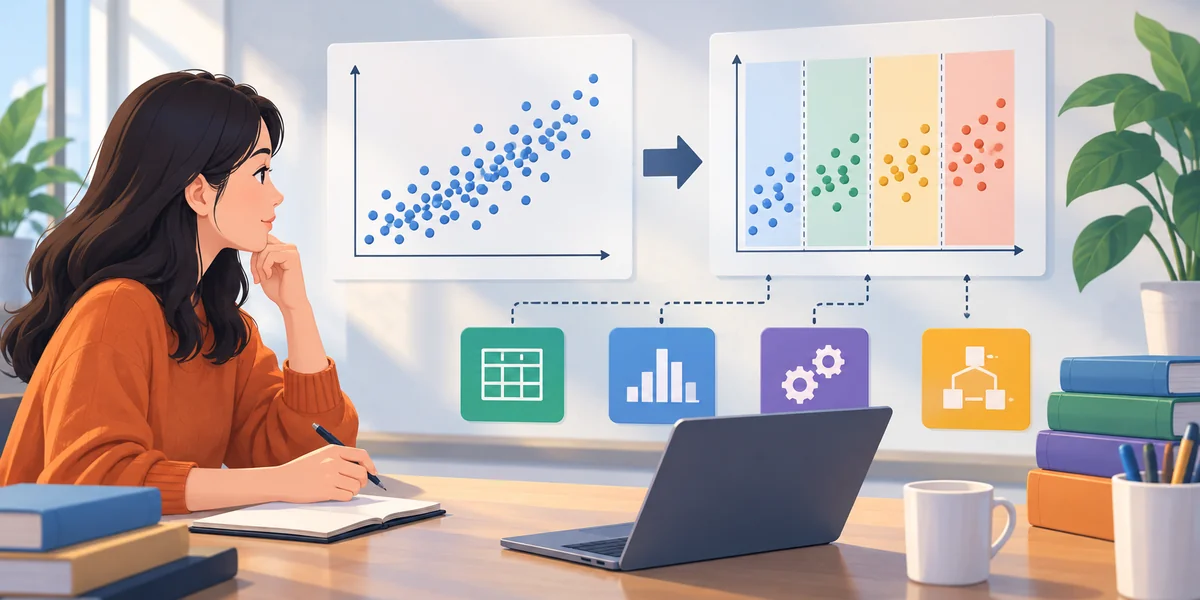
La mayoría de las herramientas y bibliotecas de ciencia de datos ofrecen funciones integradas para la discretización, incluyendo:
- Pandas (Python):
pd.cut()para binado de ancho igual ypd.qcut()para binado de frecuencia igual. - Scikit-learn:
KBinsDiscretizerpara varias estrategias de binado. - Programación en R:
cut()y otras funciones de binado. - Weka: Proporciona discretización supervisada como parte de sus pasos de preprocesamiento.
Estas herramientas automatizan y simplifican el proceso de discretización.
Conclusión
La discretización en el aprendizaje automático es una técnica poderosa para transformar datos continuos en categorías comprensibles y utilizables. Ya sea a través de binado de ancho igual, agrupación basada en frecuencia, o métodos avanzados como divisiones de árboles de decisión, la discretización ayuda a los modelos a aprender mejor, particularmente cuando se trabaja con algoritmos categóricos o conjuntos de datos ruidosos. Mejora la interpretabilidad, reduce el ruido y apoya diversas aplicaciones del mundo real desde la salud hasta las finanzas. Aunque no es necesaria para todos los modelos, saber cuándo y cómo aplicar la discretización es una habilidad valiosa para cualquier científico de datos e ingeniero de aprendizaje automático.
Artículos relacionados

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
3 Historias Inspiradoras de Líderes en IA
Cómo la IA está transformando las estrategias y procesos de marketing en 2025
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos
Revisión Exhaustiva de las Herramientas de IA Generativa de Adobe
Tendencias de SEO 2025: Lo Que Necesitas Saber
Comprendiendo el SEO con IA y su Impacto en el Marketing Digital
Rompiendo Barreras Lingüísticas: El Papel de la IA en la Educación Multilingüe

La IA en la Educación: Abordando Desafíos Éticos en las Pruebas Estandarizadas
Podcasts de IA que Debes Seguir en 2025
Cómo Destacar y Proteger tu Empleo en la Era de la IA Generativa
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
