
Una Guía para Principiantes para Entender el Modelo CBOW en Tareas de PLN
En esta página
En el campo en rápida evolución del Procesamiento del Lenguaje Natural (PLN), las máquinas necesitan cada vez más comprender el lenguaje humano para realizar tareas como la traducción, el análisis de sentimientos y la optimización de búsquedas. Un desafío significativo en este dominio es enseñar a las computadoras a entender el significado de las palabras.
El modelo Continuous Bag of Words (CBOW) fue desarrollado para abordar este desafío. Este modelo es fundamental en la conversión de palabras en valores numéricos que las máquinas pueden procesar, lo que lleva a aplicaciones de PLN más inteligentes y precisas. En esta publicación, profundizaremos en qué es CBOW, cómo funciona y por qué sigue siendo un modelo fundamental para aprender incrustaciones de palabras.
¿Qué es el Continuous Bag of Words (CBOW)?
El Continuous Bag of Words, o CBOW, es una técnica de incrustación de palabras introducida como parte del modelo Word2Vec por Google en 2013. Su función principal es predecir una palabra objetivo basada en su contexto circundante. Este método permite al modelo inferir significados de palabras analizando con qué frecuencia y en qué contexto ciertas palabras aparecen cerca de otras.
Por ejemplo, considere la oración:
"El sol brilla en el cielo azul."
Si "brilla" es la palabra objetivo, el contexto podría incluir ["El", "sol", "en", "el", "cielo", "azul"], dependiendo del tamaño de la ventana. El modelo CBOW aprende que la palabra "brilla" a menudo aparece alrededor de estas palabras, asociándola con conceptos como brillo y clima.
¿Por qué se necesita CBOW?
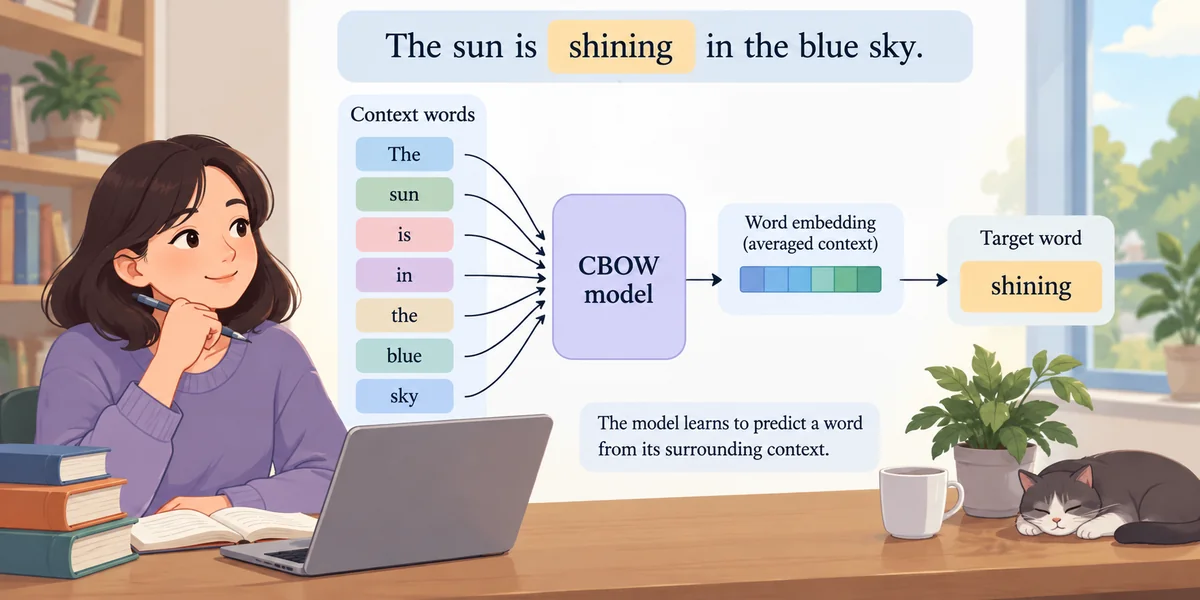
CBOW ofrece una solución sencilla pero poderosa a un gran problema de comprensión del lenguaje: cómo representar palabras de una manera que capture tanto el significado como el contexto. Los modelos tradicionales a menudo usaban métodos como la codificación one-hot, que no lograban reflejar la relación entre las palabras. CBOW introdujo un enfoque más inteligente al crear vectores densos (incrustaciones de palabras) donde las palabras con significados similares tienen representaciones numéricas similares.
Beneficios clave de CBOW:
- Ayuda a las máquinas a entender el significado contextual de las palabras
- Reduce la dimensionalidad, haciendo que los modelos sean más eficientes y rápidos
- Captura relaciones semánticas, como que "París" sea similar a "Londres"
- Soporta tareas prácticas como:
- Corrección ortográfica
- Resumen de texto
- Sistemas de traducción
- Clasificación de sentimientos
¿Cómo funciona el modelo CBOW?
El modelo CBOW aprovecha una red neuronal para predecir una palabra objetivo a partir de las palabras de contexto circundantes. Funciona mejor con grandes conjuntos de datos (corpus de texto) y es relativamente rápido de entrenar. A pesar de su simplicidad, el modelo es altamente efectivo.
El proceso de CBOW implica los siguientes pasos:
- Entrada de texto y preprocesamiento: El texto se limpia, tokeniza y se convierte en secuencias de palabras. A cada palabra se le asigna un índice del vocabulario.
- Creación de ventana de contexto: Para cada palabra en una oración, se selecciona una ventana de palabras circundantes. Por ejemplo, en "Ella disfruta leer libros todas las noches," con un tamaño de ventana de 2, el modelo usa "Ella," "disfruta," "todas," y "noches" como contexto para predecir "leer."
- Codificación one-hot: Cada palabra se transforma en un vector one-hot, una lista de 0s con un único 1 en el índice correspondiente a la palabra en el vocabulario.
- Capa oculta: Los vectores de las palabras de contexto se promedian y pasan a través de una única capa oculta. Aquí, el modelo comienza a aprender patrones y relaciones entre palabras.
- Capa de salida (Softmax): La salida de la capa oculta se utiliza para predecir la probabilidad de que cada palabra del vocabulario sea la palabra objetivo usando una función softmax.
- Cálculo de pérdida y optimización: El modelo compara su predicción con la palabra real. Actualiza sus pesos internos utilizando retropropagación y algoritmos de optimización como el descenso de gradiente estocástico (SGD).
Ejemplo de CBOW en acción
Considere la oración:
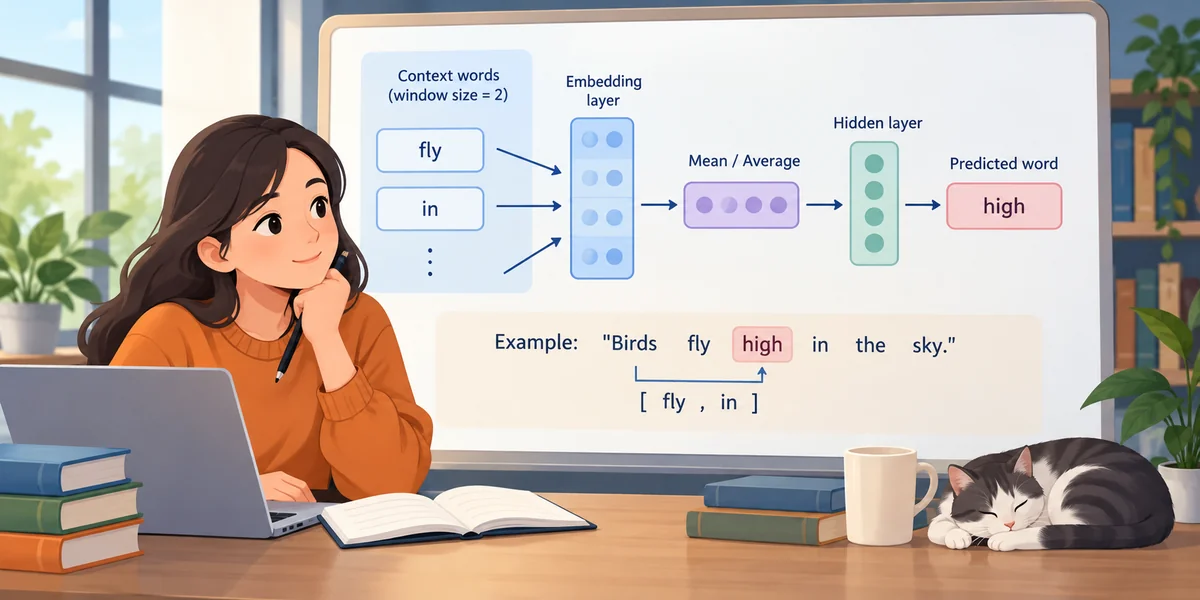
"Los pájaros vuelan alto en el cielo."
Si el modelo pretende predecir la palabra “alto” con una ventana de contexto de 2, usará ["vuelan", "en"] como entrada. A través de numerosos ejemplos de entrenamiento, el modelo CBOW aprende que la palabra “alto” aparece frecuentemente con palabras como “cielo,” “vuelan,” o “pájaros.”
Fortalezas y debilidades de CBOW
Fortalezas:
- Entrenamiento rápido debido a su arquitectura más simple
- Uso eficiente de la memoria
- Rinde bien con palabras frecuentes
- Escala efectivamente en grandes conjuntos de datos
- Genera valiosos vectores de palabras densas
Debilidades:
- Dificultades con palabras raras
- Ignora el orden de las palabras, lo cual puede ser crucial en algunos contextos
- No maneja palabras fuera de vocabulario (OOV) a menos que las incrustaciones preentrenadas se actualicen
- Requiere una cantidad sustancial de texto para rendir de manera óptima
Aplicaciones del mundo real de CBOW
Las incrustaciones de palabras de CBOW se utilizan en numerosas tecnologías del mundo real:
- Motores de búsqueda: Mejorando la comprensión de las consultas de los usuarios
- Asistentes virtuales: Mejorando la comprensión del lenguaje
- Sistemas de recomendación: Sugerir elementos basados en relaciones semánticas
- Corrección ortográfica y gramatical: Prediciendo la palabra correcta a partir del contexto
- Monitoreo de redes sociales: Detectando tendencias y sentimientos de publicaciones
Herramientas y bibliotecas que usan CBOW
Muchas bibliotecas populares ofrecen soporte integrado para el entrenamiento y uso de CBOW:
- Gensim: Una biblioteca de Python para modelado de temas e incrustaciones de palabras
- TensorFlow/Keras: Para implementaciones personalizadas de redes neuronales
- PyTorch: Proporciona la flexibilidad para construir CBOW desde cero
- SpaCy: Ofrece vectores de palabras preentrenados usando CBOW y modelos similares
Estas herramientas facilitan la experimentación con CBOW en diversas tareas de PLN para desarrolladores e investigadores.
Consejos para comenzar con CBOW
Si estás interesado en explorar CBOW de manera práctica, aquí tienes algunos consejos para empezar:
- Comienza con un conjunto de datos pequeño como reseñas de productos o titulares de noticias.
- Usa Gensim para entrenar un modelo CBOW con solo unas pocas líneas de código.
- Experimenta con diferentes tamaños de ventana para ver cómo el contexto afecta las predicciones.
- Compara los vectores de palabras generados por CBOW con los resultados de Skip-gram.
- Visualiza las incrustaciones usando t-SNE para observar cómo se agrupan palabras similares.
Conclusión
CBOW sigue siendo un modelo crucial en la historia de la comprensión del lenguaje natural. Su capacidad para generar incrustaciones de palabras significativas de manera eficiente lo convierte en un modelo fundamental para muchas aplicaciones de PLN hoy en día. Incluso con el auge de los transformadores y los grandes modelos de lenguaje, CBOW sigue ofreciendo valor en tareas de lenguaje rápidas y ligeras. Para cualquier persona que comience en PLN, entender cómo funciona CBOW proporciona una base sólida. Enfatiza el concepto central de que el contexto importa, un principio sobre el cual los sistemas modernos de IA continúan construyendo.
Artículos relacionados
Guía para Principiantes sobre Probabilidad Conjunta, Marginal y Condicional
Tecnología de Gemelos Digitales: Usos Reales, Tipos y Beneficios Clave
Cómo UltraCamp utiliza la IA para construir conexiones reflexivas con los clientes
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Comprendiendo el Impacto de la IA en la Escritura Creativa
5 Acciones de IA Generativa a Vigilar para Oportunidades de Inversión en 2025
MCP Explicado: Cómo Permite a los Modelos de IA Trabajar con Contexto y Datos

Cómo Utilizar Tablas de Apache Iceberg para una Gestión Eficiente de Data Lakes
Ray: La Forma Más Inteligente de Escalar Cargas de Trabajo de IA y Aprendizaje Automático
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
