
Cómo Utilizar Tablas de Apache Iceberg para una Gestión Eficiente de Data Lakes
En esta página
Gestionar conjuntos de datos a gran escala presenta desafíos, particularmente en términos de rendimiento, consistencia y escalabilidad. Apache Iceberg simplifica estos desafíos al proporcionar un formato de tabla robusto para sistemas de big data como Apache Spark, Flink, Trino y Hive. Permite a los ingenieros de datos y analistas consultar, insertar y actualizar datos sin problemas, eliminando las complejidades asociadas con formatos de tabla tradicionales como Hive. En esta publicación, te guiaremos sobre cómo utilizar tablas de Apache Iceberg, cubriendo desde la configuración básica hasta las operaciones comunes, de manera sencilla.
¿Qué es Apache Iceberg?
Apache Iceberg es un formato de tabla diseñado para análisis de datos a gran escala. Estructura los datos de una manera que asegura consultas confiables, actualizaciones eficientes y un fácil mantenimiento, incluso a través de múltiples motores de computación como Apache Spark, Flink, Trino y Hive.
Desarrollado inicialmente en Netflix, Iceberg aborda los desafíos que presentan los formatos de tabla no confiables en los lagos de datos. Garantiza un rendimiento consistente, facilita actualizaciones de esquema fáciles y proporciona acceso seguro y versionado a conjuntos de datos extensos. Con Iceberg, los ingenieros de datos y analistas pueden concentrarse en la calidad y consistencia de los datos sin los obstáculos técnicos de gestionar vastos lagos de datos.
¿Por Qué Usar Tablas Iceberg?
El uso de tablas de Apache Iceberg en lagos de datos ofrece numerosas ventajas:
- Consultas Confiables: Consultas de datos consistentes a través de múltiples motores.
- Evolución de Esquema: Modificar columnas sin afectar el rendimiento o los datos históricos.
- Viaje en el Tiempo: Acceso a versiones anteriores de datos para auditoría o propósitos de reversión.
- Flexibilidad de Partición: Soporta particionamiento oculto, eliminando la necesidad de filtros de partición codificados.
- Alto Rendimiento: Optimiza los escaneos de datos minimizando archivos pequeños.
Estas características hacen que Iceberg sea ideal para empresas que manejan petabytes de datos o pipelines de datos complejos.
Conceptos Clave Detrás de Iceberg
Antes de implementar Iceberg, es crucial entender estos conceptos clave:
Formato de Tabla
Iceberg emplea una estructura impulsada por metadatos, manteniendo un conjunto de archivos de metadatos para rastrear archivos de datos y su disposición. Estos archivos ayudan a la tabla a identificar qué datos pertenecen a qué versión o instantánea.
Instantáneas
Cada vez que una tabla sufre cambios, como inserciones, eliminaciones o actualizaciones de datos, se crea una nueva instantánea. Esta característica permite a los usuarios volver a estados anteriores de la tabla.
Particionamiento
Iceberg simplifica la escritura de consultas y mejora el rendimiento al permitir el particionamiento automático y oculto, evitando así escaneos completos innecesarios de la tabla.
Configuración de Apache Iceberg
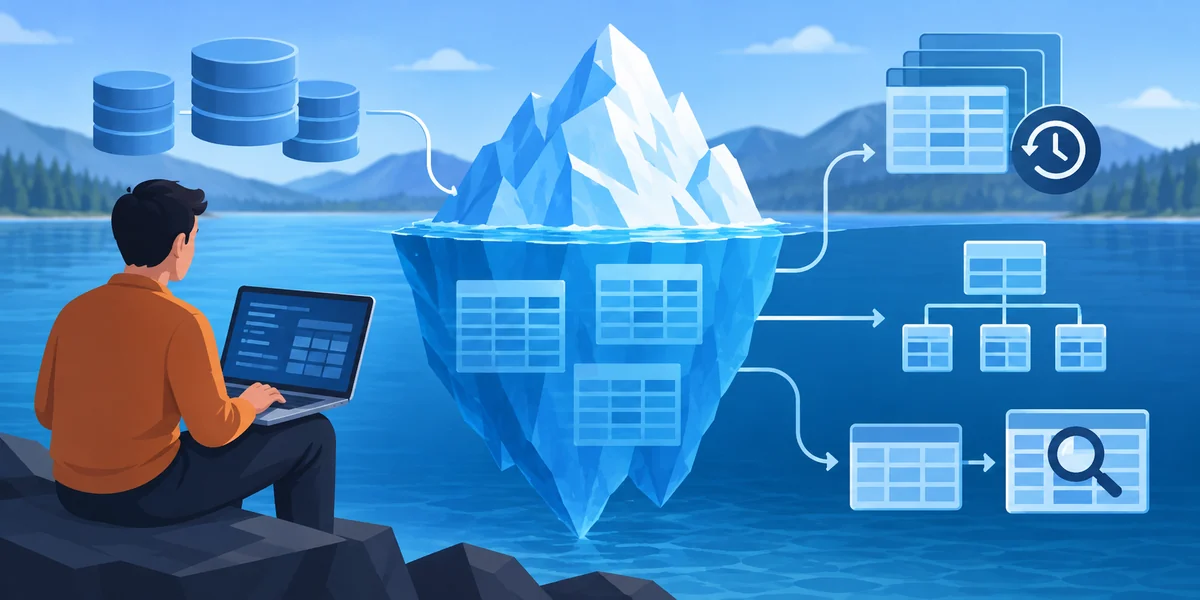
Apache Iceberg soporta varios motores. Para usarlo, los usuarios deben seleccionar la integración adecuada para su entorno.
Paso 1: Elegir un Motor de Procesamiento
Iceberg soporta los siguientes motores:
- Apache Spark
- Apache Flink
- Trino (anteriormente PrestoSQL)
- Apache Hive
Aunque cada motor tiene su propio proceso de configuración, todos utilizan el mismo formato de tabla.
Paso 2: Agregar las Dependencias Requeridas
Los usuarios de Spark pueden agregar soporte para Iceberg mediante:
spark-shell \ --packages org.apache.iceberg:iceberg-spark-runtime-3.3_2.12:1.4.0
Los usuarios de Flink necesitan incluir el conector JAR de Iceberg, mientras que los usuarios de Trino y Hive deben configurar sus catálogos para reconocer tablas de Iceberg.
Creación de Tablas Iceberg
Una vez que el entorno está configurado, los usuarios pueden crear tablas de Iceberg usando SQL o código, dependiendo del motor.
Crear Tablas Iceberg en Spark o Trino
Aquí tienes un ejemplo usando sintaxis SQL en Spark o Trino:
Creación de Tabla Basada en SQL
CREATE TABLE catalog_name.database_name.table_name (
user_id BIGINT,
username STRING,
signup_time TIMESTAMP
)
USING iceberg
PARTITIONED BY (days(signup_time));
Este ejemplo crea una tabla particionada, mejorando el filtrado eficiente y consultas más rápidas.
Realizando Operaciones CRUD con Iceberg
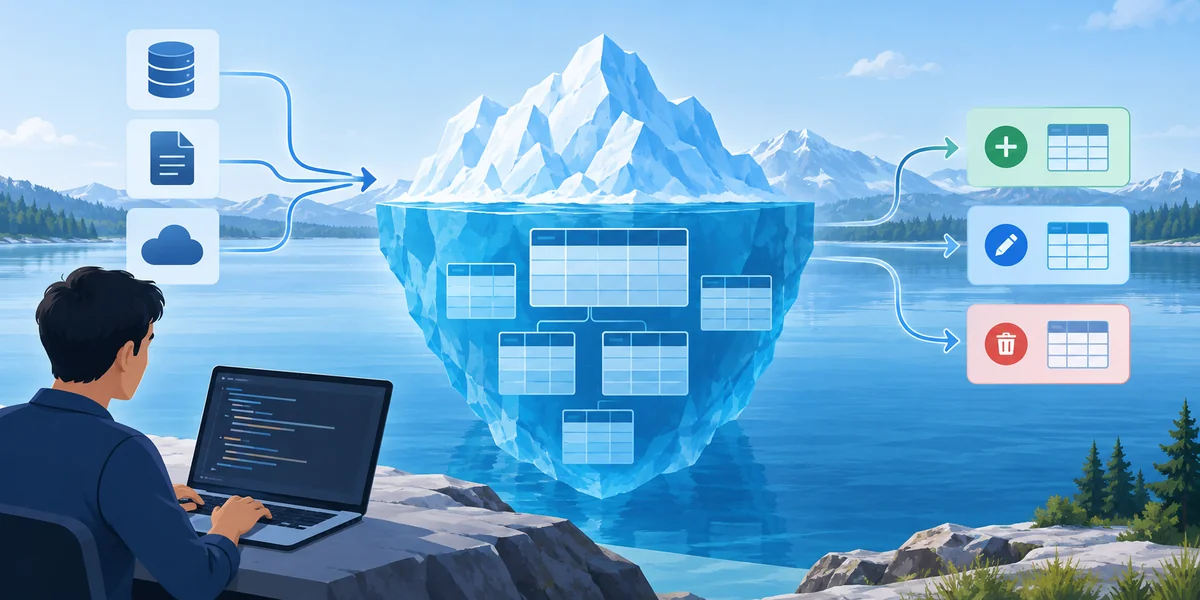
Apache Iceberg soporta completamente funciones de manipulación de datos, permitiendo inserciones, actualizaciones y eliminaciones seguras y eficientes.
Insertar Datos
INSERT INTO database_name.table_name VALUES (1, 'Alice', current_timestamp());
Actualizar Datos
UPDATE database_name.table_name
SET username = 'Alicia'
WHERE user_id = 1;
Eliminar Datos
DELETE FROM database_name.table_name WHERE user_id = 1;
Estas operaciones se ejecutan como transacciones, creando nuevas instantáneas en segundo plano.
Usando el Viaje en el Tiempo en Iceberg
Una de las características destacadas de Iceberg es la capacidad de revertir a versiones anteriores de una tabla.
Consultar una Instantánea Anterior
SELECT * FROM database_name.table_name
VERSION AS OF 192837465; -- ID de instantánea
O por marca de tiempo:
SELECT * FROM database_name.table_name
TIMESTAMP AS OF '2025-04-01T08:00:00';
El viaje en el tiempo es invaluable para auditorías, depuración o recuperación de escrituras erróneas.
Evolución del Esquema de la Tabla
Iceberg soporta la evolución del esquema, permitiendo a los usuarios modificar la estructura de la tabla con el tiempo sin afectar los datos antiguos.
Agregar Columna
ALTER TABLE database_name.table_name ADD COLUMN user_email STRING;
Eliminar Columna
ALTER TABLE database_name.table_name DROP COLUMN user_email;
Renombrar Columna
ALTER TABLE database_name.table_name RENAME COLUMN user_email TO email;
Estos cambios de esquema también están versionados y pueden deshacerse usando el viaje en el tiempo.
Gestionando Tablas Iceberg
Gestionar tablas de Iceberg implica optimizar el rendimiento, manejar metadatos y asegurar la limpieza de archivos antiguos. Un mantenimiento adecuado asegura que Iceberg opere eficientemente a escala.
Consejos de Optimización
- Habilitar Compactación de Archivos: Fusiona archivos pequeños en más grandes, mejorando la eficiencia de escaneo de datos.
- Expirar Instantáneas Antiguas: Elimina regularmente instantáneas y archivos de metadatos obsoletos para liberar almacenamiento y mejorar el rendimiento de las consultas.
- Usar Tablas de Metadatos: Iceberg ofrece tablas como
table_name.snapshotsytable_name.historypara monitoreo y consulta de metadatos.
Casos de Uso Comunes
Apache Iceberg es versátil y adecuado para varios escenarios de negocios:
- Data Lakehouse: Combina la flexibilidad de los lagos de datos con características de almacenes de datos. Iceberg facilita una arquitectura de datos unificada que soporta análisis por lotes y en tiempo real.
- Pipelines de Machine Learning: Mantiene conjuntos de características y seguimiento de experimentos. Iceberg ayuda a los científicos y ingenieros de datos a gestionar conjuntos de datos a gran escala para el entrenamiento de modelos ML.
- Flujos de Trabajo ETL: Construye pipelines de datos confiables y reiniciables. Las transacciones ACID de Iceberg aseguran reintentos seguros y monitoreo de trabajos ETL.
- Auditoría y Cumplimiento: Accede instantáneamente a datos históricos para revisiones. Las capacidades de viaje en el tiempo de Iceberg facilitan el cumplimiento al rastrear cambios en los datos.
Conclusión
Apache Iceberg proporciona un enfoque moderno y robusto para gestionar lagos de datos. Al soportar operaciones SQL completas, evolución de esquemas y viaje en el tiempo, empodera a los equipos para construir sistemas de datos confiables, escalables y flexibles. Las organizaciones que buscan un mejor rendimiento, una gobernanza de datos más fácil y una interoperabilidad de motores encontrarán en Iceberg un activo valioso. Con esta guía, cualquier ingeniero o analista de datos puede comenzar a usar Iceberg y aprovechar al máximo sus capacidades.
Artículos relacionados
Comprendiendo el Impacto de la IA en la Escritura Creativa
Ray: La Forma Más Inteligente de Escalar Cargas de Trabajo de IA y Aprendizaje Automático
Tecnología de Gemelos Digitales: Usos Reales, Tipos y Beneficios Clave
El Futuro de la IA en la Publicidad Digital
8 Métodos Simples para Humanizar tu Escritura con IA
Cómo UltraCamp utiliza la IA para construir conexiones reflexivas con los clientes
El Test de Turing Explicado: ¿Pueden las Máquinas Lograr un Pensamiento Humano?
¿Qué es la Inteligencia Artificial? Una Guía para Principiantes sobre los Fundamentos de la IA
Inteligencia Artificial para Principiantes
ChatGPT está reemplazando rápidamente estos 4 tipos de sitios web populares
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
