
Una Guía de Flax: Redes Neuronales Eficientes con JAX para Desarrolladores
En esta página
Escalando Modelos de Aprendizaje Automático: Por qué Flax es el Futuro
Los modelos de aprendizaje automático están evolucionando en tamaño, complejidad y requisitos de implementación. Elegir el marco adecuado es crucial. Mientras PyTorch y TensorFlow lideran el mercado, una nueva ola de herramientas está redefiniendo cómo construimos redes neuronales—de manera más eficiente, transparente y con un rendimiento mejorado.
Flax, construido sobre JAX, es un marco líder en esta revolución. Esta guía explora cómo Flax te capacita para construir redes neuronales eficientes, por qué es popular entre investigadores e ingenieros, y cómo puedes integrarlo en tus proyectos.
¿Qué Hace a Flax Diferente?
Flax es una biblioteca de redes neuronales flexible y de alto rendimiento que aprovecha el poder computacional de JAX. A diferencia de muchas bibliotecas que sacrifican control por abstracción, Flax ofrece control completo sobre tu modelo, sus parámetros y su dinámica de entrenamiento—sin comprometer la velocidad o la legibilidad.
Características Clave de Flax:
-
Filosofía de Programación Funcional: Flax trata los modelos como funciones puras. En lugar de ocultar los parámetros del modelo, los defines y pasas explícitamente, mejorando la reproducibilidad y la depuración.
-
El Poder de JAX: JAX ofrece diferenciación automática, compilación al vuelo y aceleración por hardware. Flax se basa en esto, proporcionando una interfaz de red neuronal más limpia.
-
Separación Clara de Responsabilidades: La estructura del modelo se define por separado de la inicialización y actualización de parámetros. Este enfoque único promueve la eficiencia y la claridad.
Construcción de Redes Neuronales Eficientes: Por qué Flax Gana
La eficiencia en el aprendizaje automático abarca entrenamiento más rápido, productividad del desarrollador, escalabilidad y facilidad de depuración. Flax sobresale en todas estas áreas con su enfoque funcional, construcción de modelos simplificada y herramientas robustas de gestión del flujo de trabajo.
1. Construcción Eficiente de Modelos
Usando la API Linen de Flax, puedes definir arquitecturas complejas como perceptrones multicapa, redes convolucionales o transformadores con código modular y reutilizable. Flax separa la arquitectura del modelo de los datos y el estado, minimizando errores al hacer explícitos los flujos de datos y parámetros.
2. Entrenamiento de Alto Rendimiento con JAX
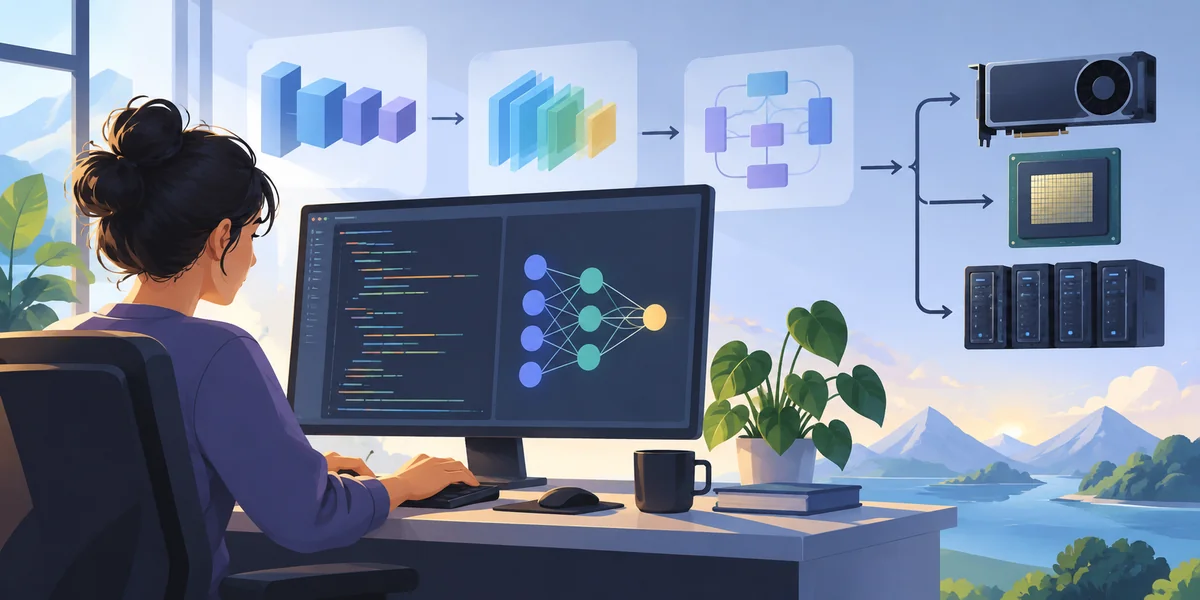
Flax aprovecha la compilación al vuelo (JIT) basada en XLA de JAX, acelerando significativamente las operaciones numéricas. Ya sea en GPU, TPU o CPU, los modelos se compilan en código máquina eficiente optimizado para el hardware.
Con las transformaciones grad, vmap y pmap de JAX, puedes:
- Calcular gradientes de forma limpia
- Vectorizar cálculos sobre lotes
- Escalar a múltiples dispositivos con un mínimo de código
Esto resulta en ciclos de entrenamiento más rápidos y una mejor utilización de recursos, especialmente con conjuntos de datos o modelos grandes.
3. Flexibilidad del Optimizador con Optax
Entrenar una red neuronal implica más que definir una función de pérdida y calcular gradientes. Optax, una biblioteca de transformación de gradiente componible, se integra perfectamente con Flax. Ya sea utilizando descenso de gradiente estocástico o optimizadores avanzados como AdamW, Optax ofrece una interfaz funcional limpia, asegurando estados de optimización trazables y depurables.
Un Flujo de Trabajo Típico con Flax
Para construir una red neuronal con Flax, sigue estos pasos:
-
Define el Modelo: Crea una clase que herede de nn.Module, delineando transformaciones de entrada a salida capa por capa. Usa decoradores para un código más limpio y registro automático de parámetros.
-
Inicializa los Parámetros: A diferencia de los marcos tradicionales, los parámetros se inicializan usando semillas aleatorias y formas de entrada ficticias, no se almacenan dentro del modelo.
-
Aplica el Modelo: Ejecuta una pasada hacia adelante pasando entradas y parámetros, asegurando un cálculo puro y determinista.
-
Calcula la Pérdida: Usa una función de pérdida personalizada para comparar las predicciones con la verdad del terreno. Las herramientas integradas de JAX simplifican el cálculo de gradientes.
-
Actualiza los Parámetros: Aplica los gradientes usando Optax, con actualizaciones de estado externas que aseguran cambios deliberados y visibles.
-
Rastrea Variables de Estado: Gestiona estados mutables como la media móvil con colecciones nombradas, dando control detallado sobre las actualizaciones de pasos de entrenamiento.
Guardar y Cargar Redes Neuronales
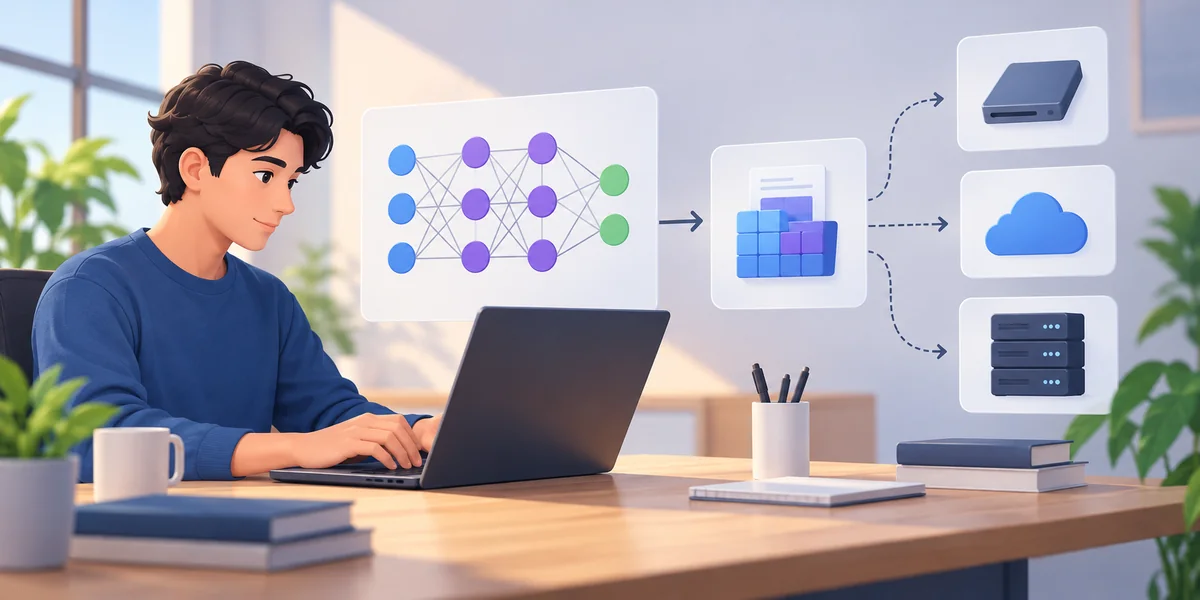
Después de entrenar tu modelo, guarda sus parámetros para uso futuro o implementación. Las utilidades de serialización de Flax convierten árboles de parámetros en bytes o diccionarios para almacenamiento local, uso en la nube o compartición de servicios. Con entidades de modelo y parámetros separadas, puedes experimentar fácilmente con aprendizaje por transferencia o ajuste fino.
Gestionando el Estado en Redes Neuronales Reales
Las redes neuronales eficientes a menudo requieren gestión de estado interno. Flax maneja esto sin perder eficiencia:
- Variables Explícitas: Definidas usando self.variable(…)
- Actualizaciones Controladas: Decide qué variables se actualizan durante cada pasada
- Sin Comportamientos Ocultos: Los cambios de estado ocurren en tu ruta de control
Flax es ideal para casos de uso avanzados como agentes de aprendizaje por refuerzo, modelos generativos o cualquier lógica con estado de larga duración.
Conclusión
En el panorama actual del aprendizaje automático, el control, la reproducibilidad y el rendimiento son esenciales. Flax prospera en este entorno, permitiendo la construcción eficiente de redes neuronales de manera funcional, transparente y de alto rendimiento. Ya sea que estés prototipando o implementando redes escalables, Flax + JAX ofrece todo lo que necesitas—sin el desorden. Adopta Flax para un futuro de IA más inteligente, respaldado por un ecosistema y una comunidad en crecimiento.
Artículos relacionados
CNN vs. GAN: ¿En qué se Diferencian?
Explorando el Concepto de Redes de Kolmogorov-Arnold
Términos Clave de la IA Generativa Explicados
Una Guía para Principiantes para Entender el Modelo CBOW en Tareas de PLN
Normalización por Lote vs. Normalización por Capa: Diferencias Clave en el Aprendizaje Profundo
Comprender la IA Simbólica vs. Conexionismo en la Inteligencia Artificial
10 Conceptos Críticos de IA Explicados en 5 Minutos
Clasificación de Imágenes en IA: Cómo las Máquinas Aprenden a Reconocer Imágenes
10 Bibliotecas Esenciales de Python que Facilitan el Análisis de Datos

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal
La IA en la Gestión de Instalaciones: Entrando en una Nueva Era de Operaciones Inteligentes
Biblioteca Pandas de Python: Una Guía Completa para el Análisis de Datos
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
