
Optimizar los Canales de Incrustación con Transmisión de Vectores Potenciada por Rust
En esta página
Procesar y manejar incrustaciones a gran escala es crucial en la era actual de crecimiento de datos y la necesidad de aplicaciones más rápidas, escalables e inteligentes. Las técnicas tradicionales de incrustación, aunque efectivas para contextos a pequeña escala, comienzan a mostrar limitaciones cuando se aplican a documentos grandes, datos multimodales o entornos con recursos limitados.
Nace así la transmisión de vectores, una nueva característica en el marco de EmbedAnything diseñada para abordar estas limitaciones. Lo que la hace aún más poderosa es su implementación en Rust, un lenguaje de programación de sistemas celebrado por su velocidad, seguridad en memoria y soporte para concurrencia.
Este artículo profundiza en cómo la transmisión de vectores potenciada por Rust lleva a la práctica la indexación eficiente en memoria y por qué esto representa un avance significativo para los canales de incrustación y aplicaciones de búsqueda vectorial.
Entendiendo el Problema con los Canales de Incrustación Tradicionales
La mayoría de los canales tradicionales para generar incrustaciones vectoriales a partir de documentos siguen un proceso de dos pasos:
- Fragmentación: Extraer y dividir contenido de archivos fuente en piezas manejables.
- Incrustación: Alimentar estos fragmentos a un modelo de incrustación en lotes.
Este método funciona adecuadamente con conjuntos de datos pequeños. Sin embargo, a medida que aumenta el número de archivos o los modelos se vuelven más grandes y sofisticados, especialmente cuando se involucran incrustaciones multivectoriales, surgen varios problemas relacionados con el rendimiento y la memoria:
- Todos los fragmentos e incrustaciones se mantienen en memoria hasta que se completa todo el proceso.
- La ejecución sincrónica desperdicia tiempo mientras espera que los fragmentos terminen antes de que comience la incrustación.
- La incrustación a escala requiere alta RAM, lo que lleva a cuellos de botella en recursos o ralentizaciones del sistema.
Cuando se aplica a conjuntos de datos del mundo real con alta dimensionalidad o modalidades de imagen y texto, este proceso se vuelve ineficiente e insostenible.
Transmisión de Vectores: La Solución Potenciada por Rust
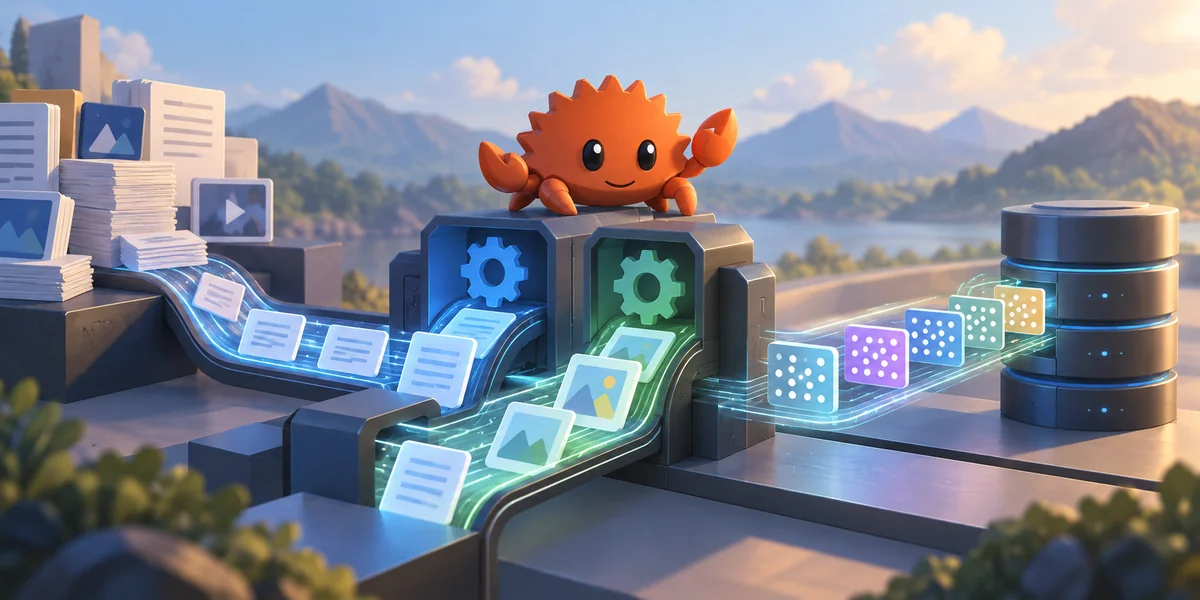
Para superar estos desafíos, EmbedAnything introduce la transmisión de vectores, una nueva arquitectura que aprovecha la fragmentación y la incrustación asincrónica, construida utilizando el modelo de concurrencia de Rust.
En su núcleo, la transmisión de vectores reimagina cómo fluye el proceso de incrustación. En lugar de tratar la fragmentación y la incrustación como operaciones aisladas y secuenciales, transmite datos entre ellas utilizando hilos concurrentes.
Así es como funciona:
- Un hilo fragmenta asincrónicamente los datos de entrada y los envía a un búfer.
- A medida que el búfer se llena, otro hilo incrusta los fragmentos, manteniendo un flujo fluido.
- Una vez creadas las incrustaciones, se envían de vuelta al hilo principal, que las traslada a la base de datos vectorial.
- En cada etapa, los datos se borran de la memoria una vez procesados, minimizando el uso de memoria.
Este enfoque elimina el tiempo de inactividad y hace un uso más efectivo de los recursos informáticos disponibles, manteniendo el consumo de memoria bajo control.
¿Por qué Rust lo Hace Posible?
Rust es un lenguaje ideal para construir sistemas concurrentes críticos en cuanto a rendimiento. La elección de implementar la transmisión de vectores en Rust fue estratégica, ya que Rust ofrece:
- Abstracciones de costo cero para un rendimiento que rivaliza con C/C++.
- Fuerte seguridad de memoria sin necesidad de un recolector de basura.
- Soporte nativo para concurrencia, permitiendo que múltiples hilos operen de manera segura.
Usando el módulo MPSC de Rust, la transmisión de vectores permite un flujo de datos basado en mensajes entre hilos. El modelo de incrustación no espera a que se creen todos los fragmentos; en cambio, comienza a incrustar tan pronto como los datos están disponibles.
Resolviendo Cuellos de Botella Reales en los Flujos de Trabajo de Incrustación
Con los canales sincrónicos tradicionales, cuantas más documentos tengas, más memoria y tiempo demanda el sistema. Cuando se involucra la incrustación multivectorial, donde se generan múltiples vectores por fragmento, el desafío se multiplica.
La transmisión de vectores aborda directamente estos problemas:
- No se necesitan sistemas de alta RAM: Dado que los datos se procesan y descartan en tiempo real, solo un pequeño búfer permanece en memoria.
- Elimina fases de inactividad: La incrustación comienza tan pronto como los fragmentos están disponibles, reduciendo los tiempos de espera.
- Adaptable a múltiples modalidades: Funciona igualmente bien para imágenes, texto y otros formatos de datos.
- Soporta la incrustación a gran escala: Hace factible incrustar conjuntos de datos enormes sin tensión en los recursos.
El resultado es un canal más escalable y eficiente para desarrolladores, investigadores e ingenieros que trabajan en aplicaciones impulsadas por IA.
Integración con Bases de Datos Vectoriales como Weaviate
Una vez generadas las incrustaciones, necesitan ser indexadas para búsqueda y recuperación. La transmisión de vectores se integra sin problemas con bases de datos como Weaviate, ofreciendo una transición suave de incrustación a almacenamiento.
La arquitectura incluye un adaptador de base de datos que maneja:
- Configuración de conexión
- Creación de índices
- Conversión de metadatos
- Actualizaciones en lote de vectores
Esta modularidad permite a los desarrolladores conectar y jugar con diferentes bases de datos vectoriales sin modificar la lógica central de incrustación.
Configuración y Control
La transmisión de vectores en EmbedAnything está diseñada con flexibilidad en mente. Los desarrolladores pueden personalizar lo siguiente:
- Modelo de incrustación: Elegir entre modelos locales o alojados en la nube, incluidos modelos basados en imágenes como CLIP.
- Tamaño de fragmento: Definir cuán grande debe ser cada fragmento.
- Tamaño de búfer: Controlar cuántos fragmentos se almacenan y procesan a la vez.
Estos parámetros ofrecen control total sobre la optimización del rendimiento y permiten ajustes según las restricciones de hardware. Idealmente, el tamaño del búfer debe ser tan grande como el sistema pueda soportar para un rendimiento máximo.
Beneficios de la Transmisión de Vectores para la Indexación Eficiente en Memoria
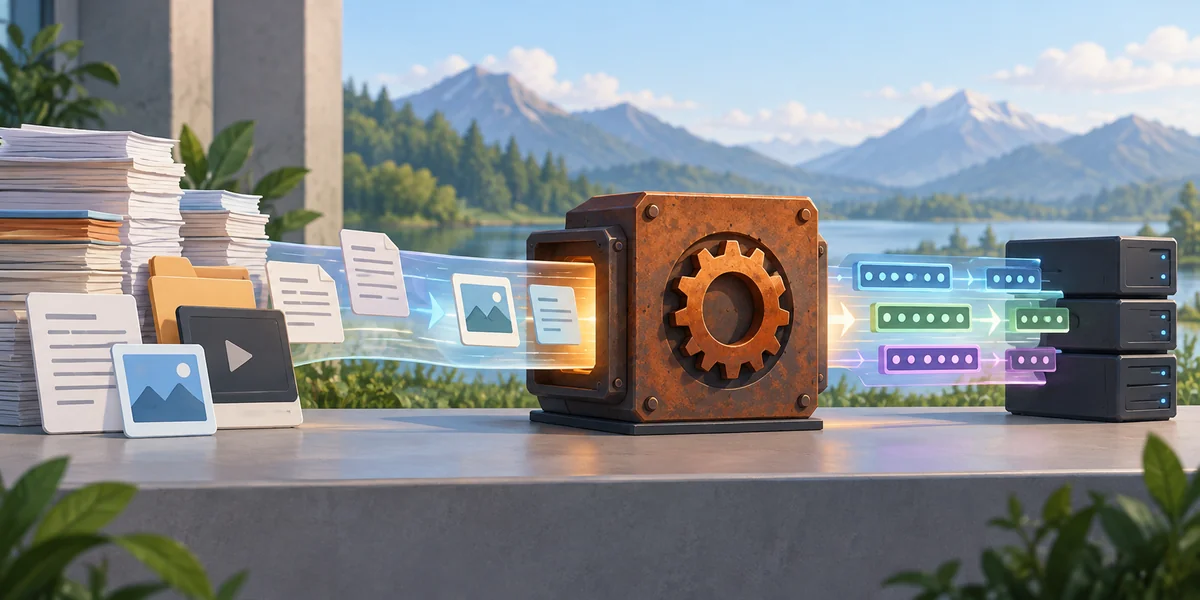
El impacto de la transmisión de vectores va más allá de la optimización teórica, aportando ganancias tangibles de rendimiento y simplicidad operativa para desarrolladores, ingenieros e investigadores. Aquí están los beneficios clave:
Reducción Drástica del Uso de Memoria
Los canales tradicionales requieren cargar todos los datos en memoria antes de procesarlos. En contraste, la transmisión de vectores mantiene solo un pequeño búfer de fragmentos e incrustaciones en memoria a la vez.
Procesamiento Paralelo para Resultados Más Rápidos
La fragmentación y la incrustación se ejecutan concurrentemente, lo que significa que no hay tiempo de inactividad entre etapas. La incrustación puede comenzar tan pronto como los primeros fragmentos estén listos, reduciendo el tiempo total de ejecución y aumentando el rendimiento del canal.
Integración Simplificada
Con adaptadores modulares para bases de datos vectoriales y un diseño de API limpio, la incrustación y la indexación ya no están separadas por código complejo. El flujo de datos sin procesar a la base de datos vectorial es fluido y requiere un esfuerzo mínimo por parte del desarrollador.
Esto refuerza la transmisión de vectores como una solución potenciada por Rust para una indexación verdaderamente eficiente en memoria.
Conclusión
La transmisión de vectores con Rust ofrece una solución moderna, eficiente y amigable para el desarrollador a los antiguos problemas de saturación de memoria e ineficiencia en los canales de incrustación. Con su uso inteligente de la concurrencia y el diseño basado en flujos, permite el procesamiento rápido y de baja memoria de datos a gran escala, ideal para aplicaciones del mundo real en búsqueda, recomendación e IA. A medida que los datos crecen y los canales de incrustación se vuelven más integrales a los sistemas modernos, herramientas como EmbedAnything, combinadas con el rendimiento de Rust, prometen cambiar nuestra manera de pensar sobre la indexación a gran escala.
Artículos relacionados
Aerospike Añade Nuevas Capacidades de Búsqueda Vectorial a su Base de Datos
Máquinas de Vectores de Soporte (SVM): Cómo Impulsan los Modelos de Aprendizaje Automático
9 Herramientas de SEO con IA que Debes Probar en 2025
Optimizando DeepSeek Localmente: La Guía Definitiva de Configuración
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
