
Uso de MaskFormer para Segmentar Imágenes con Objetos Superpuestos
En esta página
En la segmentación de imágenes, identificar objetos individuales en una escena se vuelve significativamente más desafiante cuando estos objetos se superponen. Los modelos de segmentación tradicionales suelen tener dificultades para separar estas entidades, a menudo fusionando múltiples instancias de la misma clase en una sola predicción. Aquí es donde MaskFormer introduce un avance significativo.
Desarrollado con una arquitectura basada en transformers, MaskFormer sobresale en la distinción entre instancias individuales de objetos, incluso cuando sus áreas delimitantes se intersectan o superponen. Este artículo explicará cómo MaskFormer aborda la segmentación de objetos superpuestos, explorará su arquitectura de modelo y mostrará cómo implementarlo para dichas tareas.
¿Por Qué es Difícil la Segmentación de Objetos Superpuestos?
Los objetos superpuestos comparten regiones espaciales en una imagen, creando ambigüedad en los límites y características visuales. Los modelos de segmentación tradicionales, que predicen una etiqueta por píxel, funcionan bien para regiones no intersecadas, pero se vuelven poco fiables cuando múltiples instancias comparten espacio visual.
En tales casos:
- La segmentación semántica asigna una etiqueta de clase por píxel (por ejemplo, “coche”), pero falla en distinguir entre diferentes coches en la misma imagen.
- Se requiere segmentación de instancias para separar cada objeto, etiquetándolos como entidades distintas (por ejemplo, “coche1”, “coche2”).
MaskFormer aborda esta complejidad integrando la predicción de máscaras con la asignación de clases, utilizando características decodificadas por transformers para predecir máscaras binarias para instancias de objetos, sin importar cuán estrechamente o completamente se superpongan.
Arquitectura de MaskFormer
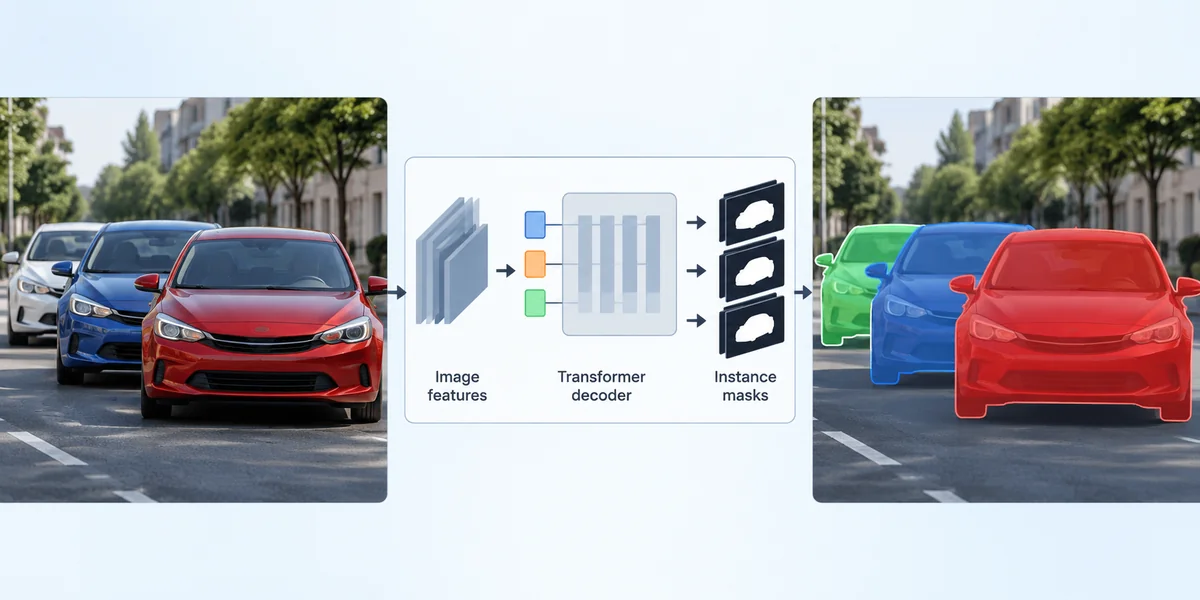
La fortaleza de MaskFormer radica en su arquitectura de clasificación de máscaras, que trata la segmentación como un problema conjunto de predicción de una etiqueta de clase y su máscara binaria asociada. Este enfoque permite al modelo segmentar objetos superpuestos con precisión, sin depender únicamente de cajas delimitantes o etiquetas por píxel.
Componentes Principales:
- Red de Espina Dorsal (CNN): El modelo comienza pasando la imagen de entrada a través de una red de espina dorsal CNN, típicamente una red convolucional preentrenada como ResNet o Swin Transformer. Esta espina dorsal extrae mapas de características ricas, denominados F, que portan información espacial y semántica sobre la imagen.
- Decodificador de Píxeles: A continuación, las características extraídas se alimentan a un decodificador de píxeles, que las convierte en incrustaciones por píxel (E). Estas incrustaciones capturan tanto el contexto local (detalles finos) como global (estructura general) de cada píxel.
- Decodificador Transformer: En paralelo, un decodificador transformer procesa las características de la imagen para generar incrustaciones por segmento (Q). Estas incrustaciones representan las diferentes instancias que el modelo intenta identificar, asignando pesos a varias regiones de la imagen. Este enfoque de dos niveles permite que MaskFormer localice y diferencie entre instancias de objetos, incluso cuando se superponen u ocultan entre sí.
- Predicción de Máscara: Para producir la salida final, MaskFormer calcula el producto punto entre las incrustaciones de píxeles y las incrustaciones de máscara, seguido de una activación sigmoide. Esto resulta en un conjunto de máscaras binarias, una para cada instancia identificada. En casos donde los objetos se superponen, estas máscaras binarias permiten que el modelo aún reconozca y separe cada instancia, haciéndolo ideal para aplicaciones del mundo real.
- Predicción de Clase: Cada segmento se empareja con una etiqueta de clase, permitiendo que el modelo asocie máscaras con categorías específicas de objetos.
La capacidad del modelo para separar instancias está impulsada por su decodificador transformer, que captura dependencias de largo alcance y relaciones espaciales, cruciales para comprender formas y texturas superpuestas.
El Papel de las Máscaras Binarias en el Manejo de Superposiciones
Una de las características destacadas de MaskFormer es su uso de máscaras binarias para definir instancias de objetos. A diferencia de las cajas delimitantes, que ofrecen localización tosca, las máscaras binarias proporcionan precisión a nivel de píxel, haciéndolas ideales para escenarios donde los objetos están estrechamente empaquetados o superpuestos.
En MaskFormer, cada instancia de objeto está representada por una máscara binaria, un mapa donde cada píxel está marcado como perteneciente al objeto (1) o no (0). Cuando múltiples objetos aparecen en el mismo espacio de imagen, estas máscaras pueden superponerse sin conflicto, ya que cada una se genera independientemente a través del mecanismo de atención basado en transformers del modelo. Este método elimina la ambigüedad: incluso si dos objetos se superponen físicamente, MaskFormer aún puede segmentarlos con precisión.
¿Cómo Maneja MaskFormer los Objetos Superpuestos?
Lo que distingue a MaskFormer de modelos anteriores es su mecanismo de atención de máscaras. En lugar de confiar en cajas delimitantes o propuestas de región simples, utiliza incrustaciones aprendidas para aislar instancias de objetos dentro de escenas abarrotadas o superpuestas.
Cuando se detectan objetos superpuestos:
- El decodificador transformer genera incrustaciones de consulta separadas para cada objeto.
- Estas consultas atienden selectivamente a diferentes regiones del mapa de características.
- Incluso si los objetos comparten espacio físico (por ejemplo, dos personas de pie cerca), el modelo puede diferenciarlos usando incrustaciones por segmento distintas.
- Las máscaras finales pueden superponerse en el dominio espacial, pero el modelo asigna etiquetas únicas y máscaras binarias a cada instancia.
Esto resulta en una segmentación precisa de instancias incluso en escenas muy concurridas, lograda a través de una representación espacial aprendida en lugar de reglas codificadas rígidamente o restricciones de caja delimitante.
Ejecutando el Modelo
Ejecutar MaskFormer para la segmentación de instancias es un proceso simplificado, especialmente al usar modelos preentrenados. Aquí tienes una visión general paso a paso de cómo realizar la segmentación en una imagen con objetos superpuestos:
Paso 1: Importación de Librerías Requeridas
Comienza asegurándote de que las librerías necesarias para el procesamiento y segmentación de imágenes estén disponibles en tu entorno. Estas incluyen típicamente módulos de la librería Transformers de Hugging Face, una librería para manejo de imágenes como PIL, y una herramienta para obtener la imagen de una URL web.
Paso 2: Carga del Modelo Preentrenado MaskFormer
A continuación, inicializa el extractor de características, que prepara la imagen (redimensionando, normalizando y convirtiéndola en tensores). Carga el modelo MaskFormer preentrenado que ha sido entrenado en el conjunto de datos COCO. Esta configuración permite que el modelo interprete y procese datos visuales de manera efectiva para la segmentación.
Paso 3: Preparación de la Imagen de Entrada
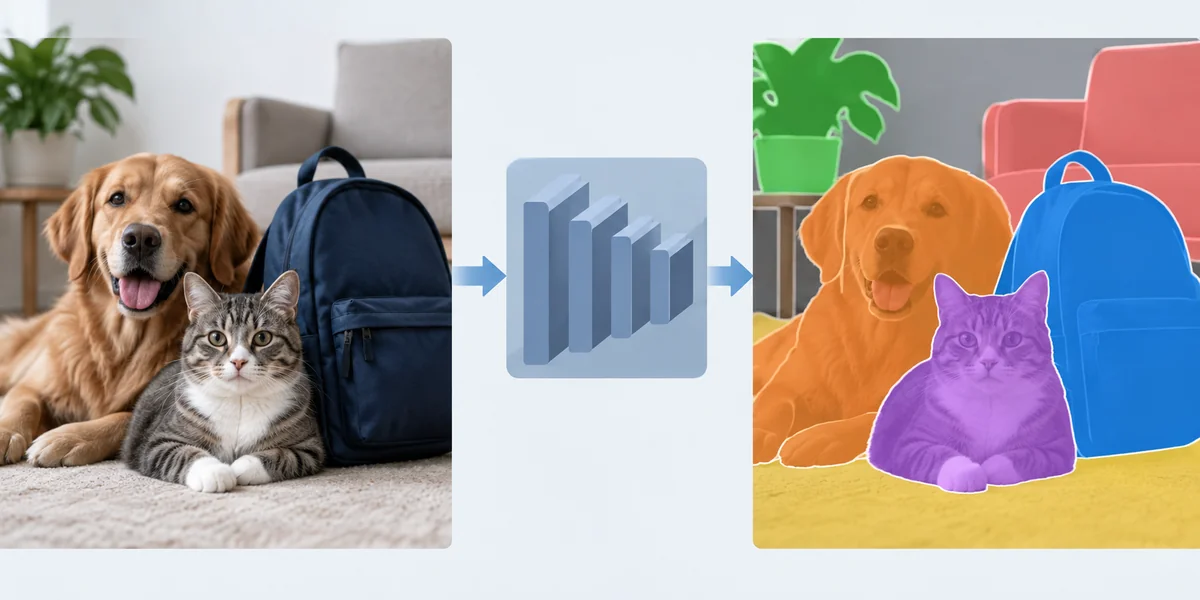
Selecciona la imagen que deseas segmentar. En este caso, se recupera una imagen de una URL y luego se procesa usando el extractor de características. Este paso formatea la imagen correctamente para que el modelo pueda analizarla con precisión.
Paso 4: Ejecución de Inferencia
Una vez que la imagen está lista, se pasa a través del modelo para realizar inferencia. La salida incluye predicciones de clases y máscaras binarias correspondientes, que indican las instancias de objetos detectadas y sus ubicaciones en la imagen, incluso si se superponen.
Paso 5: Post-Procesamiento de la Salida
La salida cruda del modelo se procesa luego para generar un mapa de segmentación. Este mapa identifica qué píxeles pertenecen a qué objeto y asigna a cada píxel una etiqueta basada en la clase de objeto.
Paso 6: Visualización de la Segmentación
Finalmente, los resultados procesados se visualizan. Usando herramientas de visualización, se muestra el mapa de segmentación, mostrando cómo MaskFormer ha diferenciado y etiquetado cada objeto en la imagen, incluso en regiones donde los objetos se superponen.
Conclusión
MaskFormer se erige como una evolución significativa en el dominio de la segmentación de imágenes. Su capacidad para manejar objetos superpuestos, un desafío históricamente difícil, demuestra el poder de combinar arquitecturas basadas en transformers con la clasificación de máscaras. Al evitar predicciones tradicionales por píxel y en su lugar utilizar un mecanismo de atención basado en consultas, MaskFormer puede separar escenas complejas en segmentos de objetos precisos y distintos, incluso cuando esos objetos comparten espacio físico. La arquitectura del modelo soporta tanto la segmentación semántica como de instancias, pero su verdadera fortaleza está en distinguir instancias de objetos sin estar limitado por la superposición de cajas delimitantes o proximidad espacial.
Artículos relacionados
Comprendiendo el Impacto de la IA en la Escritura Creativa
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Impulsando la IA: La Energía Detrás de los Grandes Modelos de Aprendizaje Automático
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
¿Qué son las Redes Generativas Adversarias (GANs)?
Implicaciones Éticas del Contenido Generado por IA en Medios y Arte
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Uso de la IA para Optimizar y Simplificar la Gestión de la Fuerza Laboral Externa
9 Grandes Beneficios de Usar IA en Tu Negocio Minorista
Compra Sin Clics: ¿Es Este el Nuevo Estándar en el Comercio Electrónico?
5 Razones Clave para Usar Soluciones Basadas en IA en tu Departamento de RRHH
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
