
Guía de Enrutamiento LLM: Estrategias, Técnicas e Implementaciones en Python
En esta página
Los modelos de lenguaje grandes (LLMs) como GPT-4, Gemini (anteriormente Bard) y Claude se están integrando cada vez más en diversas aplicaciones. Es evidente que ningún modelo individual sobresale en todas las áreas. Algunos modelos son mejores para proporcionar respuestas precisas, otros destacan en la escritura creativa y algunos son particularmente hábiles en abordar temas morales y sensibles.
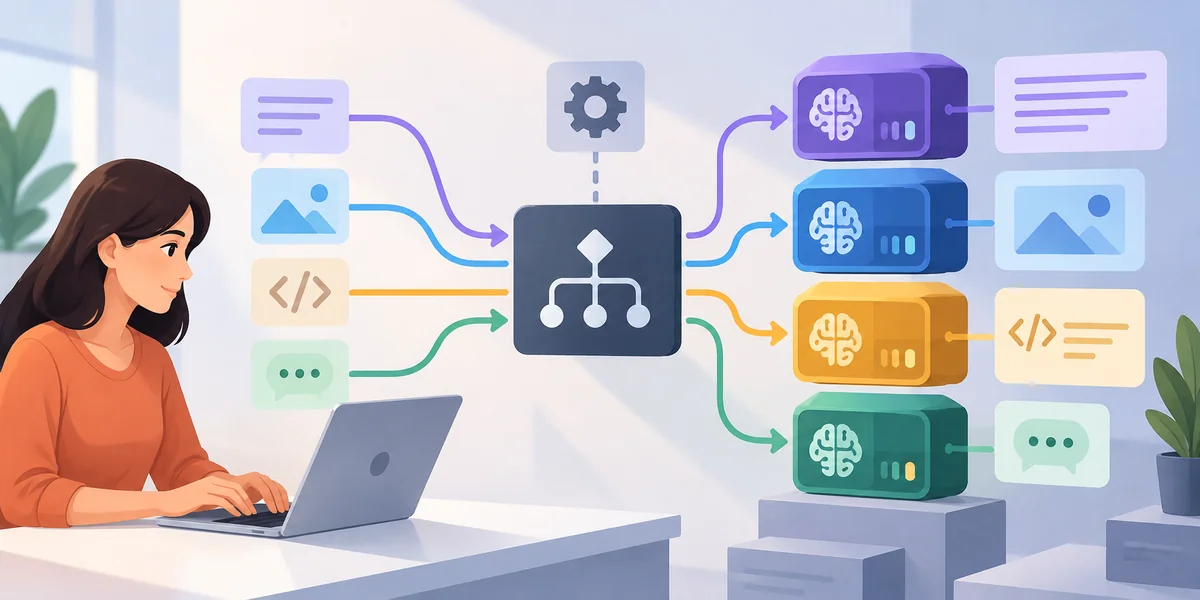
Esta diversidad en las fortalezas de los modelos ha llevado a un enfoque más inteligente: el Enrutamiento LLM. Este método asigna dinámicamente tareas al modelo de lenguaje más adecuado según el tipo de tarea, las condiciones del sistema o el rendimiento del modelo. En este artículo, exploraremos el concepto de enrutamiento LLM, desglosaremos las estrategias clave y revisaremos implementaciones originales en Python de estas estrategias.
¿Qué es el Enrutamiento LLM?
El Enrutamiento LLM implica dirigir estratégicamente diferentes tipos de solicitudes al LLM más apropiado. En lugar de depender de un solo modelo para todas las consultas, un sistema determina cuál es el mejor modelo para una tarea dada, ya sea factual, creativa, técnica o ética.
El enrutamiento mejora:
- La precisión y relevancia de las respuestas
- El rendimiento y el tiempo de respuesta
- La escalabilidad del sistema y la eficiencia de costos
Estrategias de Enrutamiento LLM
Existen varios enfoques para el enrutamiento LLM. Examinemos los principales antes de adentrarnos en la codificación.
1. Enrutamiento Estático (Round-Robin)
Este es el método más simple, donde las tareas se distribuyen en una secuencia rotativa entre los modelos disponibles. Es fácil de implementar, pero no considera la complejidad de la tarea o las capacidades del modelo. Este método funciona bien cuando el volumen de tareas es uniforme y los modelos son igualmente capaces.
2. Enrutamiento Dinámico
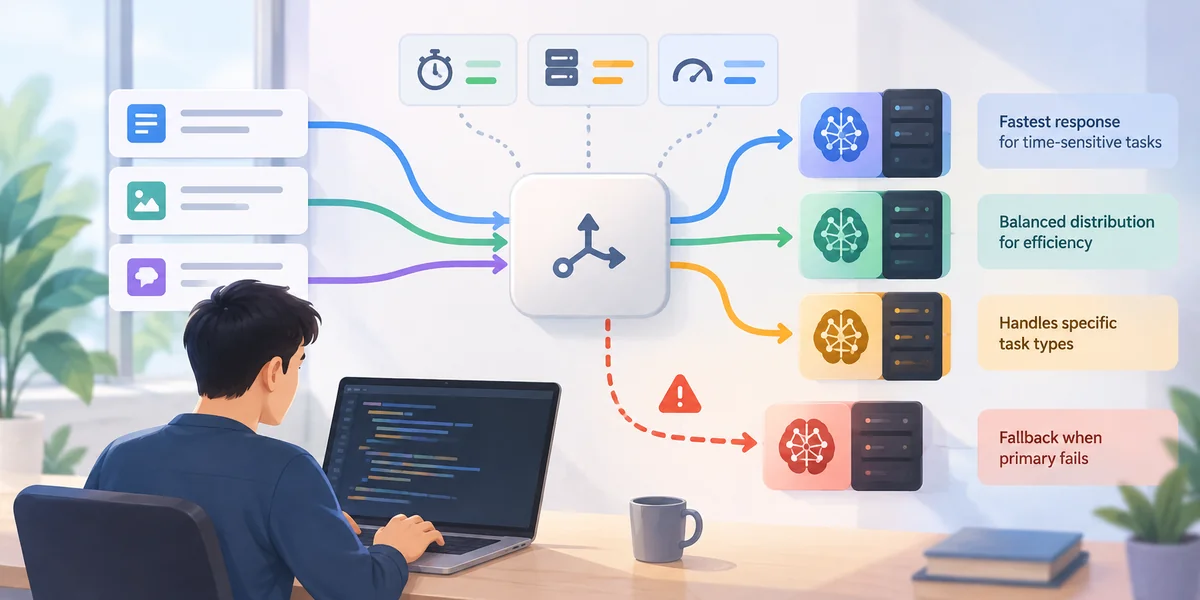
Las decisiones de enrutamiento aquí se basan en condiciones en tiempo real, como la carga actual o la disponibilidad del modelo. Este enfoque ayuda a equilibrar la carga de trabajo y optimizar la velocidad. El enrutamiento dinámico es ideal para sistemas de alto tráfico que necesitan mantener el rendimiento bajo presión. Se adapta automáticamente a los cambios en la carga del sistema, ayudando a evitar cuellos de botella.
3. Enrutamiento Consciente del Modelo
Este enfoque utiliza un perfil de las fortalezas de cada modelo, como creatividad o precisión, para asignar tareas en consecuencia. Ofrece una solución de enrutamiento más inteligente y orientada al rendimiento. Al alinear las tareas con modelos especializados, esta estrategia mejora la calidad del output y la satisfacción del usuario. Requiere datos de rendimiento históricos o benchmarks del modelo para funcionar eficazmente.
4. Hashing Consistente
A menudo usado en sistemas distribuidos, esta estrategia asigna tareas basándose en un valor hash, asegurando un enrutamiento consistente al mismo modelo. Este enfoque minimiza la redistribución de tareas cuando se agregan o eliminan modelos, haciéndolo adecuado para entornos escalables.
5. Enrutamiento Contextual
Esta técnica avanzada utiliza el contenido o los metadatos de la tarea, como el tema o el tono, para decidir qué modelo debería manejarla. A menudo involucra sistemas de clasificación o etiquetado basados en PLN para entender la intención detrás de cada input.
Técnicas de Enrutamiento LLM
Más allá de las estrategias, el enrutamiento LLM efectivo se basa en varias técnicas clave para asegurar decisiones de enrutamiento precisas y eficientes.
1. Clasificación de Tareas
Esto implica identificar la naturaleza de una solicitud (por ejemplo, creativa, técnica, factual) usando reglas de palabras clave o clasificadores de PLN, permitiendo una selección de modelo dirigida.
2. Perfilado de Modelos
Esta técnica involucra calificar los modelos en base a fortalezas como creatividad, precisión y ética para emparejar tareas con el modelo más adecuado.
3. Monitoreo de Latencia
Rastrea el tiempo de respuesta y la carga del modelo para apoyar el enrutamiento dinámico, asegurando que las tareas se envíen al modelo más receptivo en tiempo real.
4. Distribución Ponderada
Asigna pesos a los modelos basándose en su rendimiento o capacidad, asegurando una asignación de tareas equilibrada y rentable.
5. Lógica de Respaldo
Proporciona opciones de modelo de respaldo si el principal falla, mejorando la fiabilidad y manteniendo la calidad del servicio.
Ejemplos de Implementación en Python (Originales y Únicos)
Exploremos cómo implementar cada estrategia en Python usando funciones simuladas para simplicidad. Todo el código aquí es original y diseñado específicamente para este artículo.
1. Enrutamiento Estático (Round-Robin)
language_models = ["GPT-4", "Gemini", "Claude"]

def static_round_robin(tasks):
    index = 0
    total_models = len(language_models)
    for task in tasks:
        current_model = language_models[index % total_models]
        print(f"Tarea: '{task}' se asigna a: {current_model}")
        index += 1
2. Enrutamiento Dinámico (Simulado con Aleatoriedad)
import random

def dynamic_routing(tasks):
    for task in tasks:
        selected_model = random.choice(language_models)
        print(f"Tarea enrutada dinámicamente '{task}' a: {selected_model}")
En un entorno real, basarías la elección en métricas como tiempo de respuesta, longitud de la cola, etc.
3. Enrutamiento Consciente del Modelo (Basado en Fortalezas)
model_capabilities = {
    "GPT-4": {"creatividad": 90, "precisión": 85, "ética": 80},
    "Gemini": {"creatividad": 70, "precisión": 95, "ética": 75},
    "Claude": {"creatividad": 80, "precisión": 80, "ética": 95}
}

def model_aware_routing(tasks, focus_area):
    for task in tasks:
        best_model = max(model_capabilities, key=lambda m: model_capabilities[m][focus_area])
        print(f"Tarea: '{task}' se enruta a: {best_model} basado en {focus_area}")
4. Hashing Consistente
import hashlib

def consistent_hash(text, total_models):
    hash_value = hashlib.md5(text.encode()).hexdigest()
    numeric = int(hash_value, 16)
    return numeric % total_models

def consistent_hash_routing(tasks):
    for task in tasks:
        idx = consistent_hash(task, len(language_models))
        selected_model = language_models[idx]
        print(f"Tarea enrutada consistentemente '{task}' a: {selected_model}")
5. Enrutamiento Contextual (Basado en el Tipo de Tarea)
model_roles = {
    "GPT-4": "técnico",
    "Claude": "creativo",
    "Gemini": "informativo"
}

def classify_task(task):
    if "escribir" in task or "historia" in task:
        return "creativo"
    elif "cómo" in task or "explicar" in task:
        return "técnico"
    else:
        return "informativo"

def contextual_routing(tasks):
    for task in tasks:
        task_type = classify_task(task)
        selected_model = next((model for model, role in model_roles.items() if role == task_type), "Desconocido")
        print(f"Tarea enrutada contextualmente '{task}' a: {selected_model} ({task_type})")
Tabla Comparativa de Estrategias
| Estrategia | Coincidencia de Tareas | Adaptabilidad | Complejidad |
|---|---|---|---|
| Estático (Round-Robin) | No | No | Baja |
| Enrutamiento Dinámico | No | Sí | Media |
| Enrutamiento Consciente del Modelo | Sí | No | Media |
| Hashing Consistente | No | No | Media |
| Enrutamiento Contextual | Sí | Sí | Alta |
Conclusión
A medida que las aplicaciones de IA se expanden en alcance y complejidad, el enrutamiento LLM se está convirtiendo en una necesidad más que en una mejora. Permite a los sistemas escalar inteligentemente, manejar tareas de manera eficiente y proporcionar mejores experiencias de usuario asegurando que el modelo correcto maneje la tarea adecuada.
Con estrategias que van desde el simple round-robin hasta el sofisticado enrutamiento contextual, y respaldadas por implementaciones en Python, ahora tienes una base para comenzar a construir sistemas LLM multi-modelo que sean más inteligentes, rápidos y confiables.
Artículos relacionados
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
Construye tu Primera Extensión de Python para VS Code en 7 Sencillos Pasos
10 Bibliotecas Esenciales de Python que Facilitan el Análisis de Datos
Revisión Exhaustiva de las Herramientas de IA Generativa de Adobe
3 Historias Inspiradoras de Líderes en IA
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
Biblioteca Pandas de Python: Una Guía Completa para el Análisis de Datos
Selenium Python: Una Guía para Automatizar Tareas Web Eficientemente
Cómo la IA está Transformando la Industria Minorista
Explorando las Bases de Datos de Grafos: Componentes, Beneficios y Aplicaciones
¿Qué es una Función Heurística en IA y Por Qué es Importante en la Búsqueda?
Domina el Desarrollo de Chatbots Agénticos con el Kit de Herramientas de AutoGen Studio
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
