
Cómo Configurar y Usar IBM Granite-3.0 para Soluciones Potenciadas por IA
En esta página
El campo de la inteligencia artificial está experimentando una transformación rápida, y los modelos de lenguaje a gran escala (LLMs) están a la vanguardia de esta revolución. A medida que crece la demanda de sistemas de IA confiables y de alto rendimiento, las empresas recurren cada vez más a modelos que ofrecen capacidades de nivel empresarial sin comprometer la seguridad, escalabilidad o transparencia. La serie Granite-3.0 de IBM es una de esas soluciones.
Este artículo explorará el modelo Granite-3.0 de IBM con un enfoque especial en la configuración y el uso práctico. Ya seas desarrollador, científico de datos o ingeniero empresarial, esta guía te ayudará a comenzar con el modelo utilizando un entorno Python. También profundizaremos en la estructuración de solicitudes, el procesamiento de entradas y la extracción de resultados significativos mediante un enfoque basado en código.
Comprendiendo IBM Granite-3.0
Granite-3.0 de IBM es la última versión de sus modelos de base de código abierto diseñados para tareas ajustadas a instrucciones. Estos modelos están construidos para realizar una amplia gama de operaciones de procesamiento de lenguaje natural (NLP) como resumen, respuesta a preguntas, generación de código y comprensión de documentos.
A diferencia de muchos modelos cerrados, Granite-3.0 se publica bajo la licencia Apache 2.0, lo que permite su uso gratuito tanto en investigación como con fines comerciales. IBM enfatiza los principios de IA ética con Granite, incluyendo la divulgación completa de las prácticas de entrenamiento de datos, el desarrollo responsable del modelo y una infraestructura energéticamente eficiente.
Características Clave de Granite-3.0
- Ajustado a Instrucciones: Optimizado para interacciones similares a las humanas mediante solicitudes.
- Escalable: Disponible en diferentes tamaños, incluidos modelos de 2B y 8B parámetros.
- Modelos de Salvaguardia: Variantes diseñadas para filtrar contenido no seguro.
- Soporte Multilingüe: Capaz de funcionar en varios idiomas.
- Preparado para Llamadas a Herramientas: Puede interactuar con APIs y funciones.
Instalación y Configuración
Esta sección te guiará a través de la configuración del modelo Granite-3.0-2B-Instruct desde Hugging Face y su ejecución en un entorno local de Python o en una plataforma en la nube como Google Colab.
Paso 1: Instalar Librerías Requeridas
Comienza instalando todos los paquetes de Python necesarios. Esto incluye la librería transformers de Hugging Face, PyTorch y Accelerate para la optimización de hardware.
!pip install torch accelerate
!pip install git+https://github.com/huggingface/transformers.git
Esta configuración asegura que tu entorno soporte la carga del modelo, la tokenización de texto y el procesamiento de inferencias.
Paso 2: Cargar el Modelo y Tokenizador
Una vez que tu entorno esté listo, carga el modelo Granite-3.0 de IBM y su tokenizador asociado. Estos componentes están disponibles en Hugging Face, lo que facilita el acceso y la fiabilidad. El tokenizador convierte el texto legible por humanos en tokens que el modelo puede entender, mientras que el modelo genera respuestas significativas basadas en esos tokens.
Dependiendo de tu hardware, el modelo puede ejecutarse en una CPU o, para un mejor rendimiento, en una GPU. Una vez que todo esté cargado, el modelo está listo para procesar instrucciones para tareas como resumen, respuesta a preguntas y generación de contenido. Esta configuración te posiciona para usar Granite-3.0 eficazmente en aplicaciones de IA del mundo real.
Consejos y Mejores Prácticas para Desplegar el Modelo
Desplegar Granite-3.0-2B-Instruct eficazmente requiere atención al rendimiento, latencia e integración. Aquí hay algunas mejores prácticas:
- Utiliza Aceleradores: Ejecuta el modelo en GPU o a través de puntos finales optimizados para hardware (como NVIDIA NIM) para obtener la mejor velocidad.
- Aprovecha los Modelos de Salvaguardia para Cumplimiento: Si estás en finanzas, salud u otra industria regulada, utiliza Granite Guardian para implementaciones más seguras.
- Inferencia por Lotes para Eficiencia: Al trabajar con múltiples entradas (por ejemplo, documentos o tickets), agrupa tus consultas para minimizar la sobrecarga computacional.
- Monitorea y Ajusta los Resultados: Aunque preajustado, todavía puedes aplicar ajustes específicos de tarea en los modelos base para mejorar los resultados en casos de uso específicos.
Estas prácticas aseguran que obtengas el máximo valor de tus inversiones en IA mientras mantienes los estándares de rendimiento y gobernanza en toda tu organización.
Interacción con Granite-3.0: Casos de Uso Reales
Ahora que tienes el modelo cargado, exploremos varios ejemplos prácticos para comprender sus capacidades. Estos ejemplos simulan tareas comúnmente realizadas en entornos empresariales y de desarrollo.
Ejemplo 1: Generación de Texto
Esta tarea muestra cómo el modelo puede generar contenido creativo o estructurado basado en una simple solicitud del usuario.
prompt = "Escribe un mensaje breve alentando a los empleados a adoptar herramientas de IA."
inputs = tokenizer(prompt, return_tensors="pt").to(device)
outputs = model.generate(**inputs, max_new_tokens=60)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print("Texto Generado:\n", response)
Este ejemplo se puede adaptar fácilmente para la creación de contenido en comunicaciones internas, publicaciones de blog o chatbots.
Ejemplo 2: Resumir un Párrafo
Usemos el modelo para condensar un pasaje de texto más largo en unos pocos puntos clave.
paragraph = (
"Los modelos de lenguaje a gran escala como Granite-3.0 están cambiando cómo operan las empresas. "
"Proporcionan capacidades para la comprensión del lenguaje natural, la generación de contenido, "
"y la interacción con datos empresariales. El enfoque de IBM en la transparencia y el despliegue seguro "
"hace de este modelo un fuerte candidato para industrias reguladas."
)
prompt = "Resume el siguiente texto:\n" + paragraph
inputs = tokenizer(prompt, return_tensors="pt").to(device)
summary = model.generate(**inputs, max_new_tokens=80)
print("Resumen:\n", tokenizer.decode(summary[0], skip_special_tokens=True))
Esta característica es especialmente útil en industrias legales, de investigación y con mucho contenido donde el resumen ahorra tiempo.
Ejemplo 3: Respuesta a Preguntas
Puedes consultar el modelo para obtener información factual, convirtiéndolo en un asistente útil para sistemas de asistencia o soporte de investigación.
question = "¿Cuáles son algunos beneficios de usar modelos de IA de código abierto?"
inputs = tokenizer(question, return_tensors="pt").to(device)
output = model.generate(**inputs, max_new_tokens=60)
print("Respuesta:\n", tokenizer.decode(output[0], skip_special_tokens=True))
Añadir contexto a la pregunta o enmarcarla dentro de un dominio específico puede mejorar la relevancia de las respuestas.
Ejemplo 4: Generación de Código en Python
Granite-3.0 puede generar lógica de programación, lo cual es útil para equipos de desarrollo que buscan automatizar la escritura de scripts simples.
code_prompt = "Crea una función en Python que calcule la secuencia de Fibonacci hasta n términos."
inputs = tokenizer(code_prompt, return_tensors="pt").to(device)
output = model.generate(**inputs, max_new_tokens=100)
print("Código Generado:\n", tokenizer.decode(output[0], skip_special_tokens=True))
Puedes refinar aún más esto pidiéndole al modelo que incluya docstrings, comentarios o pruebas unitarias.
¿Quién Debería Usar IBM Granite-3.0?
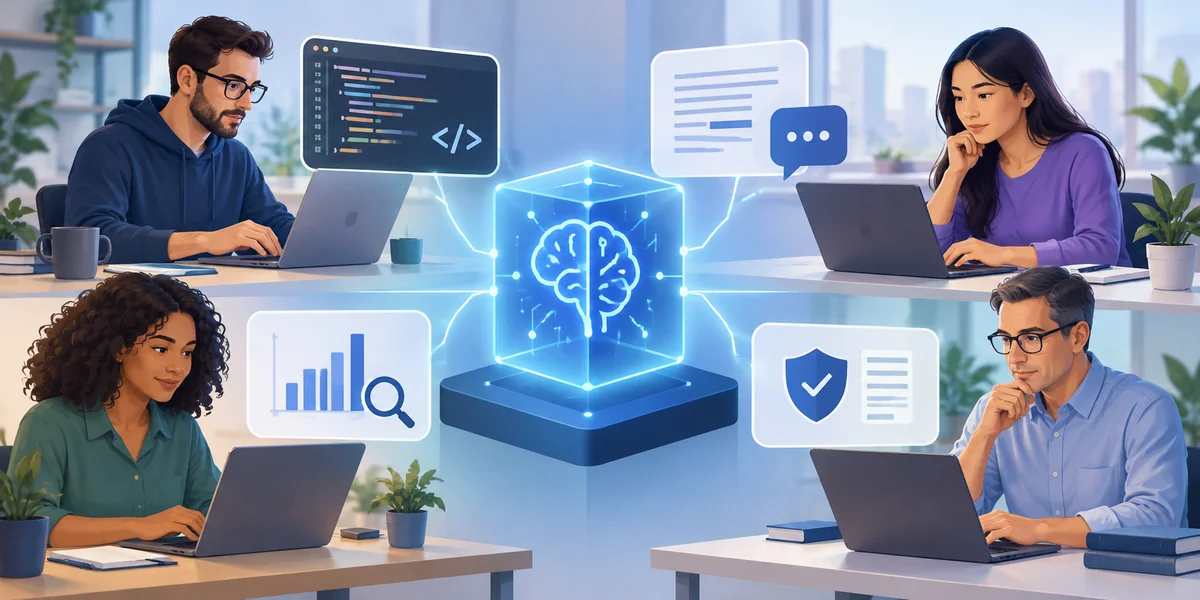
Granite-3.0 no es solo para ingenieros de aprendizaje automático o investigadores de IA; es una herramienta versátil adecuada para múltiples roles en una organización:
- Desarrolladores pueden aprovechar sus capacidades de generación de código y llamada a funciones.
- Científicos de Datos pueden usarlo para tareas de NLP como clasificación, resumen y extracción.
- Analistas de Negocios pueden automatizar ideas y mejorar la toma de decisiones con consultas en lenguaje natural.
- Equipos de Cumplimiento y Riesgo pueden beneficiarse de los mecanismos de seguridad y filtrado de contenido integrados del modelo.
- Equipos de Producto pueden integrar características de IA directamente en sus herramientas usando las opciones de integración en la nube y APIs de Granite.
No importa tu rol, Granite-3.0 reduce la barrera para la IA empresarial y ayuda a los equipos a construir de manera más rápida, inteligente y responsable.
Conclusión
El modelo Granite-3.0-2B-Instruct de IBM ofrece una poderosa combinación de rendimiento, seguridad y escalabilidad adaptada para aplicaciones de nivel empresarial. Su diseño ajustado a instrucciones, arquitectura eficiente y capacidades multilingües lo hacen ideal para tareas que van desde el resumen hasta la generación de código. El modelo es fácil de configurar y usar, incluso en entornos como Google Colab, haciéndolo accesible tanto para desarrolladores como para empresas. Con innovaciones como la decodificación especulativa y el Power Scheduler, IBM ha optimizado tanto el entrenamiento como la inferencia.
Artículos relacionados
Construye tu Primera Extensión de Python para VS Code en 7 Sencillos Pasos
Creando Tuberías Automatizadas de Limpieza de Datos Usando Python y Pandas
10 Bibliotecas Esenciales de Python que Facilitan el Análisis de Datos
Los 5 Agentes de IA Más Poderosos de 2025 para Desarrolladores y Negocios
Biblioteca Pandas de Python: Una Guía Completa para el Análisis de Datos
Selenium Python: Una Guía para Automatizar Tareas Web Eficientemente
Comprendiendo el Papel de los Ajustes de Temperatura en la Salida de IA
25+ Ideas de IA para Escribir Entradas de Blog Más Rápidamente
Una Guía Clara para Acceder a Falcon 3 LLM para Investigación y Aplicaciones
Aprende a Usar PearAI: Una Herramienta Simple y Poderosa para la Automatización del Trabajo
Sora vs Veo 2: ¿Quién Gana la Carrera del Realismo en la Generación de Videos AI?
Desbloqueando Todo el Poder de RAG: Cómo ModernBERT Transforma la Recuperación
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
