
Cómo Funciona el Reconocimiento de Voz: El Viaje de la IA del Sonido a la Comprensión
En esta página
Entender el habla es algo que parece sencillo en una conversación casual, pero es un desafío mucho mayor para las máquinas. El reconocimiento de voz impulsado por IA no solo "escucha", sino que descifra e interpreta palabras habladas, adaptándose a diversos acentos, velocidades, ruidos y estilos de habla. Este proceso impulsa asistentes virtuales, herramientas de transcripción y sistemas controlados por voz.
El viaje del sonido en bruto a la comprensión por parte de la máquina implica pasos complejos que combinan ciencia del sonido, datos profundos y modelos avanzados. Al descomponer estas capas, los sistemas de IA pueden transformar el habla humana en información significativa y procesable de formas que continúan mejorando con el tiempo.
Cómo las Máquinas Descomponen el Habla en Datos
Cuando hablas a un dispositivo, lo primero que ocurre es la conversión de señal. El micrófono captura ondas de sonido analógicas y las convierte en señales digitales, esencialmente, una corriente de números. Este audio digital bruto es la entrada para el proceso de reconocimiento de voz. Pero antes de que se pueda entender algo, el sistema necesita limpiar los datos. Filtra el ruido de fondo, ajusta las inconsistencias de volumen y segmenta la corriente en partes manejables.
A partir de ahí, el proceso pasa a la extracción de características. Imagina darle a la máquina una lupa para acercarse a los patrones en tu voz. Estos patrones no se basan en palabras; incluyen tono, tono y frecuencia. La máquina no "oye" como lo hacen los humanos; observa estas características matemáticamente para determinar qué sonidos pronunciaste.
El reconocimiento de fonemas es el proceso donde la IA identifica las unidades de sonido más pequeñas que distinguen palabras, como la diferencia entre "bat" y "pat". El sistema compara las características extraídas con su base de datos de fonemas. Esto es desafiante porque el inglés tiene alrededor de 44 fonemas, y su pronunciación varía según factores como la región, el trasfondo y la emoción, lo que hace que el reconocimiento preciso sea complicado.
La IA mejora el reconocimiento de voz utilizando modelos estadísticos como Modelos Ocultos de Markov (HMM) o redes neuronales. Estos modelos no dependen solo de coincidencias exactas; predicen posibilidades basadas en el contexto. Por ejemplo, si el sistema escucha "I scream", analiza las palabras circundantes, la estructura de la oración y patrones de uso comunes para determinar si te referías a "ice cream".
El Papel del Procesamiento del Lenguaje Natural (NLP)
Una vez que el sistema identifica los fonemas y los forma en palabras, aún no las entiende. Ahí es donde entra en juego el procesamiento del lenguaje natural. NLP es la rama de la IA responsable de dar sentido al lenguaje humano, no solo de traducirlo de sonido a texto.
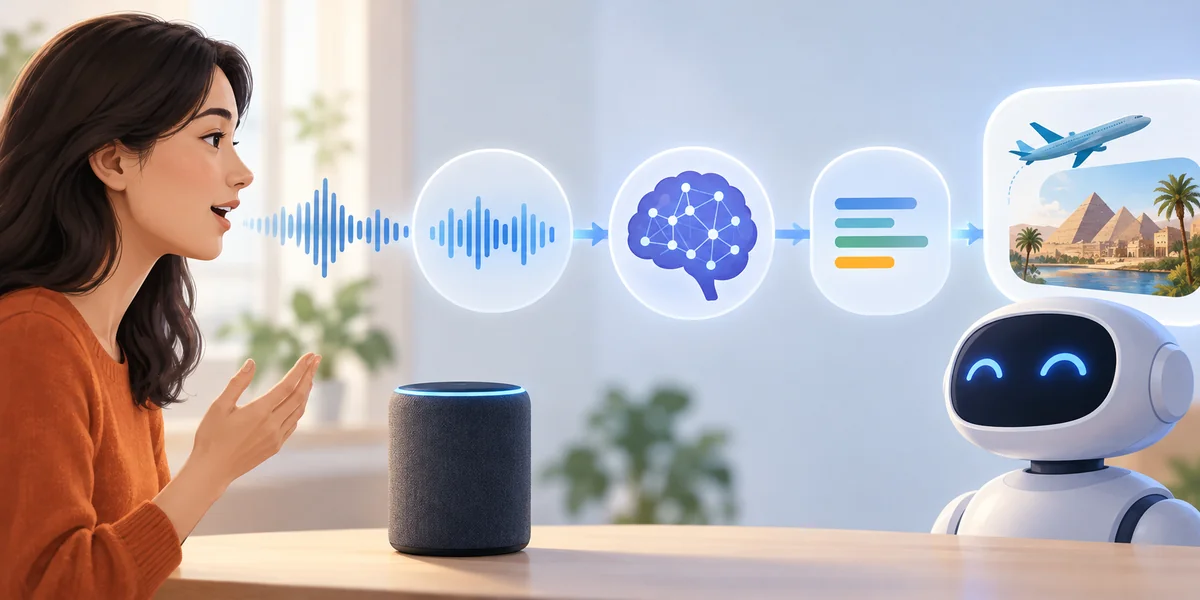
Los algoritmos de NLP analizan las palabras reconocidas en una forma estructurada que las máquinas pueden manejar. Esto implica entender gramática, sintaxis y semántica. Por ejemplo, cuando dices, "Reserva un vuelo a El Cairo", el sistema debe saber que "reserva" es un verbo aquí, no un sustantivo. Debe detectar intención, asignar significado y relacionar la frase con comandos o acciones específicas.
Esta capa de interpretación permite que las herramientas de reconocimiento de voz funcionen en aplicaciones de la vida real. Si el sistema acierta las palabras pero falla en el significado, toda la experiencia se rompe. Por eso los asistentes de voz modernos integran profundamente NLP con el reconocimiento de voz, para que no solo transcriban lo que dijiste, sino que también entiendan lo que quisiste decir.
NLP también permite el aprendizaje continuo. Cuanto más uses un sistema basado en voz, más se adapta a tu estilo de habla, preferencias y vocabulario. Con el tiempo, tu asistente virtual se vuelve más personalizado, no solo en detección de voz sino también en comprensión. Esta adaptabilidad es uno de los beneficios más críticos que la IA trae al reconocimiento de voz.
Desafíos de Acentos, Emociones y Entornos Ruidosos
A pesar de los avances en la tecnología de reconocimiento de voz, persisten varios desafíos. Uno de los mayores obstáculos es la variación de acentos. Por ejemplo, una persona de Texas puede sonar muy diferente a alguien de Mumbai o Londres. Mientras que los humanos a menudo pueden entenderse con paciencia, las máquinas dependen de modelos preentrenados que podrían no estar expuestos a todos los acentos, lo que lleva a errores de reconocimiento. Los desarrolladores de IA abordan esto entrenando modelos en conjuntos de datos diversos, pero los acentos subrepresentados aún luchan con la precisión.
La emoción en el habla también supone un desafío. Una palabra hablada con diferentes emociones, como un "sí" alegre o molesto, puede sonar muy diferente. Dado que las emociones influyen en el tono, la velocidad y el tono, la IA puede tener dificultades con la detección de fonemas. Mientras que los sistemas avanzados incorporan análisis de emociones y computación afectiva, el campo todavía está en desarrollo.
El ruido es otro problema. En entornos ruidosos como calles concurridas o coches, los sistemas de reconocimiento de voz a menudo luchan por aislar la voz del hablante de los sonidos de fondo. Para abordar esto, se utilizan tecnologías como micrófonos de formación de haces y filtros de cancelación de ruido, pero lograr un rendimiento confiable en entornos caóticos sigue siendo un desafío continuo para los sistemas de IA.
Entrenamiento de IA para el Habla: Datos, Modelos y Entrada Humana
Entrenar a la IA para reconocer el habla es un proceso continuo e iterativo que requiere grandes cantidades de datos y refinamiento continuo. Los modelos de IA se alimentan de miles de horas de habla grabada, emparejadas con transcripciones precisas, para exponerlos a una variedad de idiomas, acentos, géneros y grupos de edad. Esto garantiza que el modelo aprenda a manejar patrones de habla diversos.
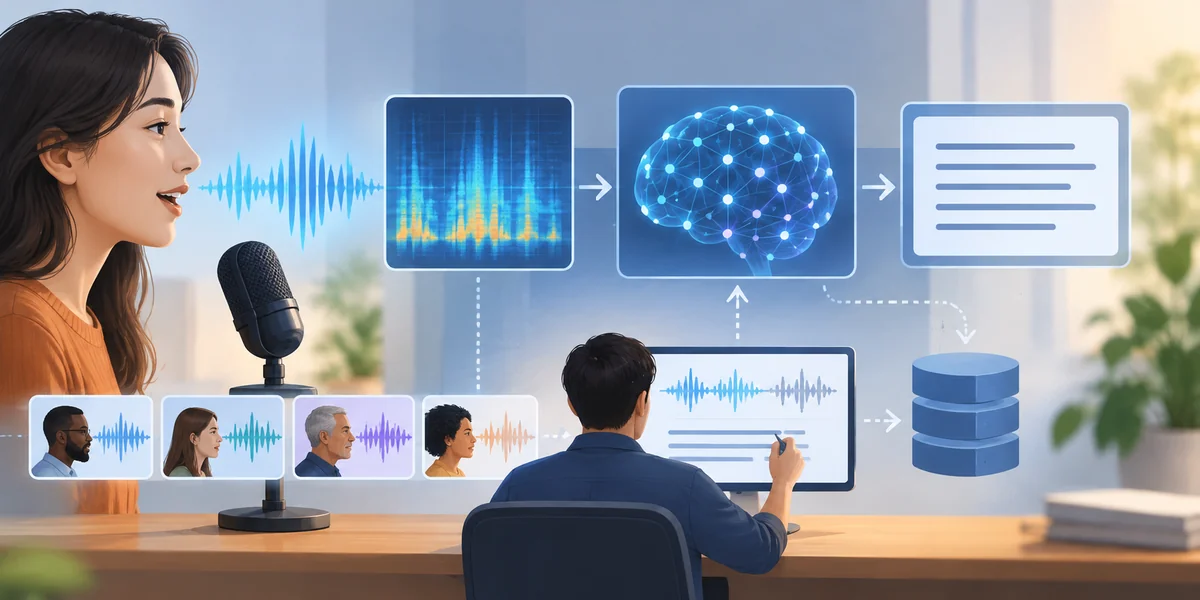
El aprendizaje supervisado es clave, donde los humanos anotan datos de habla, corrigiendo errores y señalando interpretaciones incorrectas. Estos ajustes ayudan a mejorar el modelo con el tiempo. Los modelos de aprendizaje profundo, como las redes neuronales recurrentes (RNN) y los transformadores, son comúnmente utilizados en el reconocimiento de voz moderno. Las RNN sobresalen en la comprensión de secuencias, lo que las hace ideales para procesar el habla, ya que recuerdan el contexto de palabras anteriores. Los transformadores, como los que están detrás de los modelos GPT, pueden analizar largos tramos de texto a la vez, ayudando a entender el habla compleja.
Un avance significativo en los últimos años es el cambio hacia modelos de extremo a extremo. Estos modelos mapean la entrada de audio directamente al texto, omitiendo capas tradicionales, lo que resulta en un reconocimiento más rápido y preciso, especialmente cuando se combina con la computación en la nube y el procesamiento en tiempo real.
A medida que los conjuntos de datos crecen y los modelos evolucionan, la comprensión del habla por parte de la IA continúa mejorando, acercándose cada vez más a lograr, o incluso superar, la comprensión a nivel humano.
Conclusión
El reconocimiento de voz impulsado por IA ha avanzado significativamente en los últimos años, permitiendo a las máquinas entender el habla humana con una precisión cada vez mayor. Al combinar el procesamiento de señales, el procesamiento del lenguaje natural y el aprendizaje profundo, los sistemas de IA pueden interpretar el lenguaje hablado en tiempo real. Aunque desafíos como acentos, ruido y emociones persisten, el progreso continúa. A medida que los modelos de IA evolucionan, la brecha entre el reconocimiento por parte de la máquina y la comprensión humana seguirá cerrándose, haciendo que las tecnologías impulsadas por voz sean más intuitivas y accesibles en la vida cotidiana.
Artículos relacionados
Por qué la Herramienta de Voz a Texto de ChatGPT es un Cambio Revolucionario para la Productividad
El Concepto de Entidades en NLP: Cómo la IA Entiende el Lenguaje
La IA en la Verificación de Identidad: Prevención de Fraude y Seguridad de Datos
Explorando el Potencial Empresarial de los Asistentes de Voz
Comprendiendo las Emociones de los Estudiantes: ¿Puede la IA Reconocer la Frustración?
Cómo el Reconocimiento de Entidades Nombradas (NER) Transforma el Procesamiento de Texto
Herramientas de IA Transformando la Educación Especial para el Aprendizaje Inclusivo
IA para la Acción Climática: Cómo la Tecnología Está Combatiendo los Desafíos Ambientales
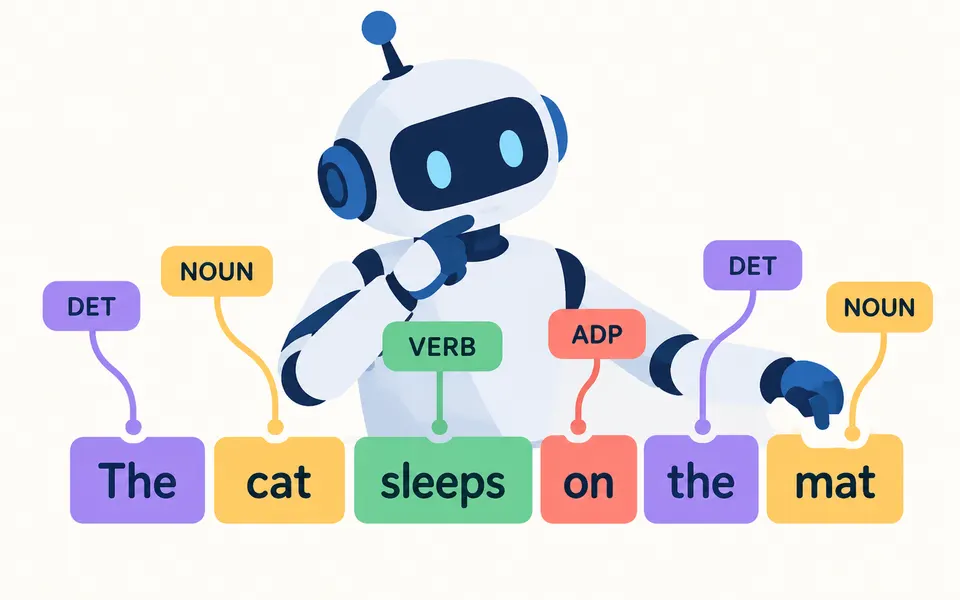
Descifrando el Código: Cómo el Etiquetado de Partes del Discurso Potencia la IA
Revolucionando la IA con OLMoE: Mezcla Abierta de Expertos en Acción
Una Guía para Principiantes sobre Algoritmos de PLN y su Rol en la IA
Términos Clave de la IA Generativa Explicados
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
