
Descifrando el Código: Cómo el Etiquetado de Partes del Discurso Potencia la IA
En esta página
El lenguaje es desordenado, impredecible y está lleno de peculiaridades que lo hacen tanto hermoso como frustrante. Para los humanos, entender las palabras en contexto es natural. ¿Pero para las máquinas? Es un desafío. Ahí es donde entra el Etiquetado de Partes del Discurso: ayuda a la IA a determinar si "run" es un verbo en "I run daily" o un sustantivo en "a home run". Sin esta habilidad, el Procesamiento de Lenguaje Natural estaría irremediablemente perdido en la ambigüedad.
Ya sea impulsando chatbots, motores de búsqueda o correctores gramaticales, el etiquetado sienta las bases para que las máquinas realmente entiendan el lenguaje. Pero, ¿cómo funciona y por qué es importante? Vamos a desglosarlo.
El Mecanismo Central Detrás del Etiquetado de Partes del Discurso
En esencia, el Etiquetado de Partes del Discurso etiqueta las palabras gramaticalmente en una oración según su función. Por ejemplo, una oración como "The cat sleeps on the mat" se etiqueta para identificar "cat" como sustantivo, "sleeps" como verbo, etc. El problema es el contexto, ya que la mayoría de las palabras pueden pertenecer a más de una categoría según el contexto.
Por ejemplo, en "I can swim" y "Pass me the can", el término "can" cambia de un verbo a un sustantivo. Para lidiar con tal vaguedad, los sistemas de etiquetado emplean enfoques basados en reglas y probabilísticos.
Los enfoques basados en reglas dependen de reglas gramaticales definidas manualmente para asignar etiquetas. Aunque efectivos en entornos controlados, tienen dificultades con excepciones y palabras no vistas. Los modelos probabilísticos, como los Modelos Ocultos de Markov (HMMs), predicen la etiqueta de una palabra basándose en la probabilidad y patrones contextuales. Los métodos estadísticos mejoraron considerablemente la precisión, pero necesitaban grandes cantidades de datos etiquetados para funcionar eficazmente.
Con la llegada del Aprendizaje Automático, técnicas de aprendizaje profundo como las Redes Neuronales Recurrentes (RNNs) y Transformadores han transformado el etiquetado. Los modelos de aprendizaje profundo examinan oraciones completas en lugar de palabras individuales, lo que les ayuda a aprender dinámicamente del contexto. Con este avance, el Etiquetado de Partes del Discurso se ha vuelto más eficiente, permitiendo aplicaciones como el reconocimiento de voz, la traducción automática y el análisis de sentimientos con alta precisión.
Desafíos para Lograr un Etiquetado de Partes del Discurso Preciso
A pesar de los avances en el Etiquetado de Partes del Discurso, lograr una alta precisión sigue siendo una tarea compleja debido a la ambigüedad lingüística, las diversas estructuras lingüísticas y los patrones de uso en evolución.
Ambigüedad en el Lenguaje
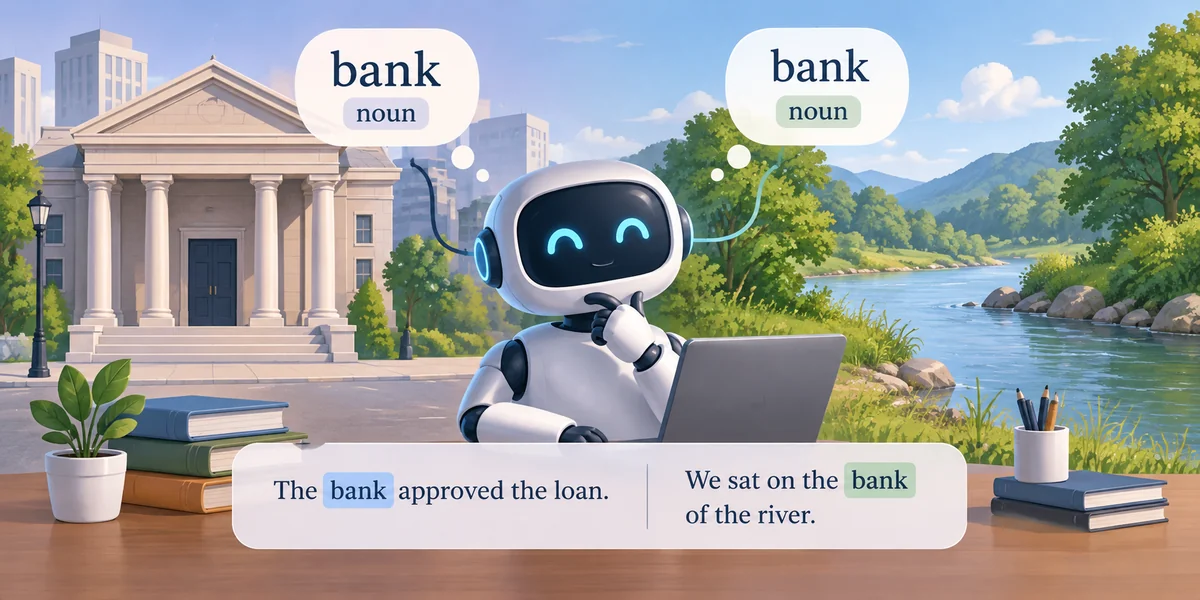
A pesar de los avances en el Etiquetado de Partes del Discurso, la ambigüedad sigue siendo un desafío. Los homónimos, los modismos y las expresiones informales a menudo rompen las reglas gramaticales y confunden a los modelos. Palabras como "bank" (institución financiera o ribera) requieren contexto para un etiquetado correcto. Sin un Análisis Sintáctico profundo, incluso los sistemas sofisticados de NLP luchan por determinar el significado, lo que lleva a clasificaciones erróneas en el procesamiento de texto automatizado y aplicaciones de IA.
Diversidad Lingüística
Muchos modelos de Procesamiento de Lenguaje Natural están entrenados en inglés, lo que limita su efectividad en lenguajes estructuralmente diferentes como el japonés o el árabe. Algunos idiomas dependen de la morfología en lugar del orden de las palabras, requiriendo sistemas de etiquetado adaptativos. Sin conjuntos de datos multilingües, el Etiquetado de Partes del Discurso lucha por generalizar, reduciendo la precisión y haciendo que el NLP sea menos efectivo para aplicaciones globales, especialmente en comunidades lingüísticas subrepresentadas.
Desafíos Contextuales en el Análisis Sintáctico
El contexto juega un papel crucial en el Análisis Sintáctico, lo que dificulta que los modelos diferencien significados. Considera “Time flies like an arrow” — “flies” podría ser un sustantivo o un verbo. Sin modelos de Lingüística Computacional que analicen la estructura de la oración de manera holística, los etiquetadores a menudo malinterpretan frases, llevando a un etiquetado de partes del discurso inexacto y errores en aplicaciones posteriores como la traducción o el análisis de sentimientos.
Escasez de Datos y Palabras Desconocidas
Los modelos de IA enfrentan dificultades con la escasez de datos, encontrándose con palabras desconocidas en aplicaciones del mundo real. Las palabras raras, la jerga y las tendencias lingüísticas en evolución obstaculizan la precisión. Cuando los modelos carecen de datos de entrenamiento, se basan en generalizaciones, lo que lleva a un etiquetado incorrecto de las partes del discurso. Los investigadores están refinando los algoritmos de aprendizaje automático para manejar mejor las palabras desconocidas, asegurando al mismo tiempo la eficiencia computacional y la adaptabilidad en contextos lingüísticos diversos.
Aplicaciones en el Mundo Real y el Futuro del Etiquetado de Partes del Discurso
A pesar de sus desafíos, el Etiquetado de Partes del Discurso juega un papel fundamental en los sistemas modernos de Procesamiento de Lenguaje Natural. Sirve como base para la traducción automática, los asistentes de voz y las herramientas de análisis de sentimientos. Sin él, aplicaciones impulsadas por IA como los chatbots, los motores de búsqueda y los correctores gramaticales lucharían por producir respuestas coherentes y conscientes del contexto.
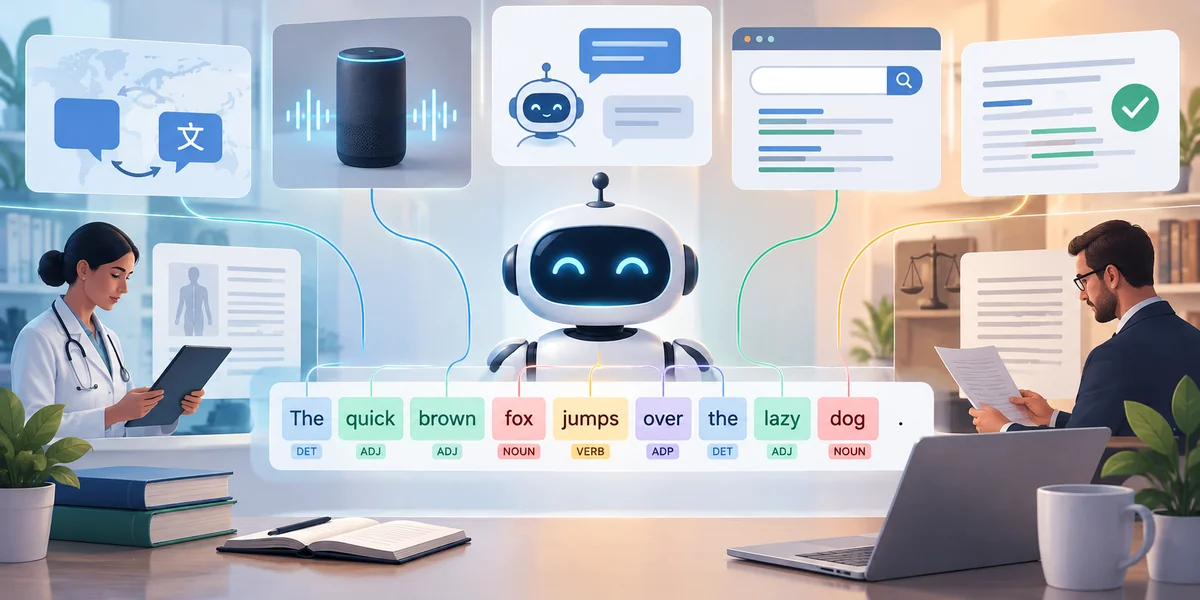
En las industrias médica y legal, donde la precisión en el lenguaje es primordial, el etiquetado ayuda en la clasificación de documentos y la resumación automatizada. Al entender la estructura de contratos legales o informes médicos, la IA puede ayudar a los profesionales a procesar grandes cantidades de texto de manera eficiente.
Mirando hacia el futuro, el futuro del Etiquetado de Partes del Discurso probablemente esté moldeado por modelos de IA cada vez más sofisticados. Con los avances en el aprendizaje profundo, modelos como GPT y BERT continúan refinando su capacidad para manejar estructuras de oraciones complejas. La integración de transformadores permite que la IA contextualice palabras con una precisión sin precedentes, minimizando los errores causados por la ambigüedad.
Además, el impulso por el NLP multilingüe significa que los sistemas de etiquetado serán más adaptables en diferentes idiomas. Los investigadores están desarrollando activamente modelos que puedan aprender de lenguajes con pocos recursos, asegurando que la Lingüística Computacional beneficie a una audiencia global en lugar de estar limitada a lenguajes dominantes como el inglés.
La expansión del Etiquetado de Partes del Discurso más allá del texto hacia el procesamiento de voz y video está dando forma al futuro de la IA. Las herramientas de transcripción y generación de subtítulos ya utilizan el etiquetado para mejorar la precisión. A medida que la IA multimodal avanza, el etiquetado jugará un papel crucial en la interpretación del lenguaje hablado, acercando a las máquinas a una comprensión casi humana y una comprensión contextual.
Conclusión
El Etiquetado de Partes del Discurso es fundamental para el Procesamiento de Lenguaje Natural, permitiendo que las máquinas analicen texto con precisión estructural y contextual. Categorizar palabras según sus roles potencia aplicaciones esenciales como motores de búsqueda, chatbots y análisis de sentimientos. Persisten desafíos como la ambigüedad y la diversidad lingüística, pero los avances en Lingüística Computacional y aprendizaje profundo continúan mejorando la precisión del etiquetado. El futuro apunta hacia la adaptación multilingüe y la integración en el procesamiento de voz y video, haciendo que la IA sea más versátil. A medida que la tecnología evoluciona, el Etiquetado de Partes del Discurso seguirá siendo un pilar de la IA basada en el lenguaje, asegurando que las máquinas interpreten la comunicación humana con mayor precisión y conciencia contextual.
Artículos relacionados
Una Guía para Principiantes sobre Algoritmos de PLN y su Rol en la IA
Stemming vs. Lematización: Eligiendo el Enfoque Correcto de PLN
NLP y Desarrollo de Chatbots Reavivan el Comercio Conversacional AI
Los Chatbots Conversacionales Pueden Revolucionar Tu Proceso de Ventas, Aquí Te Contamos Cómo
Una Introducción al PLN: Cómo las Máquinas Entienden el Lenguaje
Comprendiendo el Impacto de la IA en la Escritura Creativa
¿Qué son las Redes Generativas Adversarias (GANs)?
10 Conceptos Críticos de IA Explicados en 5 Minutos
Explorando el Aprendizaje Supervisado: Conceptos Clave y Aplicaciones
Términos Clave de la IA Generativa Explicados
Impulsando la IA: La Energía Detrás de los Grandes Modelos de Aprendizaje Automático
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
