
Cómo Funciona Hadoop: La Clave para Manejar Conjuntos de Datos Masivos
En esta página
Los datos son el nuevo petróleo que alimenta negocios, gobiernos e innovaciones en todo el mundo. Sin embargo, manejar grandes cantidades de datos no es tan simple como almacenar archivos en una computadora. Las bases de datos tradicionales luchan con el volumen, la velocidad y la complejidad. Ahí es donde entra Hadoop, un marco revolucionario diseñado para almacenar, procesar y analizar conjuntos de datos enormes de manera eficiente.
Diseñado para la escalabilidad, Hadoop distribuye datos en muchas máquinas, haciéndolo rápido y confiable. Ya sea análisis de redes sociales, transacciones financieras o datos médicos, Hadoop impulsa industrias que dependen del big data. ¿Pero qué lo hace tan poderoso? Vamos a desmitificar cómo Hadoop convierte datos en bruto en valiosos conocimientos.
Los Componentes Principales de Hadoop
Fundamentalmente, Hadoop se compone de dos componentes fundamentales: el Sistema de Archivos Distribuidos de Hadoop (HDFS) y MapReduce.
Sistema de Archivos Distribuidos de Hadoop (HDFS)
HDFS es la capa de almacenamiento del sistema. Su objetivo es almacenar volúmenes enormes de datos en múltiples servidores, llamados nodos, de una manera que haga que los datos sean tolerantes a fallos y accesibles. Cuando se guardan datos en HDFS, se dividen en piezas (bloques) y se replican en varias máquinas. Esto garantiza que, incluso si se pierde uno de los nodos, los datos aún sean recuperables debido a la existencia de réplicas de cada bloque en otros nodos.
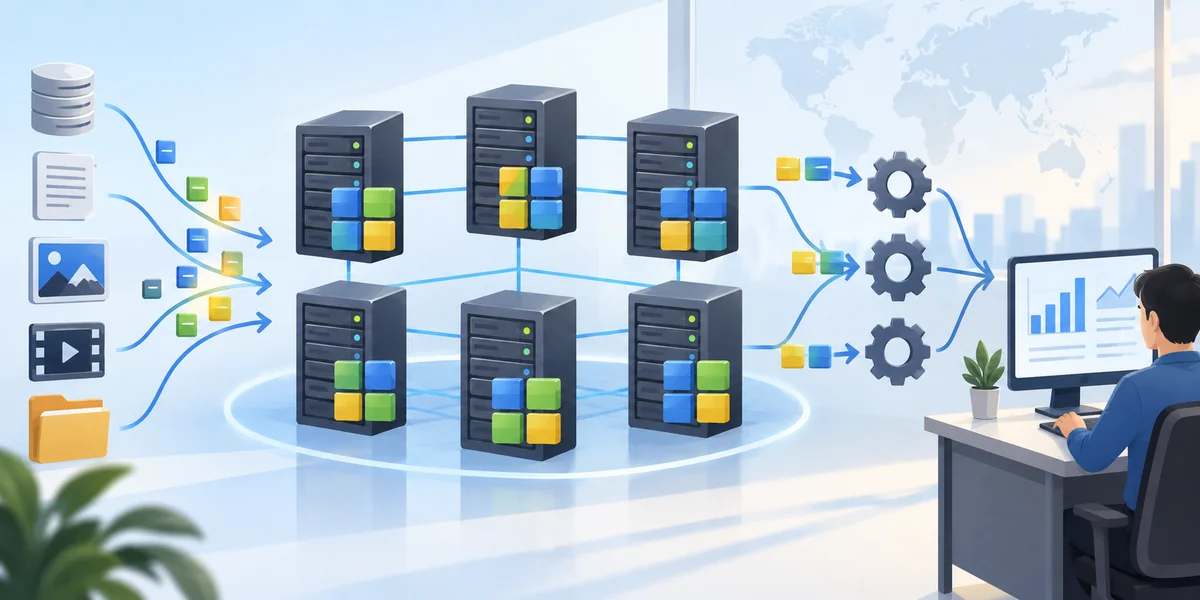
Esto hace que HDFS sea una opción ideal para el almacenamiento de big data. Ya sea datos estructurados, como transacciones de clientes, o datos no estructurados, como videos, HDFS puede manejarlos con facilidad. Distribuir datos en varias máquinas previene cuellos de botella en el procesamiento y recuperación, lo cual es particularmente importante al manejar grandes conjuntos de datos.
MapReduce
MapReduce es la capa de computación de Hadoop. Es un modelo de programación para procesar datos en paralelo en clústeres de máquinas dividiendo el trabajo en partes más pequeñas y procesando cada una de ellas. La fase "Map" descompone los datos en pares clave-valor, opera sobre ellos y distribuye el esfuerzo. La fase "Reduce" reúne los resultados, opera más sobre ellos y produce el resultado final.
Lo que hace tan poderoso a MapReduce es que puede manejar enormes cantidades de datos a velocidades asombrosas. Su paralelismo asegura que, en lugar de procesar datos secuencialmente en una sola máquina, el trabajo se divide entre numerosas máquinas, acelerando considerablemente el proceso.
Escalabilidad de Hadoop
Una de las razones principales por las que Hadoop se ha vuelto tan popular es su escalabilidad. A diferencia de los sistemas de almacenamiento de datos tradicionales que requieren grandes inversiones en infraestructura física, Hadoop está diseñado para trabajar en hardware común. Esto significa que cualquiera puede comenzar con un pequeño clúster de máquinas y, a medida que sus datos crecen, simplemente agregar más máquinas para escalar el sistema horizontalmente.
Esta escalabilidad es crucial para las empresas, especialmente a medida que acumulan más datos con el tiempo. Con Hadoop, no es necesario una gran inversión inicial en dispositivos de almacenamiento de alta gama. En su lugar, puede comenzar pequeño y crecer según sea necesario, lo que lo convierte en una solución asequible para organizaciones de todos los tamaños.
Ecosistema de Hadoop
Si bien los dos componentes principales de Hadoop—HDFS y MapReduce—proporcionan la funcionalidad básica, el ecosistema alrededor de Hadoop es lo que realmente lo hace versátil y poderoso. Con el tiempo, se ha construido una amplia gama de proyectos y herramientas alrededor de Hadoop para extender sus capacidades. Algunas de las herramientas más populares en el ecosistema Hadoop incluyen:
Hive: Un sistema de almacén de datos construido sobre Hadoop que le permite consultar datos usando una sintaxis similar a SQL, lo que facilita a aquellos familiarizados con bases de datos tradicionales interactuar con big data.
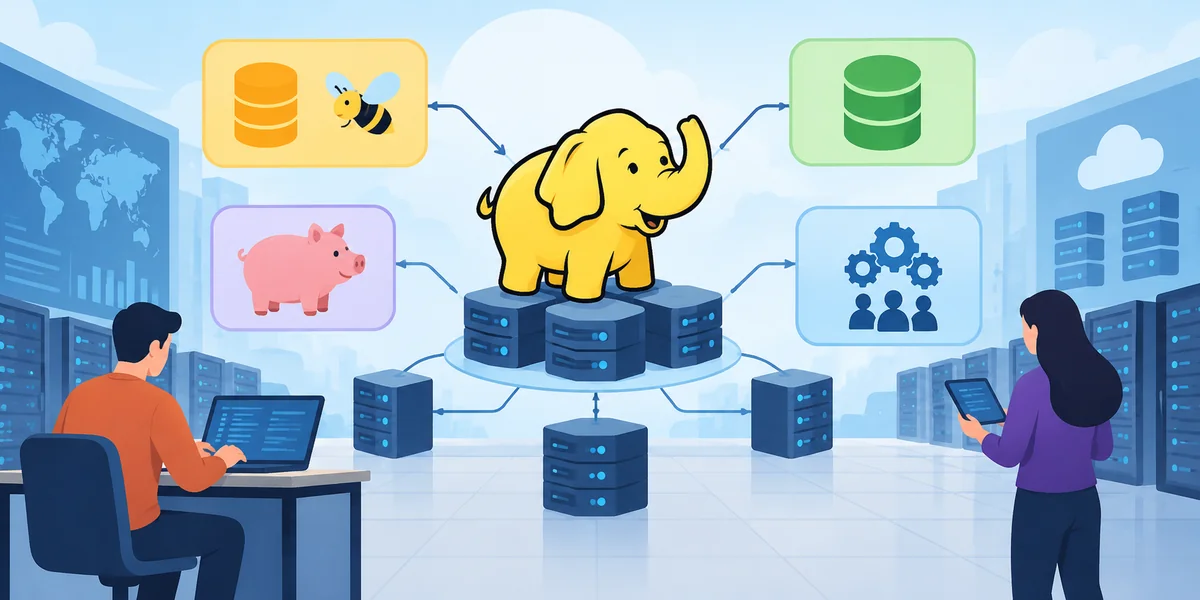
Pig: Una plataforma de alto nivel para crear programas MapReduce que simplifican la codificación mediante el uso de un lenguaje llamado Pig Latin, que es más fácil de escribir y entender que el código MapReduce en bruto.
HBase: Una base de datos no relacional construida sobre HDFS, que ofrece acceso en tiempo real a grandes conjuntos de datos. HBase está diseñado para acceso aleatorio de lectura y escritura, a diferencia de HDFS, que está optimizado para el procesamiento por lotes.
YARN (Yet Another Resource Negotiator): Una capa de gestión de recursos que permite a múltiples aplicaciones compartir un clúster de Hadoop de manera eficiente gestionando recursos y programando trabajos.
Sqoop: Una herramienta diseñada para transferir datos entre Hadoop y bases de datos relacionales. Simplifica el proceso de importar datos desde bases de datos SQL a HDFS y exportarlos de vuelta.
Juntas, estas herramientas proporcionan un ecosistema completo que mejora las capacidades de Hadoop, convirtiéndolo en una herramienta aún más poderosa para el procesamiento de big data.
Impacto de Hadoop en el Big Data
Big data es un término general para datos que son demasiado grandes, rápidos o complejos para que las herramientas tradicionales de procesamiento de datos puedan manejarlos. La explosión de datos de fuentes como redes sociales, sensores y transacciones en línea ha superado los límites de las bases de datos convencionales. Hadoop juega un papel crucial en el mundo del big data al hacer posible almacenar y procesar vastas cantidades de datos en tiempo real, algo que antes era inimaginable.
Uno de los principales desafíos en big data no es solo su tamaño, sino también su variedad y velocidad. A diferencia de los datos estructurados que pueden almacenarse ordenadamente en una base de datos relacional, el big data a menudo viene en diversas formas, como texto, imágenes, videos o archivos de registro. La flexibilidad de Hadoop para manejar tanto datos estructurados como no estructurados es un cambio de juego para las organizaciones. Ya sea analizando tendencias en redes sociales, procesando datos de sensores de dispositivos inteligentes o revisando transacciones de clientes, Hadoop es la columna vertebral para manejar estos datos.
Además, la capacidad de Hadoop para procesar datos en paralelo reduce el tiempo requerido para analizar grandes conjuntos de datos. Las empresas ahora pueden extraer conocimientos valiosos de sus datos mucho más rápido, lo que permite una toma de decisiones más rápida. Esto ha llevado a una mejor inteligencia empresarial, análisis predictivo y operaciones más eficientes en muchas industrias, incluidas la salud, las finanzas y el comercio minorista.
Conclusión
En un mundo donde los datos crecen a un ritmo imparable, Hadoop se erige como una solución vital para gestionar y procesar conjuntos de datos masivos. Su arquitectura distribuida, escalabilidad y capacidad para manejar diversos tipos de datos lo hacen indispensable para aplicaciones de big data. Al aprovechar Hadoop, las empresas pueden almacenar, analizar y extraer eficientemente valiosos conocimientos de sus datos. A medida que la toma de decisiones basada en datos se vuelve más crucial, el papel de Hadoop solo se ampliará, moldeando el futuro del análisis, la inteligencia empresarial y el procesamiento de datos a gran escala.
Artículos relacionados
Gestión de la Privacidad de Datos con IA en la Creciente Era del Big Data
Desbloqueando el Poder de la Arquitectura Lambda para Sistemas de Datos Escalables
Desglose para Principiantes: Datos Discretos vs. Continuos
Análisis Predictivo Potenciado por IA para Pronóstico de Demanda Energética
El Impacto de los Datos Masivos en la Inteligencia Artificial y su Rol
Psicografía: Aprende a Dirigir Contenidos con Precisión Láser Usando IA
Por Qué No Tienes Tantos Datos Como Crees. Y 3 Formas de Solucionarlo
Guía de Gráficos de Power BI: Los 10 Visuales que Debes Comprender

Desempaquetando Hadoop vs. Spark: Perspectivas sobre el Procesamiento de Datos
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
