
Cómo y por qué crear datos sintéticos con IA generativa
En esta página
En la era digital actual, la inteligencia artificial (IA) y el aprendizaje automático dependen en gran medida de los datos como su columna vertebral. Sin embargo, adquirir conjuntos de datos de alta calidad que sean diversos y libres de sesgos presenta desafíos significativos debido a restricciones de privacidad, acceso limitado y altos costos de adquisición. Este artículo se adentra en la generación de datos sintéticos a través de sistemas de IA generativa, explorando sus funcionalidades, aplicaciones industriales y beneficios clave.
¿Qué Son los Datos Sintéticos?
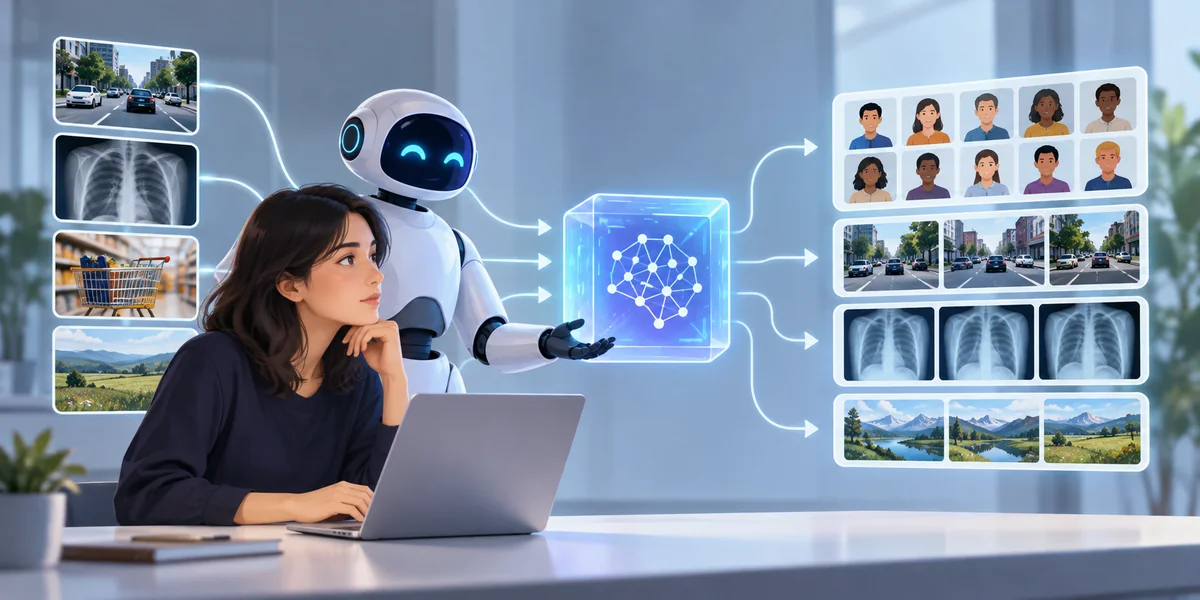 Los datos sintéticos se refieren a conjuntos de datos creados artificialmente que replican las distribuciones estadísticas de datos reales, pero no contienen ninguna información personal. Estos conjuntos de datos se generan a través de algoritmos como las Redes Generativas Antagónicas (GANs) y los Autoencoders Variacionales (VAEs), en lugar de métodos tradicionales de recopilación de datos. El uso de datos sintéticos ha aumentado en los últimos años, abordando varios problemas críticos:
Abordando la Escasez de Datos
Los datos sintéticos juegan un papel crucial en campos donde los datos son escasos, como en dominios especializados de la salud y las finanzas. También ayudan a reducir el sesgo en los conjuntos de datos de entrenamiento de aprendizaje automático. Gartner predice que para 2030, los datos sintéticos superarán a los datos del mundo real para el entrenamiento de modelos de IA (fuente: Gartner).
¿Por Qué Crear Datos Sintéticos con IA Generativa?
La creciente adopción de datos sintéticos se atribuye a sus numerosas ventajas:
1. Protección de la Privacidad
Los datos sintéticos ofrecen una protección robusta de la privacidad al eliminar la Información Personalmente Identificable (PII), asegurando el cumplimiento de regulaciones como el GDPR y el HIPAA. Por ejemplo:
- En salud, los registros de pacientes sintéticos facilitan la investigación sin comprometer información médica sensible.
- En finanzas, las empresas pueden imitar patrones de transacciones manteniendo los datos de los clientes anónimos.
2. Resolución de la Escasez de Datos
Muchas industrias luchan por adquirir conjuntos de datos adecuados para entrenar modelos de aprendizaje automático. Los datos sintéticos pueden adaptarse a las necesidades industriales específicas. Por ejemplo:
- Las empresas de vehículos autónomos utilizan simulaciones para crear millones de escenarios de conducción virtual.
- Los minoristas desarrollan conjuntos de datos para sistemas de recomendación utilizando datos de interacción del cliente.
3. Reducción de Sesgos
Los conjuntos de datos del mundo real a menudo contienen sesgos que conducen a un comportamiento discriminatorio de la IA. Los datos sintéticos ayudan a equilibrar los conjuntos de datos generando categorías de datos raras o escenarios simulados. Por ejemplo:
- Las imágenes sintéticas en sistemas de reconocimiento facial aseguran una representación equitativa a través de diferentes etnias y géneros.
4. Eficiencia de Costos
La recopilación de datos del mundo real es costosa y consume mucho tiempo. La generación de datos sintéticos reduce significativamente los costos mediante la creación automatizada de conjuntos de datos.
5. Aceleración del Desarrollo
Los datos sintéticos aceleran los ciclos de desarrollo al proporcionar conjuntos de datos bajo demanda para pruebas, eliminando la espera de la recopilación de datos del mundo real.
¿Cómo Se Crean Datos Sintéticos Usando IA Generativa?
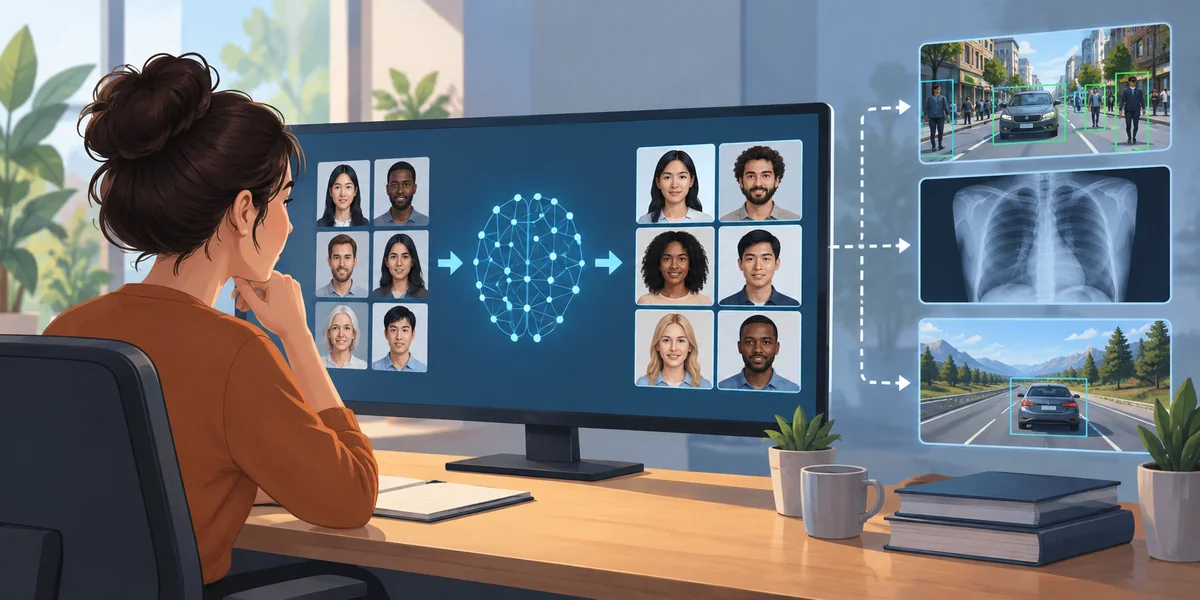 1. Redes Generativas Antagónicas (GANs)
Las GANs consisten en dos redes neuronales: el generador y el discriminador. El generador crea muestras sintéticas, mientras que el discriminador evalúa su autenticidad frente a los datos reales, mejorando continuamente la salida del generador.
- Usadas en aplicaciones como visión por computadora y simulaciones de realidad virtual.
2. Autoencoders Variacionales (VAEs)
Los VAEs comprimen los datos en un espacio latente antes de decodificarlos en nuevas muestras sintéticas. A diferencia de las GANs, los VAEs se basan en el modelado probabilístico.
- Aplicaciones incluyen la generación de conjuntos de datos de imágenes médicas y el diseño de productos variados.
3. Modelos Basados en Transformadores
Los modelos basados en transformadores, incluidos los grandes modelos de lenguaje como GPT, generan datos de texto sintéticos al analizar extensas colecciones de texto para extraer patrones lingüísticos.
- Las aplicaciones van desde la creación de textos de evaluación de clientes hasta la generación de documentos legales y financieros.
4. Modelado Basado en Agentes
Este método utiliza agentes computacionales para simular interacciones dentro de entornos controlados, modelando estructuras de comportamiento complejas.
- Usado en estudios epidemiológicos para modelar la propagación de enfermedades.
Aplicaciones de Datos Sintéticos en Diversas Industrias
Los datos sintéticos están transformando varias industrias:
1. Salud
Los datos sintéticos permiten el desarrollo de modelos médicos sin violar el HIPAA. Por ejemplo:
- La imagenología por resonancia magnética sintética ayuda en el diagnóstico de condiciones raras.
- La investigación farmacéutica se beneficia de simulaciones de interacción de medicamentos.
2. Finanzas
Las instituciones financieras utilizan datos de transacciones sintéticas para probar algoritmos de detección de fraudes mientras cumplen con las regulaciones de privacidad. Ejemplos incluyen:
- Simulación de pagos con tarjeta de crédito para análisis de fraude.
- Creación de perfiles de clientes personalizados para mejorar soluciones bancarias.
3. Vehículos Autónomos
Las empresas de automóviles autónomos utilizan escenarios de conducción sintéticos para mejorar las capacidades de percepción en diversas condiciones climáticas y de tráfico.
4. Comercio Minorista
Los minoristas utilizan datos de interacción del cliente sintéticos para optimizar sistemas de recomendación y gestión de inventarios.
5. Ciberseguridad
Los patrones de tráfico de red sintéticos ayudan a los equipos de ciberseguridad en la prueba de sistemas de detección de intrusiones mientras mantienen la información operativa segura.
Desafíos en el Uso de Datos Sintéticos
A pesar de sus ventajas, los datos sintéticos presentan ciertos desafíos:
- Garantizar la garantía de calidad para reflejar con precisión escenarios del mundo real puede ser complejo.
- Las consideraciones éticas son necesarias para prevenir el uso indebido, como los deepfakes.
- Las GANs requieren extensos recursos computacionales para un entrenamiento efectivo.
Superar estos desafíos requiere estándares de validación robustos, regulaciones éticas e inversión en infraestructura computacional.
Conclusión
Los modelos de IA generativa como GANs, VAEs y sistemas basados en transformadores están destinados a desempeñar un papel cada vez más fundamental en la generación de datos sintéticos. Las organizaciones deben integrar estas herramientas en sus estrategias de IA, ya que son esenciales para mantener una ventaja competitiva.
Dominar la creación de datos sintéticos a través de IA generativa no solo fomenta la innovación, sino que también asegura estándares éticos en el desarrollo de tecnologías como vehículos autónomos y motores de recomendación.
Artículos relacionados
¿Qué son las Redes Generativas Adversarias (GANs)?
GANs vs. VAEs: ¿Cuál es el Mejor Enfoque de IA Generativa?
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Redes Generativas Antagónicas Condicionales: La Revolución de la IA en la Síntesis de Datos
El Poder de la IA Generativa: Definición, Usos e Impacto Global
El Poder de las Redes Generativas Adversariales (GAN): Un Análisis Profundo

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
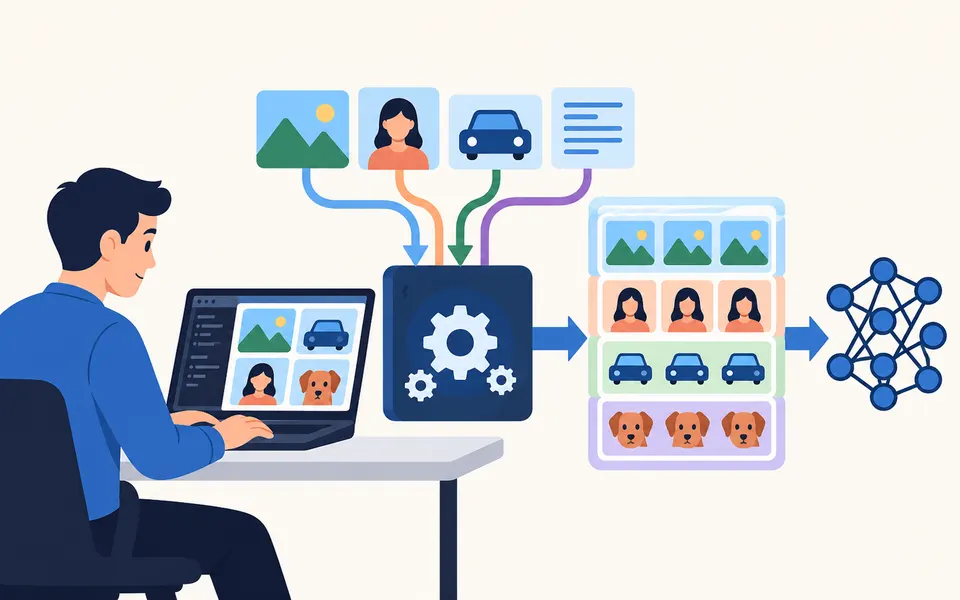
Cómo Crear Datos Sintéticos para Entrenar Algoritmos de Aprendizaje Profundo
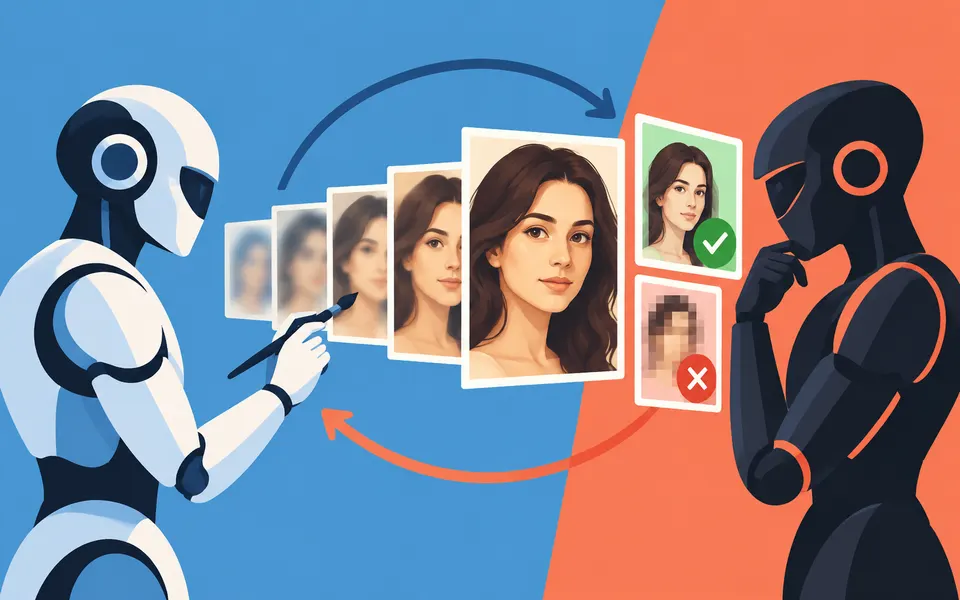
Cómo las Redes Generativas Adversarias Están Revolucionando la IA
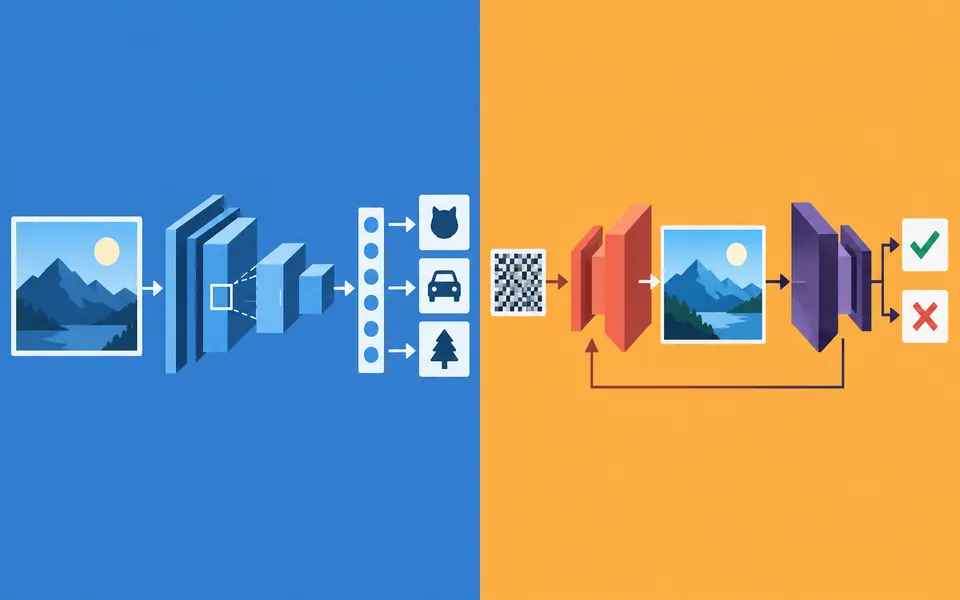
CNN vs. GAN: ¿En qué se Diferencian?
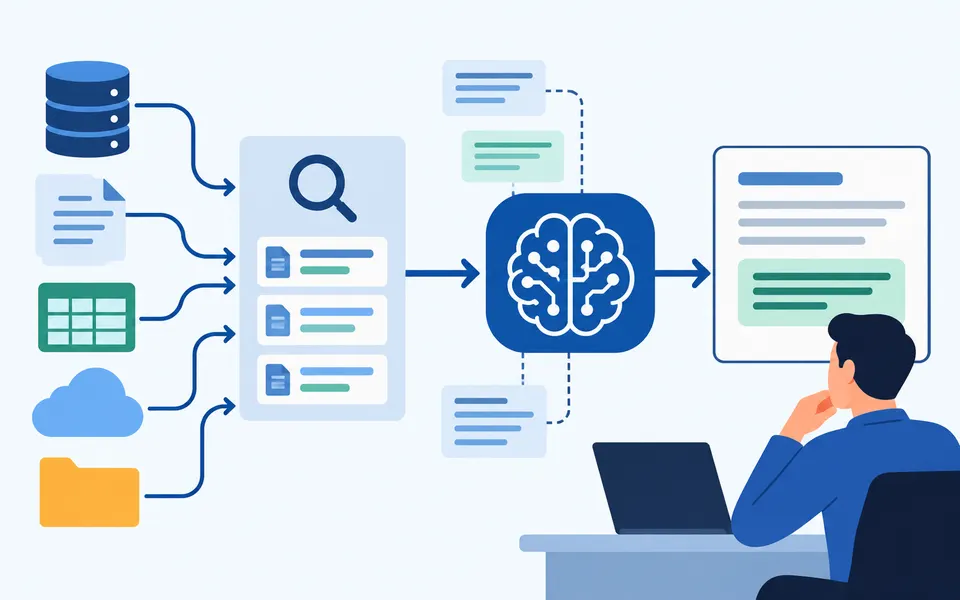
Cómo RAG desbloquea el poder de los datos empresariales
DBT Labs lanza copiloto de IA para aumentar la eficiencia del desarrollador
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
