
¿Podría Tu Chatbot Estar Filtrando Información Privada? Entendiendo los Ataques de Inversión de Modelos
En esta página
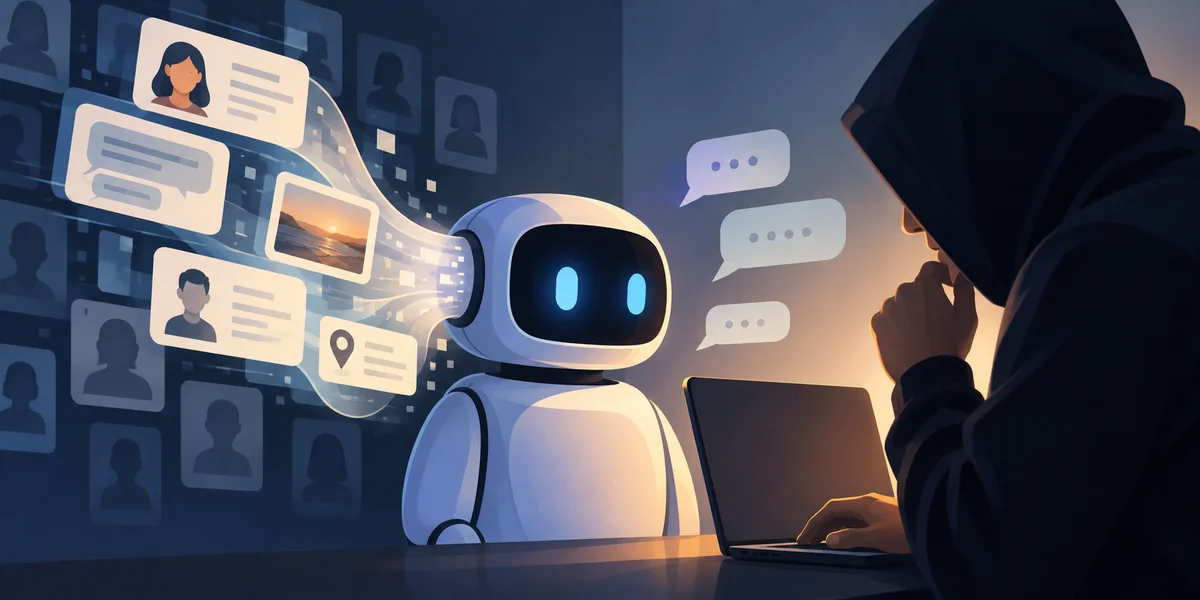
Los chatbots se han convertido en una parte cotidiana de cómo interactuamos con la tecnología. Ya sea para soporte al cliente o una conversación casual, son rápidos, útiles y siempre están disponibles. Sin embargo, detrás de esa conveniencia reside una creciente preocupación que la mayoría de las personas ni siquiera considera. Estos bots, impulsados por redes neuronales, podrían estar revelando más de lo que esperas, incluso sin intención.
Esto es lo que significa en términos simples. Cuando un chatbot es entrenado con un gran conjunto de datos de usuarios, aprende patrones para responder mejor. Eso es normal. El problema comienza cuando alguien encuentra una manera de revertir ese proceso: un método conocido como ataque de inversión de modelos. Es exactamente lo que suena: alguien intenta extraer datos originales del modelo mismo. Y sí, eso puede incluir nombres, fotos o incluso detalles sensibles.
Cómo Funcionan Realmente los Ataques de Inversión de Modelos
Imagina que un chatbot fue entrenado usando miles de transcripciones de soporte al cliente. Ahora sabe cómo responder educadamente, contestar preguntas y manejar quejas. Todo bien hasta aquí. Sin embargo, si alguien usa las indicaciones y técnicas correctas, puede intentar forzar al modelo a “recordar” y compartir partes de los datos de entrenamiento.
Esto no significa que el chatbot de repente suelte tu contraseña, no es tan directo. Lo que sucede en cambio es más lento. Es como pescar en un estanque oscuro: lanzas el cebo correcto suficientes veces, y eventualmente podrías atrapar algo que nunca debió salir a la superficie.
Los investigadores probaron esto con sistemas de reconocimiento facial. Le pidieron al modelo que generara una imagen de un rostro que había visto durante el entrenamiento. Los resultados fueron cercanos—espantosamente cercanos— a fotos reales. Y lo mismo puede ocurrir con el lenguaje. Haz las preguntas adecuadas, y podrías obtener fragmentos de conversaciones reales que deberían haber permanecido privadas.
Qué Hace Posibles Estos Ataques
La respuesta corta es sobreajuste. Cuando una red neuronal memoriza en lugar de aprender patrones, se vuelve más fácil extraer datos específicos. Es como un estudiante que se prepara para un examen memorizando las respuestas. Haz la misma pregunta, y escupirán exactamente lo que leyeron. Pero si preguntas algo nuevo, tendrán dificultades.
Lo mismo se aplica aquí. Un chatbot bien entrenado debería entender cómo generalizar. Pero cuando un modelo está demasiado vinculado a sus datos de entrenamiento, termina reteniendo frases específicas, nombres o incluso identificadores. Y cuando se le provoca de la manera correcta, esa memoria aparece en sus respuestas.
¿Otra razón? El tamaño del modelo. Cuanto más grande es el modelo, más tiende a absorber. Y a veces, termina almacenando cosas que no debería, especialmente si esos datos no fueron limpiados adecuadamente antes del entrenamiento. Piensa en ello como empacar una maleta apresuradamente. Podrías terminar con artículos que no pretendías llevar.
Cómo Saber Si Tu Bot Es Vulnerable
No necesitas ser un científico de datos para detectar señales de alerta. Algunos signos son más obvios que otros. Por ejemplo, ¿el chatbot alguna vez ofrece respuestas extrañamente específicas a preguntas vagas? Eso es una pista. Los bots genéricos usualmente responden en un tono seguro y neutral. Si tu chatbot comienza a soltar nombres completos, fechas o eventos de la nada, eso no solo es extraño, es arriesgado.
Luego está el tema de la consistencia. Los bots bien entrenados pueden manejar la aleatoriedad. Pero si tu chatbot siempre responde a ciertas preguntas con la misma frase, especialmente si suena como si proviniera de los datos de una persona real, eso es otra advertencia. Podría estar repitiendo una parte de su conjunto de entrenamiento, palabra por palabra.
También deberías preguntar: ¿quién entrenó el modelo y qué datos se usaron? Si tu chatbot se construyó usando datos abiertos o contenido extraído sin filtros adecuados, ya está a medio camino de ser vulnerable. Añade pruebas deficientes y sin controles de privacidad, y tienes un reloj en marcha.
Qué Se Puede Hacer al Respecto
Comienza con lo básico: mantén limpios tus datos de entrenamiento. Eso significa eliminar cualquier información personal identificable antes de alimentarla al modelo. Suena simple, pero a menudo se omite en la prisa por construir algo rápidamente.
Luego, añade ruido. Esto puede parecer contradictorio, pero funciona. Una técnica llamada privacidad diferencial introduce ligeros cambios durante el entrenamiento para que los registros individuales no se destaquen. Piensa en ello como mezclar los datos lo suficiente para ocultar los detalles originales, pero no tanto como para que el bot olvide cómo responder.
También hay auditorías regulares. En lugar de dejar que tu chatbot navegue libremente, pruébalo. Lánzale preguntas extrañas. Intenta extraer información. Y si encuentras algo siquiera cercano a un nombre real, es hora de volver al entrenamiento.
Finalmente, limita lo que el chatbot puede acceder. Solo porque un modelo puede extraer información de un gran conjunto de datos no significa que deba hacerlo. Restringe el alcance y solo dale lo que absolutamente necesita para hacer el trabajo. Menos puertas significan menos formas de entrar.
¡En Resumen!
La mayoría de las personas piensan en los chatbots como ayudantes amigables, no como fugas de datos. Pero la verdad es que, cuando se construyen sin cuidado, pueden convertirse en herramientas que revelan silenciosamente más de lo que deberían. Los ataques de inversión de modelos no son ciencia ficción, son reales, probados y están aumentando en sofisticación.
Así que si estás usando un chatbot, o construyendo uno, vale la pena verificar lo que realmente está reteniendo. Porque, al final, no se trata solo de respuestas más inteligentes. Se trata de saber que lo que se dice en confianza no volverá a surgir en la conversación de otra persona. Un poco de precaución ahora puede prevenir mucho daño después. ¡Mantente atento para más!
Artículos relacionados
Couchbase Presenta un Conjunto de Servicios para el Desarrollo de IA
Google Hace Disponible el Modelo de Video Veo en Vertex AI

Nuevas Integraciones de Qlik Preparan Datos para el Desarrollo de IA
Pocas Ejemplificaciones en IA: Cómo Mejora la Comprensión de los Modelos de Lenguaje
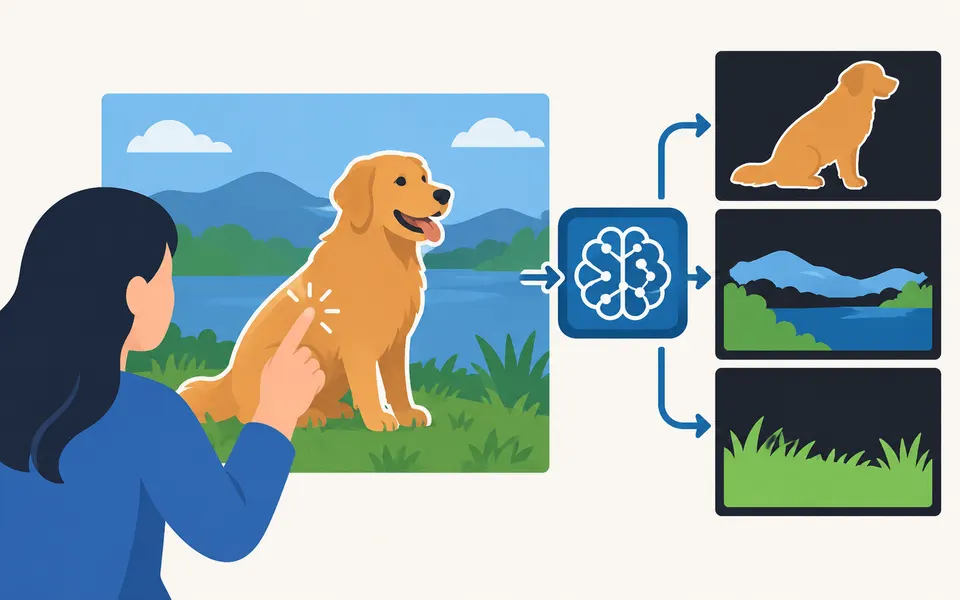
El Modelo Segment Anything de Meta (SAM): Revolucionando la Segmentación de Imágenes con IA
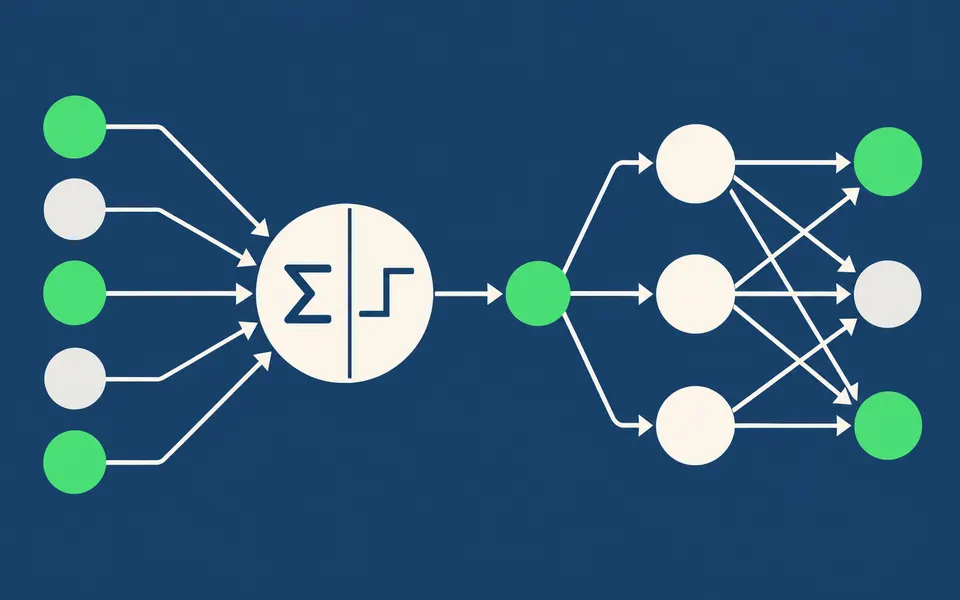
Neurona McCulloch-Pitts: El Bloque Lógico Fundamental de las Redes Neuronales
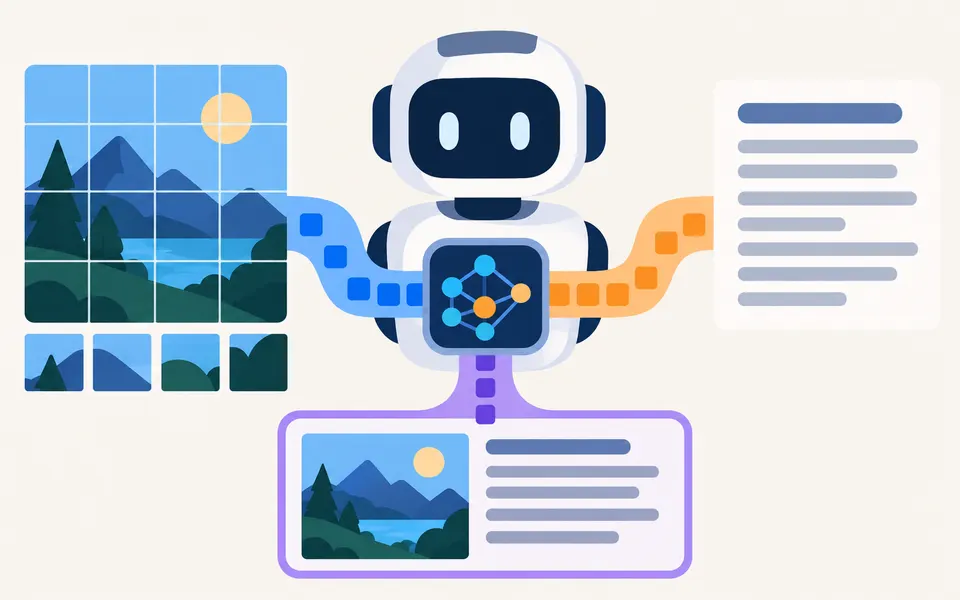
Conoce Pixtral-12B: El Modelo Multimodal de Mistral con Adaptador de Visión
MCP Explicado: Cómo Permite a los Modelos de IA Trabajar con Contexto y Datos
¿Cómo se Entrenan las Herramientas de IA?
Despliegue de IA en la Nube vs. Local: Una Comparación Exhaustiva
Validación Cruzada en Aprendizaje Automático: Cómo Mejora la Precisión del Modelo
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
