
Conoce Pixtral-12B: El Modelo Multimodal de Mistral con Adaptador de Visión
En esta página
El avance de la inteligencia artificial está acelerándose rápidamente, y uno de los desarrollos más emocionantes recientemente es la introducción de Pixtral-12B: el primer modelo multimodal de Mistral AI. Este modelo se basa en el modelo insignia de la compañía, Nemo 12B, integrando visión y lenguaje para procesar texto e imágenes sin problemas en un solo flujo de trabajo.
Los modelos multimodales están a la vanguardia de la IA generativa, y Pixtral-12B marca un paso significativo para hacer que estas tecnologías sean más accesibles. En este artículo, profundizaremos en qué es Pixtral-12B, sus características únicas, mecanismos operativos y sus implicaciones para el futuro de la IA.
Arquitectura de Pixtral-12B
En su núcleo, Pixtral-12B es una versión mejorada del Nemo 12B, el modelo de lenguaje insignia de Mistral. Su singularidad radica en la adición de un adaptador de visión de 400 millones de parámetros específicamente diseñado para procesar datos visuales.
La arquitectura del modelo incluye:
- 12 mil millones de parámetros en el modelo de lenguaje base
- 40 capas de transformadores
- Un adaptador de visión que utiliza activación GeLU
- RoPE 2D (Embeddings de Posición Rotatoria) para codificación espacial
- Tokens especiales como img, img_break e img_end para gestionar la entrada multimodal
Pixtral-12B admite imágenes de hasta 1024 x 1024 de resolución, utilizando codificación base64 o URLs de imagen. Las imágenes se dividen en parches de 16x16, lo que permite al modelo interpretarlas de manera detallada y estructurada.
Capacidades Multimodales: Uniendo Visión y Lenguaje
Pixtral-12B está diseñado para combinar información visual y textual en un flujo de procesamiento unificado. Esto significa que procesa imágenes y texto acompañante simultáneamente, manteniendo la integridad contextual.
Así es como lo logra:
- Conversión de imagen a embedding: El adaptador de visión convierte los datos de píxeles en embeddings interpretables por el modelo.
- Combinación de texto e imagen: Estos embeddings se integran con el texto tokenizado, ayudando al modelo a comprender la relación entre los elementos visuales y lingüísticos.
- Codificación espacial: El 2D RoPE preserva la estructura y posición espacial dentro de la imagen durante el proceso de embedding.
Como resultado, Pixtral-12B puede analizar contenido visual mientras comprende el contexto del texto circundante. Esto es particularmente útil en escenarios que requieren razonamiento espacial y segmentación de imágenes.
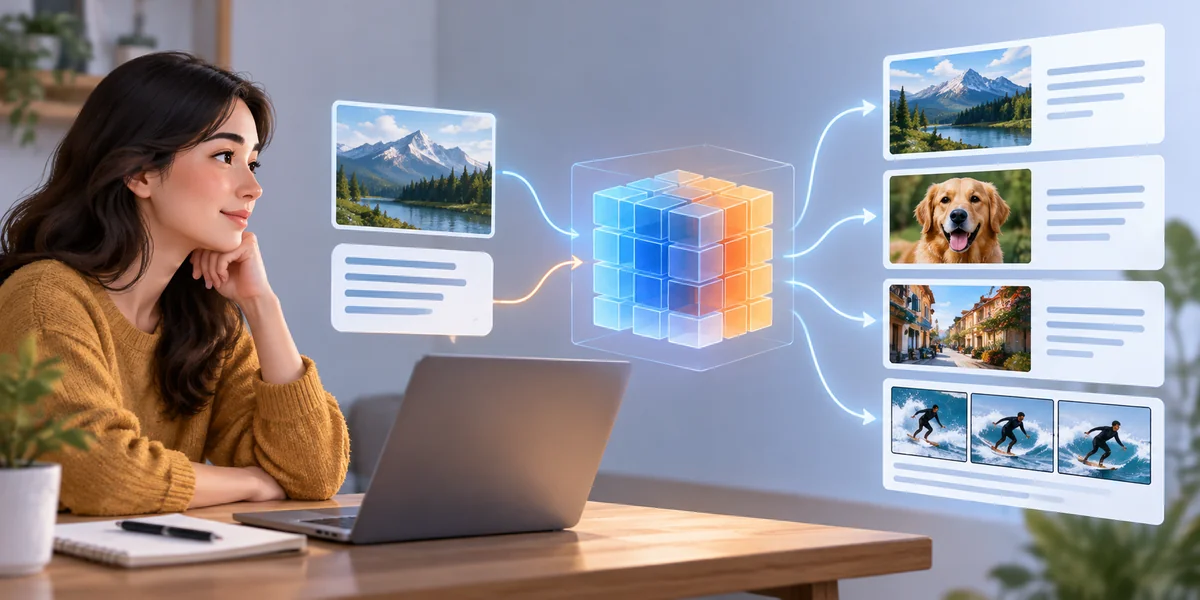
Este procesamiento cohesivo permite al modelo realizar tareas como:
- Generación de subtítulos para imágenes
- Narración descriptiva
- Respuestas a preguntas basadas en el contexto
- Análisis detallado de imágenes
- Escritura creativa basada en estímulos visuales
La capacidad de Pixtral-12B para manejar imágenes de múltiples cuadros o compuestas, entendiendo transiciones y acciones a través de los cuadros, demuestra sus avanzadas capacidades de razonamiento espacial.
Tokenización Multimodal y Uso de Tokens Especiales
Un aspecto crucial del éxito de Pixtral-12B en el procesamiento de imágenes y texto es su diseño de tokens especiales. Utiliza tokens dedicados para guiar su comprensión del contenido multimodal:
- img: Indica el inicio de una entrada de imagen
- img_break: Denota la separación entre segmentos de imagen
- img_end: Marca el final de una entrada de imagen
Estos tokens actúan como mecanismos de control, permitiendo al modelo comprender la estructura de una solicitud multimodal. Esto mejora su capacidad para alinear embeddings visuales y textuales, asegurando que el contexto visual no interfiera con la interpretación del texto y viceversa.
Acceso y Despliegue
Actualmente, Pixtral-12B no está disponible a través de las interfaces Le Chat o La Plateforme de Mistral. Sin embargo, se puede acceder a través de dos medios principales:
1. Descarga por Torrent
Mistral ofrece el modelo a través de un enlace de torrent, permitiendo a los usuarios descargar el paquete completo, incluidos los pesos y archivos de configuración. Esta opción es ideal para aquellos que prefieren trabajar sin conexión o buscan tener control total sobre el despliegue.
2. Acceso en Hugging Face
Pixtral-12B también está disponible en Hugging Face bajo la licencia Apache 2.0, que permite tanto el uso para investigación como comercial. Los usuarios deben autenticarse con un token de acceso personal y contar con recursos informáticos adecuados, particularmente GPUs de gama alta, para utilizar el modelo en esta plataforma. Este nivel de acceso fomenta la experimentación, adaptación e innovación en diversas aplicaciones.
Características Clave que Diferencian a Pixtral-12B
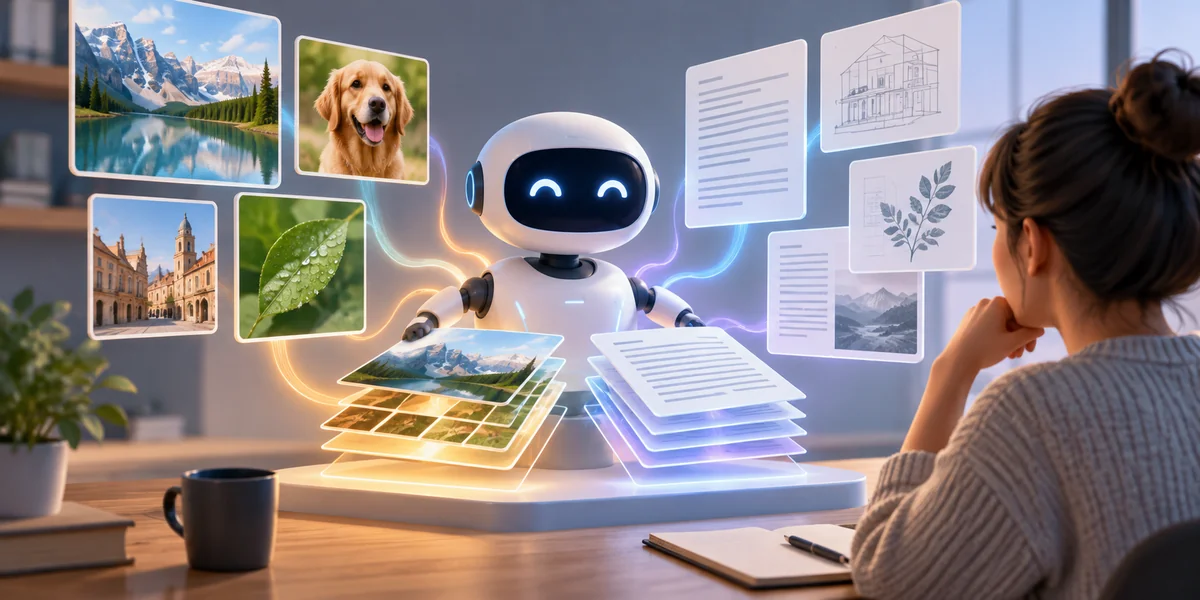
Pixtral-12B introduce una combinación de características que lo elevan de un modelo estándar basado en texto a una potente herramienta multimodal:
Soporte de Imágenes de Alta Resolución
Su capacidad para manejar imágenes de hasta 1024 x 1024 de resolución, segmentadas en pequeños parches, permite una comprensión visual detallada.
Alta Capacidad de Tokens
Con soporte para hasta 131,072 tokens, Pixtral-12B puede procesar solicitudes muy largas, siendo ideal para la generación de historias o el análisis a nivel de documento.
Adaptador de Visión con Activación GeLU
Este componente permite al modelo procesar adaptativamente las embeddings de imagen, haciendo que la integración con el modelo de lenguaje central sea fluida y eficiente.
Atención Consciente del Espacio a través de RoPE 2D
El avanzado codificador de visión proporciona al modelo una comprensión más profunda de cómo los elementos visuales se relacionan espacialmente, crucial para interpretar escenas, diagramas o imágenes de múltiples cuadros.
Conclusión
Pixtral-12B representa un momento crucial para Mistral AI y la comunidad de código abierto en general. No solo es el primer modelo multimodal de Mistral, sino también una de las herramientas de código abierto más accesibles y poderosas en el procesamiento de imagen-texto.
Al combinar inteligentemente el modelado de visión y lenguaje, Pixtral-12B puede interpretar imágenes en profundidad y generar un lenguaje que refleja una comprensión sofisticada tanto del contenido como del contexto. Desde capturar momentos deportivos hasta crear historias, demuestra cómo la IA puede cerrar la brecha entre lo que ves y lo que expresas.
Artículos relacionados
Transforma Tu Estrategia PPC con IA en 3 Pasos Prácticos
Maximizar la Eficiencia: Obtén MÁS Resultados con ChatGPT 101
Por qué combinar la IA con la automatización revolucionará tu flujo de trabajo
Cómo usar ChatGPT de OpenAI para Escribir Correos Electrónicos de Negocios Automáticamente
Cómo la gestión de proyectos con IA puede impulsar la productividad

Desbloqueando Tu Idea de Libro Más Vendido con ChatGPT

La Verdadera Manera de Hacer que el Contenido se Vuelva Viral con ChatGPT
Los 6 Mejores Libros para Dominar la Generación Aumentada por Recuperación en IA
Modelado 3D Mejorado por IA con el Innovador Hunyuan3D-1.0 de Tencent
Desmitificando la IA: Generando Confianza y Mejorando los Flujos de Trabajo de Contenido
MCP Explicado: Cómo Permite a los Modelos de IA Trabajar con Contexto y Datos
Agente OWL: La Alternativa Definitiva de Código Abierto a Manus AI
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
