
Los 6 Modelos de Lenguaje Más Impresionantes que Debes Conocer en 2025
En esta página
Los grandes modelos de lenguaje han evolucionado rápidamente en los últimos años. Lo que antes era una tecnología de nicho, ahora desempeña un papel significativo, desde resumir estudios médicos hasta crear poesía. En 2025, la última generación de modelos ha logrado avances notables en rendimiento, versatilidad y procesamiento del lenguaje natural. Antes de sumergirnos en los modelos más destacados disponibles hoy, aclaremos qué hace que un modelo de lenguaje sea excepcional.
¿Qué Hace Destacar a un Modelo de Lenguaje?
Todos los modelos de lenguaje están diseñados para entender y generar lenguaje humano. Sin embargo, no todos sobresalen en sonar como humanos. Los modelos líderes en 2025 van más allá de simplemente llenar vacíos o escupir palabras clave. Entienden matices, recuerdan el contexto y mantienen un tono consistente. Mientras que algunos destacan en el razonamiento, otros son más rápidos, y algunos están entrenados con objetivos específicos, como la programación o la educación.
Los modelos más destacados se distinguen por su adaptabilidad en diversas tareas. Un modelo puede sobresalir en resumir documentos legales, mientras que otro puede transformar notas desordenadas en publicaciones de blog pulidas. Los mejores modelos no solo responden, sino que se adaptan, lo que conduce a menos ediciones, interacciones más fluidas y resultados que parecen provenir de una persona que realmente entiende la tarea.
Ahora, exploremos los modelos de lenguaje que vale la pena conocer este año. Cada modelo ofrece algo único, y ese es precisamente el punto.
GPT-4 Turbo (OpenAI)
GPT-4 Turbo es probablemente el modelo más comentado. No solo es más rápido que el GPT-4 estándar, sino también más eficiente, con capacidades de memoria extendidas que le permiten manejar tareas más grandes sin perder el hilo de la entrada anterior. Se utiliza ampliamente en educación, escritura, soporte y programación. ¿Una ventaja notable? Está entrenado con datos hasta finales de 2023, lo que lo hace sentir actual y menos robótico.
Los usuarios aprecian su equilibrio entre personalidad y precisión. Puede adaptar su tono de casual a profesional según la entrada y rara vez se desvía a mitad de respuesta. También es la columna vertebral de ChatGPT Pro, ya popular entre los usuarios.
Claude 3 (Anthropic)
Claude es conocido por su enfoque cuidadoso, no de una manera aburrida, sino manteniendo respuestas claras, seguras y constantes. Claude 3 ofrece interacciones más fluidas y está más sintonizado con conversaciones largas. Con ejemplos proporcionados, mejora con el tiempo.
Es preferido por las empresas que requieren un tono y claridad consistentes, como plataformas de tutoría, asistencia para la escritura y atención al cliente. Su característica destacada es evitar conjeturas cuando no está seguro, optando por la honestidad, lo que genera confianza.
Gemini 1.5 (Google DeepMind)
Gemini es la respuesta de Google al panorama evolutivo de los modelos de lenguaje, y la versión 1.5 trae mejoras significativas. Maneja texto, imágenes y código, gestionando miles de líneas de entrada, ya sea un documento extenso o un manual técnico. Esto lo hace invaluable para la investigación, el trabajo legal y contextos donde los detalles importan.
Gemini no solo resume; destaca puntos clave y explica conceptos como si se dirigiera a una persona, no a una máquina. Para los usuarios de Google Workspace, Gemini se integra perfectamente con Docs y Sheets.
Mistral 7B & Mixtral (Mistral)
Estos modelos son compactos pero potentes. Mistral 7B es un modelo de peso abierto que es fácil de ejecutar localmente, mientras que Mixtral utiliza un método llamado mezcla de expertos. Esencialmente, Mixtral solo utiliza los componentes necesarios cada vez, lo que lo hace más rápido y eficiente en recursos.
Los desarrolladores, investigadores y startups aprecian estos modelos por su potencia sin necesidad de hardware extenso. A pesar de su tamaño, la salida sigue siendo nítida, legible e impresionantemente bien estructurada.
Command R+ (Cohere)
Command R+ se especializa en generación aumentada por recuperación (RAG), lo que significa que mejora las respuestas incorporando información externa, ideal para industrias que necesitan resultados rápidos y basados en hechos, como soporte técnico, bases de conocimiento y finanzas.
No se centra en la creatividad, sino en la velocidad y la precisión. Dados documentos, artículos o instrucciones, los integra claramente, entregando información precisa rápidamente sin detalles innecesarios.
LLaMA 3 (Meta)
El último modelo LLaMA de Meta enfatiza la apertura. LLaMA 3 atiende tanto a usuarios casuales como a desarrolladores que desean entrenar sus propias versiones. Es de peso abierto, permitiendo personalización y desarrollo de aplicaciones sin los servidores de Meta.
LLaMA 3 es notable por su equilibrio entre rendimiento y flexibilidad. Sobresale en seguir instrucciones, crear copias limpias y resumir sin sonar rígido. Y con capacidades offline, los usuarios preocupados por la privacidad lo encuentran una opción confiable.
Reflexiones Finales
Los modelos de lenguaje ya no son solo tecnología de fondo. Influyen en cómo buscamos, escribimos, investigamos y creamos. Ya sea que necesites un modelo rápido y flexible, lento y cuidadoso, o privado y personalizable, 2025 ofrece opciones que se ajustan a estas necesidades. No se trata de encontrar el "mejor", sino el que se alinea con tus requisitos. Estos seis modelos ilustran el progreso en este campo, y el ritmo solo está acelerándose. Las herramientas más inteligentes se están volviendo más comunes. Ahora es el momento perfecto para encontrar un modelo que complemente tu flujo de trabajo.
Artículos relacionados
El Futuro del SEO en la Era de la IA de Clic Cero: ¿Qué Deberían Hacer los Mercadólogos?
IA Móvil de Próxima Generación: Cómo los LLMs Están Cambiando los Smartphones para Siempre
Presentando Gemma 2: El Futuro de los Modelos de Lenguaje de Google
Los Modelos de Lenguaje Pequeños Están Silenciosamente Reemplazando a los LLMs como el Futuro de la IA
Herramientas de Procesamiento de Lenguaje Natural (PLN)
Términos Clave de la IA Generativa Explicados
Modelos de Lenguaje Extenso vs. IA Generativa: Comprendiendo las Diferencias Clave
Impulsando la IA: La Energía Detrás de los Grandes Modelos de Aprendizaje Automático
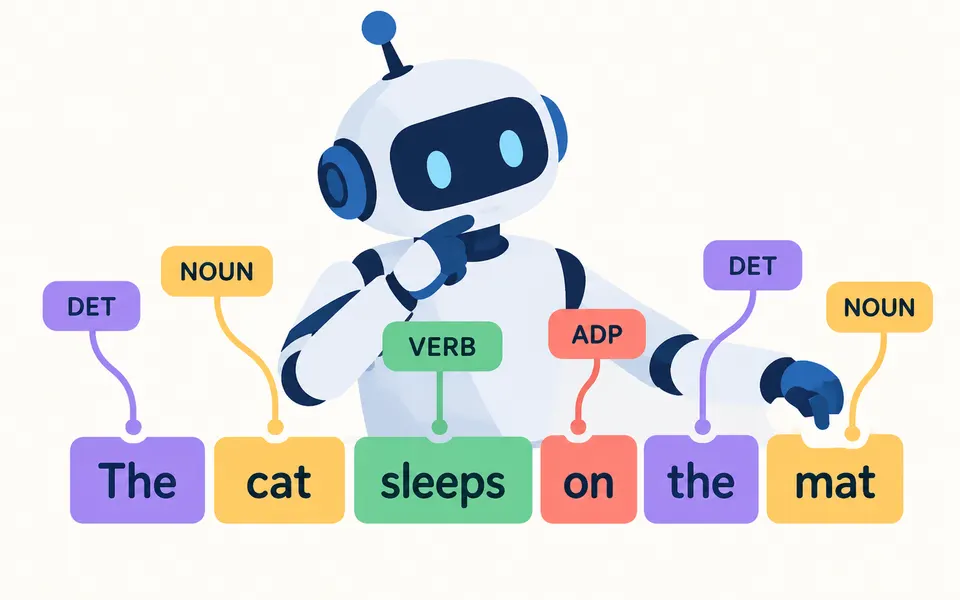
Descifrando el Código: Cómo el Etiquetado de Partes del Discurso Potencia la IA
Descifrando el Código del One-shot Prompting en IA
Una Guía para Principiantes sobre Algoritmos de PLN y su Rol en la IA
Writer Lanza Nuevo Palmyra Creative LLM
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
