
Guía Paso a Paso para Desplegar y Ajustar Modelos DeepSeek en AWS
En esta página
El despliegue y ajuste de modelos de lenguaje grande (LLMs) como DeepSeek se ha vuelto más accesible gracias a plataformas en la nube como AWS. Los modelos DeepSeek ofrecen potentes capacidades en comprensión del lenguaje natural, generación de código y automatización de tareas. Para desarrolladores, investigadores o empresas que deseen personalizar estos modelos, AWS proporciona las herramientas necesarias para escalar de manera eficiente y económica.
Esta guía explica cómo cualquiera puede desplegar y ajustar modelos DeepSeek en AWS, desde la configuración de infraestructura hasta el entrenamiento del modelo en conjuntos de datos personalizados. Los pasos están escritos de manera clara, utilizando lenguaje no técnico siempre que sea posible, para garantizar que sea fácil de seguir, incluso para aquellos nuevos en el aprendizaje automático o servicios en la nube.
Entendiendo los Modelos DeepSeek
DeepSeek es una familia de modelos de lenguaje grande creados para tareas como generación de texto, traducción e incluso codificación. Estos modelos son similares en arquitectura a los modelos estilo GPT, ofreciendo miles de millones de parámetros para respuestas precisas y coherentes.
Algunos de los modelos disponibles incluyen:
- DeepSeek-Coder 6.7B: Enfocado en tareas de programación.
- DeepSeek-VL: Maneja tareas de visión y lenguaje juntas.
- DeepSeek-Instruct: Optimizado para tareas de seguimiento de instrucciones como Q&A y resúmenes.
Los desarrolladores prefieren DeepSeek porque es de código abierto y accesible a través de plataformas como Hugging Face. Esta apertura permite a los usuarios ajustar y desplegar modelos libremente sin costos de licencia.
¿Por Qué Usar AWS para Desplegar Modelos DeepSeek?
AWS (Amazon Web Services) ofrece una infraestructura escalable ideal para ejecutar modelos grandes como DeepSeek. Con servicios como EC2 (Elastic Compute Cloud) y SageMaker, los usuarios pueden gestionar fácilmente el despliegue y entrenamiento de modelos en la nube.
A continuación, algunas razones por las cuales AWS es ideal:
- Opciones de GPU potentes para entrenamiento e inferencia
- Almacenamiento flexible usando Amazon S3
- Entorno seguro con control de acceso basado en roles
- Múltiples servicios de despliegue, incluyendo EC2, Lambda y SageMaker
- Herramientas de escalado y monitoreo automatizado
Estas características hacen de AWS una plataforma confiable para desplegar y ajustar cualquier modelo de IA.
Paso 1: Configuración del Entorno AWS
Antes de usar un modelo DeepSeek, los usuarios deben preparar su entorno AWS. Esto incluye crear una cuenta de AWS, lanzar una instancia EC2, o usar opcionalmente SageMaker.
Creación de una Cuenta AWS
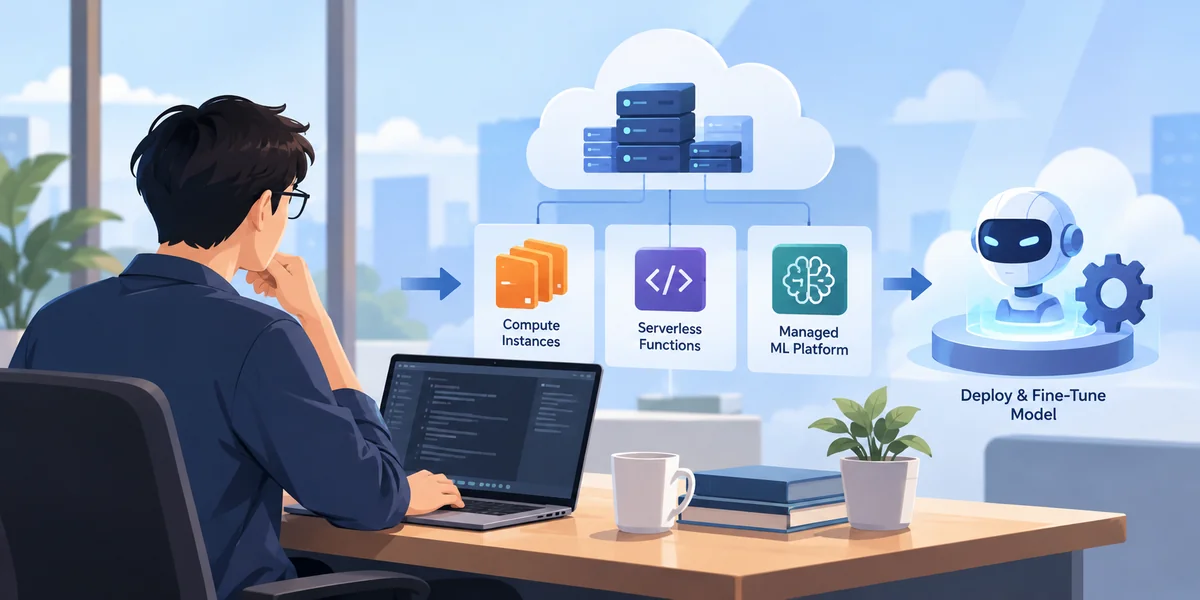
Para comenzar, visita el sitio web de AWS y regístrate para obtener una cuenta. Se requiere una dirección de correo electrónico válida y un método de pago. Una vez verificado, los usuarios obtienen acceso a la Consola de Gestión de AWS.
Lanzamiento de una Instancia EC2
Para desplegar DeepSeek manualmente, EC2 proporciona una ruta simple:
- Abre la Consola de AWS y ve a EC2.
- Haz clic en "Launch Instance".
- Elige una AMI basada en Linux, como Ubuntu 20.04.
- Selecciona una instancia de GPU como g4dn.xlarge o p3.2xlarge (importante para el rendimiento del modelo).
- Configura grupos de seguridad (abre el puerto 22 para SSH).
- Lanza la instancia y conéctate vía SSH usando un par de claves.
Tras conectarte a la instancia EC2, el sistema está listo para las dependencias.
Paso 2: Instalación de Bibliotecas Requeridas
Una vez que la instancia EC2 está en funcionamiento, instala los paquetes necesarios. Estos incluyen bibliotecas de Python como PyTorch, Transformers y Accelerate.
En el terminal de EC2, ejecuta:
sudo apt update
sudo apt install -y python3-pip git
pip3 install torch transformers accelerate datasets
Los usuarios también deben instalar nvidia-smi y controladores CUDA si la instancia usa una GPU.
Estas bibliotecas permitirán al sistema descargar, cargar y entrenar el modelo DeepSeek de manera eficiente.
Paso 3: Accediendo al Modelo DeepSeek
La mayoría de los modelos DeepSeek están alojados en Hugging Face. Usa la biblioteca transformers para cargar el modelo.
from transformers import AutoTokenizer, AutoModelForCausalLM
Define el nombre del modelo DeepSeek para cargar
deepseek_model = “deepseek-ai/deepseek-coder-6.7b-instruct”
Cargar el tokenizer, que prepara el texto de entrada
tokenizer = AutoTokenizer.from_pretrained(deepseek_model)
Cargar el modelo, que generará o comprenderá el lenguaje
model = AutoModelForCausalLM.from_pretrained(deepseek_model)
Probar un prompt básico para verificar si el modelo funciona
sample_input = “Explica qué es una función en Python.”
tokens = tokenizer.encode(sample_input, return_tensors=“pt”)
output = model.generate(tokens, max_length=100)
Decodificar la respuesta del modelo en texto legible
response = tokenizer.decode(output[0], skip_special_tokens=True)
print(response)
Se cargará automáticamente el tokenizer y el modelo en tu GPU (si está disponible).
Paso 4: Despliegue Opcional Usando SageMaker
Si bien EC2 proporciona control, AWS SageMaker ofrece una manera simplificada de desplegar modelos con infraestructura gestionada.
Para usar SageMaker:
- Abre la Consola de AWS y navega a SageMaker.
- Crea una nueva instancia de notebook o un endpoint en tiempo real.
- Selecciona un tipo de instancia con soporte GPU, como ml.p3.2xlarge.
- Usa el SDK de Python de SageMaker para cargar el modelo DeepSeek.
Ejemplo:
from sagemaker.huggingface import HuggingFaceModel
hub = {
‘HF_MODEL_ID’:‘deepseek-ai/deepseek-coder-6.7b-instruct’,
‘HF_TASK’:’text-generation’
}
huggingface_model = HuggingFaceModel(
transformers_version=‘4.26’,
pytorch_version=‘1.13’,
py_version=‘py39’,
env=hub,
role=‘YourSageMakerExecutionRole’,
instance_type=‘ml.p3.2xlarge’
)
predictor = huggingface_model.deploy()
Este proceso maneja el escalado, control de versiones y monitoreo automáticamente.
Paso 5: Ajuste Fino del Modelo DeepSeek
El ajuste fino permite que el modelo se adapte a conjuntos de datos específicos, lo cual es útil para casos de uso específicos o industrias especializadas.
Preparación del Conjunto de Datos
Los usuarios deben preparar un conjunto de datos JSON o CSV que contenga prompts y respuestas esperadas. Un formato común se ve así:
{"prompt": "Traduce al alemán: Manzana", "completion": "Apfel"}Divide el conjunto de datos en conjuntos de entrenamiento y validación para un mejor monitoreo del rendimiento.
Proceso de Ajuste Fino
Usando la API Trainer de Hugging Face, el ajuste fino se vuelve manejable:
from transformers import Trainer, TrainingArguments
from datasets import load_dataset
dataset = load_dataset(“json”, data_files={“train”: “train.json”, “validation”: “val.json”})
def preprocess(example):
return tokenizer(example[“prompt”], truncation=True, padding=“max_length”)
tokenized_dataset = dataset.map(preprocess, batched=True)
training_args = TrainingArguments(
output_dir="./output",
num_train_epochs=3,
per_device_train_batch_size=2,
save_steps=50,
fp16=True
)
trainer = Trainer(
model=model,
args=training_args,
train_dataset=tokenized_dataset[“train”],
eval_dataset=tokenized_dataset[“validation”]
)
trainer.train()
Este script inicia el entrenamiento del modelo, guarda el progreso y evalúa el rendimiento automáticamente.
Es importante monitorear el uso de la GPU durante el entrenamiento usando nvidia-smi.
Paso 6: Guardar y Servir el Modelo
Después del ajuste fino, los usuarios deben guardar el modelo usando:
trainer.save_model("custom-deepseek-model")Este modelo puede ser:
- Almacenado en Amazon S3
- Subido a Hugging Face
- Desplegado nuevamente a través de EC2 o SageMaker
Para servir API, se pueden usar herramientas como FastAPI, Flask o AWS Lambda (para inferencia ligera).
Consejos para el Éxito
- Usa Instancias Spot: Ahorra hasta un 70% en costos de EC2 durante el entrenamiento.
- Comienza con modelos pequeños: Evita errores de memoria al probar.
- Siempre monitorea el uso: Rastrea el consumo de CPU, RAM y GPU.
- Respalda modelos: Almacena modelos entrenados en S3 para prevenir la pérdida de datos.
- Optimiza el tamaño de lotes: Los lotes pequeños ayudan a evitar errores OOM (fuera de memoria).
Conclusión
Desplegar y ajustar modelos DeepSeek en AWS abre la puerta a aplicaciones de IA potentes y personalizadas. Ya sea usando EC2 para control práctico o SageMaker para automatización, AWS hace posible escalar el aprendizaje automático con facilidad. Siguiendo estos pasos, los desarrolladores y equipos de datos pueden construir, entrenar y desplegar con confianza modelos de lenguaje avanzados adaptados a sus necesidades específicas. A medida que la IA sigue evolucionando, plataformas como AWS y modelos como DeepSeek se están convirtiendo en herramientas esenciales en el stack tecnológico moderno.
Artículos relacionados
Listados Más Inteligentes: Cómo los Vendedores de Amazon Usan ChatGPT
Sobreajuste y Subajuste: Conceptos Clave en el Desarrollo de Modelos de IA
Comprendiendo los Modelos Semánticos de Power BI para un Análisis Más Inteligente
Protege Tu Negocio en Amazon: Mantente Cumpliendo Normativas y Evita Infracciones con IA
ChatGPT 101: Una Forma Más Inteligente de Hacer Crecer Tu Negocio en Amazon
Dominio del PPC de Amazon con ChatGPT: Convierte Clics en Conversiones
Haz que Tu Producto de Amazon Destaque con ChatGPT en Minutos
Domina Amazon PPC con ChatGPT: Optimiza Campañas y Ahorra Tiempo
Revolucionarios de la IA que Asegurarán el Futuro de tu Estrategia de Venta en Amazon
Secretos Reveladores para Dominar Amazon con ChatGPT: Impulsa Tu Estrategia de Ventas
Cómo la IA Facilita el Crecimiento de tu Negocio en Amazon
Cómo la gestión de proyectos con IA puede impulsar la productividad
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
