
Diseña Bases de Datos Más Inteligentes: Guía Práctica para la Normalización en SQL
En esta página
Los datos sin estructura son caos, especialmente cuando crecen rápidamente. Si trabajas con bases de datos relacionales, mantener tus datos organizados no solo es útil, es esencial. Ahí es donde entra la normalización. Es uno de esos conceptos de bases de datos que todos escuchan desde el principio, pero muchos pasan por alto hasta que empiezan a aparecer anomalías de datos o el almacenamiento se descontrola. La normalización no es solo un conjunto de reglas, es una forma de hacer que tu base de datos sea más ligera, inteligente y fácil de gestionar con el tiempo.
Si te preguntas cómo implementar la normalización con SQL de manera práctica, estás en el lugar correcto. Vamos a desglosar lo que realmente significa y cómo puedes aplicarlo sin complicaciones innecesarias.
¿Qué es la Normalización en SQL y Por Qué es Importante?
La normalización en SQL es el proceso de organizar una base de datos en tablas bien estructuradas para reducir la redundancia y la dependencia. Involucra descomponer tablas grandes y voluminosas en otras más pequeñas y enfocadas, asegurando que cada dato se almacene en un solo lugar. Esta estructura ayuda a mantener la precisión y consistencia durante operaciones como actualizaciones, eliminaciones o inserciones. Por ejemplo, si la información del cliente se repite con cada pedido, cualquier cambio en su dirección tendría que hacerse en múltiples filas, creando margen para errores.
Al separar los datos de clientes y pedidos en tablas distintas y vincularlas a través de claves, la normalización simplifica la gestión de datos. También previene anomalías como actualizaciones inconsistentes o dificultades para insertar datos debido a valores faltantes. En resumen, la normalización en SQL hace que tu base de datos sea más eficiente, menos propensa a errores y más fácil de mantener a medida que crece.
Los Formatos Normales: Una Explicación Básica
La normalización sigue una serie de reglas conocidas como “formatos normales”. No son solo casillas académicas, son etapas prácticas que te guían desde un diseño desordenado hasta una estructura más elegante. Los más comúnmente aplicados son los tres primeros:
Primera Forma Normal (1NF):
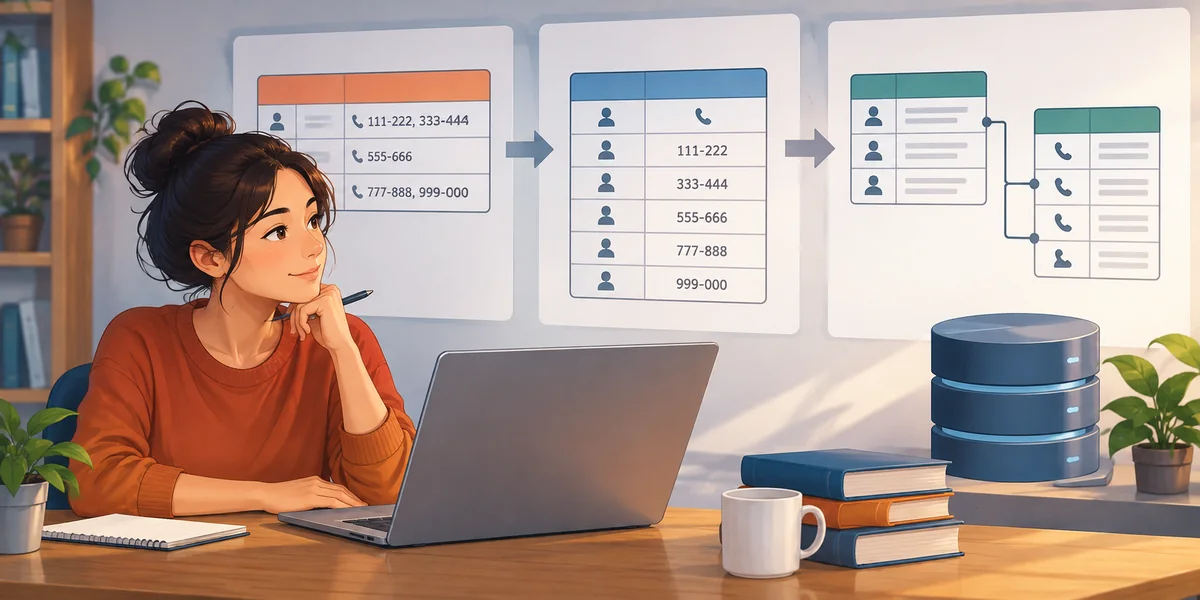
Esto asegura que cada columna contenga solo valores atómicos (indivisibles). Eso significa que no hay listas o conjuntos dentro de una columna. Si una tabla tiene una columna como “números_de_teléfono” con múltiples valores separados por comas, falla en 1NF. Necesitarás dividir esos valores en filas separadas o tablas relacionadas.
Segunda Forma Normal (2NF):
Este paso trata las dependencias parciales, casos donde los atributos no clave dependen de parte de una clave primaria compuesta en lugar de la clave completa. 2NF requiere que tus datos ya estén en 1NF. Supongamos que estás usando una tabla donde un campo depende solo de una porción de la clave (como un nombre de producto dependiendo solo de un ID de producto en una tabla con clave en ID de producto + categoría). En ese caso, es hora de dividir esa dependencia en una nueva tabla.
Tercera Forma Normal (3NF):
Ahora, te aseguras de que cada columna no clave dependa solo de la clave primaria, no de otra columna no clave. Si tienes una columna "departamento" que determina un "nombre_del_gerente", eso es una dependencia transitiva. Significa que deberías mover esa relación a una nueva tabla.
Cada uno de estos formatos ayuda a refinar tu diseño, eliminando la repetición innecesaria y enfocando cada tabla en un solo tema claro. Aunque existen niveles más profundos (4NF y más allá), la mayoría de las aplicaciones del mundo real se detienen en 3NF a menos que haya una razón convincente para ir más allá.
¿Cómo Implementar la Normalización con SQL en la Práctica?
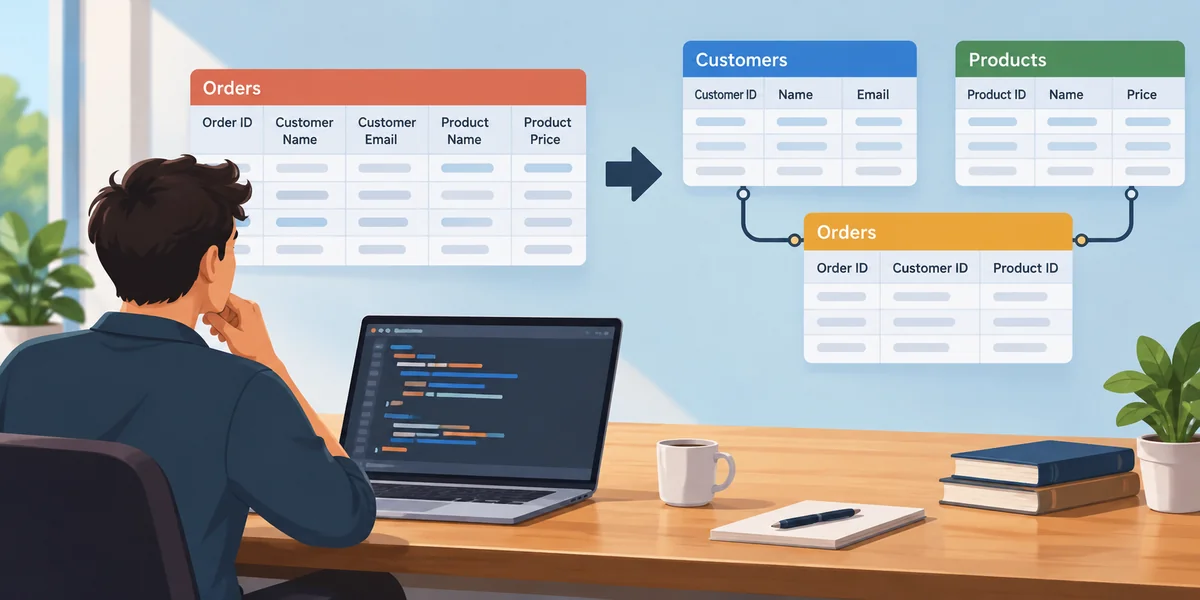
Para entender cómo implementar la normalización con SQL, recorreremos un ejemplo típico. Supongamos que comienzas con una sola tabla que almacena todos los pedidos de clientes:
CREATE TABLE Orders (
    OrderID INT PRIMARY KEY,
    CustomerName VARCHAR(100),
    CustomerEmail VARCHAR(100),
    ProductName VARCHAR(100),
    ProductPrice DECIMAL(10,2)
);
A primera vista, parece limpia. Sin embargo, esta estructura repite la información de clientes y productos cada vez que alguien hace un pedido. Ahora, sigamos los pasos de normalización:
Paso 1: Dividir en Valores Atómicos (1NF)
Supongamos que hay una lista de productos en una fila, separados por comas. Eso es una violación de 1NF. Debes dividir cada producto en sus filas para que cada campo contenga un solo valor.
Una vez que tus datos sean atómicos, pasa a la estructura.
Paso 2: Eliminar Dependencias Parciales (2NF)
Podrías notar que los datos del cliente no necesitan repetirse con cada pedido. Es momento de separarlos:
CREATE TABLE Customers (
    CustomerID INT PRIMARY KEY,
    CustomerName VARCHAR(100),
    CustomerEmail VARCHAR(100)
);

CREATE TABLE Orders (
    OrderID INT PRIMARY KEY,
    CustomerID INT,
    FOREIGN KEY (CustomerID) REFERENCES Customers(CustomerID)
);
Ahora, la tabla Orders solo almacena lo necesario para el pedido, y la información del cliente vive en su propia tabla.
Paso 3: Eliminar Dependencias Transitivas (3NF)
Supongamos que también estábamos almacenando ProductCategory y CategoryDescription en la tabla de productos. Pero CategoryDescription depende de ProductCategory, no del producto en sí. Eso es transitivo.
Divídelo nuevamente:
CREATE TABLE Products (
    ProductID INT PRIMARY KEY,
    ProductName VARCHAR(100),
    ProductPrice DECIMAL(10,2),
    ProductCategoryID INT,
    FOREIGN KEY (ProductCategoryID) REFERENCES Categories(CategoryID)
);

CREATE TABLE Categories (
    CategoryID INT PRIMARY KEY,
    CategoryName VARCHAR(100),
    CategoryDescription TEXT
);
Esa es una estructura completamente normalizada usando SQL. Al separar los temas en diferentes tablas, cada tabla ahora representa claramente una idea: clientes, pedidos, productos y categorías. Ahora puedes insertar, actualizar y eliminar registros con una probabilidad mucho menor de error.
Esta estructura también se adapta bien a la indexación, la optimización de consultas y la expansión futura del esquema. Y todo está impulsado por los principios de normalización en SQL.
Cuándo No Normalizar Demasiado Agresivamente
La normalización es esencial, pero un exceso puede ser contraproducente. La sobre-normalización lleva a uniones excesivas de tablas, lo que puede ralentizar el rendimiento y hacer que las consultas sean más difíciles de escribir y entender, especialmente para herramientas de informes o usuarios empresariales. En sistemas de alta lectura como tableros o análisis, una estructura ligeramente desnormalizada puede mejorar la eficiencia.
Todo se trata de encontrar el equilibrio adecuado. La normalización en SQL brilla en sistemas transaccionales con actualizaciones e inserciones frecuentes. Sin embargo, para informes o almacenamiento de datos, una estructura ligeramente desnormalizada puede ser más práctica. Entender cómo implementar la normalización con SQL incluye saber cuándo priorizar el rendimiento sobre las estrictas reglas de diseño.
Conclusión
La normalización no es solo una mejor práctica, es la columna vertebral de bases de datos confiables y mantenibles. Al aprender cómo implementar la normalización con SQL, creas sistemas que son eficientes, consistentes y más fáciles de escalar. Ya sea que estés diseñando desde cero o limpiando un esquema enredado, aplicar de 1NF a 3NF ayuda a reducir la redundancia y mejora la integridad de los datos. Con la estructura correcta en su lugar, tu base de datos SQL no solo almacenará datos, respaldará consultas más inteligentes, actualizaciones más limpias y un mejor rendimiento con el tiempo.
Artículos relacionados
Modificando Tablas: Cómo Añadir una Nueva Columna en SQL
Los 10 Mejores Canales de YouTube para Dominar SQL a Tu Propio Ritmo
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos

Usa Alias en SQL como un Profesional: No Más Consultas Desordenadas
Desbloqueando el Valor de las Claves Alternativas en Sistemas SQL
Ejecutando LLMs Localmente Usando Ollama: Una Guía para Principiantes
El Poder de la IA en Conectar a las Personas con Información de Salud Confiable
Mejora tus Habilidades en Python: Las 7 Mejores Plataformas de Práctica en Línea

La Verdadera Manera de Hacer que el Contenido se Vuelva Viral con ChatGPT
Cómo la Agregación Condicional Hace que SQL Sea Más Inteligente
Construyendo un Flujo de Trabajo Escalable con MLflow en Google Cloud
Una Guía Completa para el Algoritmo de Backtracking con Aplicaciones Reales
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
