
Modificando Tablas: Cómo Añadir una Nueva Columna en SQL
En esta página
Las estructuras de bases de datos rara vez son permanentes. A medida que los sistemas evolucionan, los desarrolladores y analistas a menudo necesitan modificar tablas existentes para satisfacer nuevos requisitos, como rastrear datos adicionales de usuarios o soportar nuevas funciones. Uno de los cambios más comunes es añadir una nueva columna. Aunque pueda parecer sencillo, hacer tal cambio en un entorno en vivo requiere precaución.
Si se realiza incorrectamente, puede interrumpir aplicaciones o introducir inconsistencias. SQL gestiona este proceso con la declaración ALTER TABLE. Este artículo explica cómo añadir una columna en SQL de manera segura, cubriendo la sintaxis, casos de uso prácticos, restricciones y posibles errores, asegurando que entiendas tanto el cómo como el por qué.
La Sintaxis Básica de ALTER TABLE para Añadir una Columna
SQL ofrece un método directo para añadir una columna a una tabla existente usando la declaración ALTER TABLE. Aquí está la estructura general:
ALTER TABLE nombre_de_la_tabla

ADD nombre_de_la_columna tipo_de_dato;
Por ejemplo, si deseas añadir una columna de correo electrónico de tipo VARCHAR a una tabla de usuarios, el comando se vería así:
ALTER TABLE users

ADD email VARCHAR(255);
Parece simple, ¿verdad? Y lo es, para casos básicos. Pero el mundo real está lleno de complejidad. ¿Necesitas que esta columna permita valores nulos? ¿Debería tener un valor por defecto? ¿Eventualmente contendrá un identificador único? Estas son decisiones que debes tomar antes de ejecutar esa declaración.
Digamos que quieres añadir una columna created_at con un valor por defecto. Así es como se vería:
ALTER TABLE users

ADD created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP;
Esa única línea de SQL tiene peso. No solo estás añadiendo un campo, estás cambiando las reglas para cada registro actual y futuro en esa tabla. Por eso es esencial entender las implicaciones.
Consideraciones Clave al Modificar la Estructura de la Tabla
Añadir una columna en SQL puede parecer sencillo, pero es un cambio que afecta a cada fila en tu tabla. En bases de datos grandes, no es un ajuste menor, puede convertirse en una operación intensiva en rendimiento. Motores de SQL como MySQL, PostgreSQL y SQL Server a menudo bloquean la tabla durante este cambio. Durante ese bloqueo, otras operaciones, como leer, escribir o actualizar, pueden retrasarse o fallar. Esto se convierte en una preocupación seria si estás trabajando en un sistema de producción en vivo, especialmente uno del que los usuarios dependen en tiempo real.
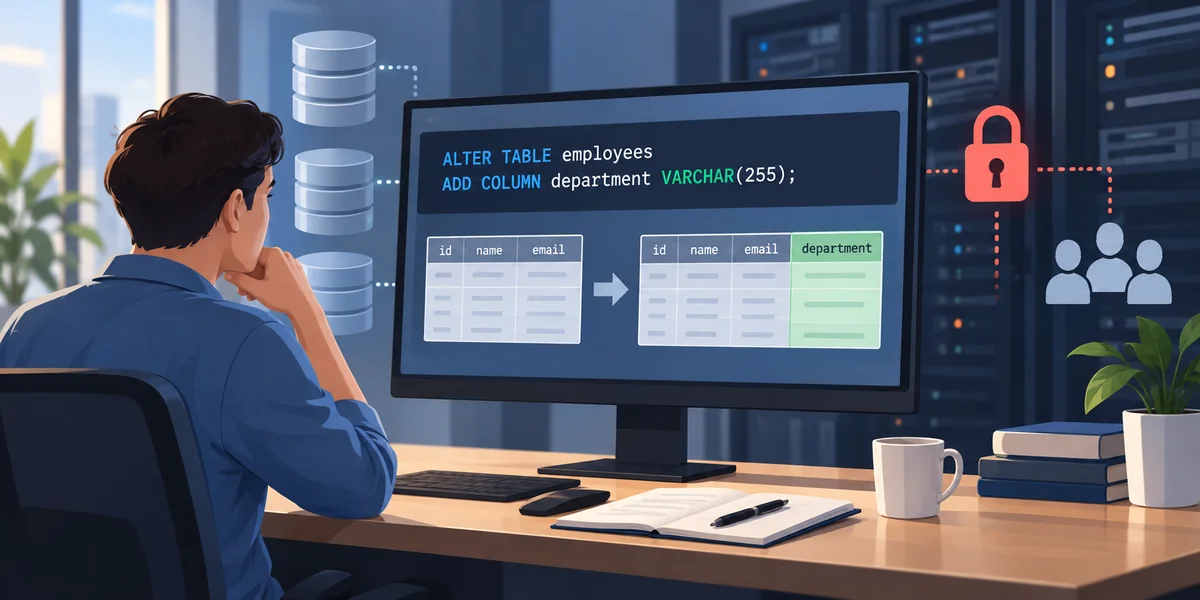
Imagina implementar tal cambio durante un tráfico pico. Tu aplicación podría congelarse, las transacciones podrían fallar, y tendrías que explicar a tu equipo por qué un pequeño cambio de esquema causó tiempo de inactividad. Por eso la planificación es crítica. Siempre prueba tus actualizaciones de esquema en un entorno de pruebas primero. Mide el tiempo que toma, verifica los efectos secundarios y organiza tus cambios inteligentemente, tal vez añadiendo la columna como nullable primero, llenándola gradualmente y aplicando restricciones más tarde.
El nombre también importa. No añadas nombres genéricos como info. Usa nombres que describan claramente los datos, como phone_number o user_status. Esto ayuda a tu equipo, y a tu futuro yo, a entender el esquema meses o incluso años después.
Restricciones, Valores por Defecto y Estrategia de Relleno
Ahora que sabes cómo añadir una columna en SQL, hablemos de restricciones. Podrías querer que esta nueva columna acepte solo valores no nulos o tal vez requerir que cada entrada sea única. Así es como lo harías:
ALTER TABLE users

ADD username VARCHAR(50) NOT NULL UNIQUE;
Pero hay un inconveniente. Si la tabla ya tiene datos, SQL no te permitirá añadir una columna NOT NULL sin un valor por defecto. ¿Por qué? Porque las filas existentes no cumplirían. La solución es permitir nulos o establecer un valor por defecto:
ALTER TABLE users

ADD status VARCHAR(20) NOT NULL DEFAULT 'active';
Este enfoque asegura que cada fila existente y futura tenga un valor válido en la nueva columna. Pero, ¿y si no puedes asignar un valor por defecto? Tal vez el valor necesita ser calculado. Ahí es cuando introduces una estrategia de relleno.
Digamos que estás añadiendo una columna full_name a una tabla que ya contiene first_name y last_name. Primero añadirías la columna permitiendo nulos:
ALTER TABLE users

ADD full_name VARCHAR(255);
Luego ejecutarías una actualización para llenar los espacios en blanco:
UPDATE users

SET full_name = CONCAT(first_name, ' ', last_name);
Una vez hecho, si estás seguro de que cada fila tiene un valor, puedes modificar la columna nuevamente para que sea NOT NULL:
ALTER TABLE users

MODIFY full_name VARCHAR(255) NOT NULL;
Este enfoque escalonado asegura que no rompas nada a mitad de camino y te da control sobre cómo y cuándo se actualizan los datos.
Añadiendo Columnas Sin Perder la Integridad de los Datos
Añadir una nueva columna en SQL parece inofensivo, pero si se hace sin planificación, puede introducir errores silenciosos o incluso romper tu aplicación. El motor de la base de datos se encarga del cambio estructural, pero depende de ti preservar la integridad de los datos. Eso significa que cada parte de tu aplicación, desde los formularios de entrada de datos hasta las consultas de backend, debe estar al tanto de la nueva columna. De lo contrario, el campo solo estará allí, sin usar, confundiendo a futuros desarrolladores y potencialmente causando errores difíciles de rastrear.
Una de las mejores formas de mantenerse organizado es a través del control de versiones. Herramientas como Flyway, Alembic y Liquibase te permiten gestionar cambios de esquema a través de scripts que son rastreables y repetibles. Esto es especialmente importante cuando trabajas en equipos donde varias personas están modificando la misma base de datos. Un proceso consistente asegura que todos sepan qué cambios se hicieron y por qué.
La documentación es otra práctica esencial. Un breve comentario en tu archivo de migración, una entrada en el registro de cambios o una nota de equipo explicando la razón de la nueva columna puede ser muy útil. La claridad ahora previene confusiones más tarde.
Y finalmente, siempre haz una copia de seguridad de tus datos antes de alterar el esquema. Incluso un pequeño cambio puede tener grandes consecuencias. Tener una copia de seguridad significa que puedes recuperarte rápidamente si algo no sale como se esperaba.
Conclusión
Añadir una columna en SQL puede parecer simple, pero tiene peso. Afecta la estructura de tu tabla, la lógica de la aplicación y la integridad general de los datos. Usar correctamente el comando ALTER TABLE, con una planificación cuidadosa en torno a los valores por defecto, restricciones y datos existentes, te ayuda a evitar problemas futuros. Ya sea que estés ampliando funciones o refinando tu esquema, tómate el tiempo para probar y documentar cada cambio. Una actualización bien planificada asegura que tu base de datos permanezca estable, eficiente y lista para soportar las necesidades en evolución de tu aplicación.
Artículos relacionados
Comandos TCL en SQL: Asegurando Transacciones Confiables e Integridad de Datos
Mejora tus Habilidades en Python: Las 7 Mejores Plataformas de Práctica en Línea
Los 10 Mejores Canales de YouTube para Dominar SQL a Tu Propio Ritmo

Usa Alias en SQL como un Profesional: No Más Consultas Desordenadas
Desbloqueando el Valor de las Claves Alternativas en Sistemas SQL
Vistas en SQL: Una Perspectiva Más Inteligente de Tus Datos
¿Qué es una Función Heurística en IA y Por Qué es Importante en la Búsqueda?

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
Cómo la IA está transformando las estrategias y procesos de marketing en 2025
El Poder de la IA en Conectar a las Personas con Información de Salud Confiable
Python para Análisis de Series Temporales: Calculando Promedios Móviles Fácilmente
Una Guía para Bloquear Celdas en Excel Fácilmente y Proteger tus Datos Efectivamente
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
