
Mejores Prácticas para el Almacenamiento en Aplicaciones de IA y Aprendizaje Automático
En esta página
El almacenamiento eficiente es clave para desbloquear todo el potencial de las cargas de trabajo de aprendizaje automático y IA. Con el rápido crecimiento de los datos, elegir las estrategias correctas asegura operaciones fluidas, procesamiento más rápido y ahorro de costos. Esta guía explora enfoques de almacenamiento simples y efectivos para ayudar a las empresas a optimizar el rendimiento, gestionar mejor los recursos y mantenerse al día con las demandas de las soluciones de IA.
Por Qué el Almacenamiento es Crítico para las Cargas de Trabajo de ML y IA
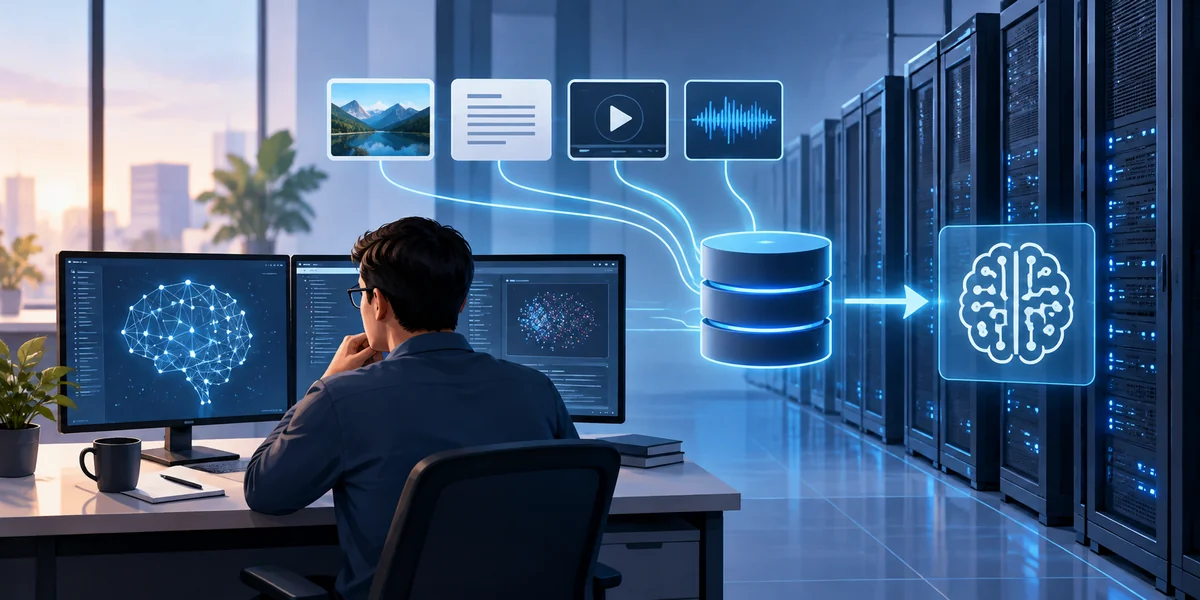
Los modelos de aprendizaje automático e IA prosperan con los datos, y muchos de ellos. Sin embargo, simplemente tener acceso a más datos no garantiza el éxito. La forma en que almacena, gestiona y accede a estos datos influye significativamente en la rapidez y precisión con la que los modelos pueden aprender.
El entrenamiento de algoritmos complejos requiere una alta accesibilidad a los datos junto con un rendimiento de entrada/salida rápido. La solución de almacenamiento necesita suficiente estabilidad para acomodar volúmenes extensos de datos y mantener un rendimiento constante durante las operaciones de procesamiento en vivo. Un sistema de almacenamiento inadecuado conduce a operaciones retrasadas, disminución del rendimiento del sistema y precisión comprometida del modelo.
Desafíos Comunes de Almacenamiento en IA y ML
Antes de sumergirnos en las estrategias, identifiquemos los desafíos relacionados con el almacenamiento que se encuentran en la mayoría de las aplicaciones de ML e IA.
- Escalabilidad: A medida que el volumen de datos crece de gigabytes a petabytes, las soluciones de almacenamiento a menudo luchan por escalar manteniendo la fiabilidad y la velocidad.
- Latencia: Unos pocos milisegundos pueden no parecer mucho, pero en operaciones de IA, la recuperación lenta de datos puede llevar a caídas significativas en el rendimiento.
- Eficiencia de Costos: Las opciones de almacenamiento de alto rendimiento son a menudo costosas, lo que significa que las limitaciones presupuestarias pueden llevar a compromisos en el rendimiento y la capacidad.
- Gestión de Datos: Los modelos de ML requieren datos estructurados y no estructurados que deben recuperarse, filtrarse y procesarse. Organizar conjuntos de datos tan diversos puede volverse complejo sin una arquitectura de almacenamiento adecuada.
- Redundancia y Respaldo de Datos: Con grandes conjuntos de datos, la redundancia puede significar la diferencia entre la resiliencia y el desastre, especialmente en proyectos críticos donde la pérdida de datos es inaceptable.
Principales Estrategias de Almacenamiento para IA y ML
Ahora que entendemos los desafíos, aquí hay algunas estrategias efectivas para optimizar el almacenamiento para las cargas de trabajo de aprendizaje automático e IA.
1. Usar Soluciones de Almacenamiento por Niveles
Diferentes etapas de las cargas de trabajo de aprendizaje automático demandan distintos niveles de velocidad de recuperación de datos. Dividir los datos en niveles de almacenamiento puede ayudar a equilibrar el costo y el rendimiento asignando datos frecuentemente accedidos a un almacenamiento más rápido (como SSDs) y archivando datos menos esenciales en opciones más lentas y asequibles (como HDDs o cintas).
- Nivel Caliente (Acceso Frecuente): SSDs basados en flash o NVMe para procesamiento en tiempo real.
- Nivel Templado (Acceso Moderado): HDDs de rendimiento medio para datos accedidos periódicamente.
- Nivel Frío (Acceso Raro): Unidades de cinta o almacenamiento de objetos en la nube para necesidades de archivo.
2. Priorizar Almacenamiento de Baja Latencia para Entrenamiento
El entrenamiento de modelos de aprendizaje automático requiere sistemas de almacenamiento de alta capacidad para manejar la constante lectura y escritura de datos durante los ciclos de entrenamiento. El almacenamiento conectado a la red (NAS) o sistemas de archivos paralelos compartidos como Lustre y BeeGFS proporcionan un acceso más rápido a los datos, mejorando significativamente la eficiencia del entrenamiento.
3. Aprovechar el Almacenamiento en la Nube para Flexibilidad
Los servicios de nube pública como AWS S3, Google Cloud Storage o Microsoft Azure Blob ofrecen opciones de almacenamiento flexibles y escalabilidad casi infinita. Los modelos de precios pay-as-you-go permiten a las organizaciones reducir los costos iniciales. Las herramientas de análisis impulsadas por la nube también mejoran la accesibilidad al almacenamiento para equipos de IA distribuidos.
Sin embargo, tenga en cuenta los costos de salida al extraer datos frecuentemente de la nube para cargas de trabajo de IA locales. Un modelo de nube híbrida podría resultar más rentable para muchas empresas.
4. Integrar Protocolos de Almacenamiento de Alto Rendimiento
Los protocolos de almacenamiento determinan cómo los sistemas acceden y usan los datos, por lo que optimizar estos componentes es crítico. La mayoría de los sistemas de ML de alto rendimiento usan protocolos como NVMe sobre Tejidos (NVMe-oF) o InfiniBand para un manejo de archivos ultra rápido y de baja latencia.
Transición de sistemas de archivos de propósito general a sistemas de archivos paralelos para un mayor rendimiento de E/S. Los sistemas de archivos paralelos permiten que múltiples operaciones accedan a los datos simultáneamente sin cuellos de botella del sistema.
5. Implementar Almacenamiento Secundario Optimizado para IA
La computación en el borde y las aplicaciones de IA se benefician de soluciones de almacenamiento secundario adaptadas al ML. Estas soluciones de almacenamiento pueden almacenar en caché flujos de trabajo de datos recientes cerca de las fuentes computacionales, reduciendo la latencia. Ejemplos de almacenamiento secundario incluyen soluciones de almacenamiento accesibles por GPU como WekaIO o VAST Data.
6. Organizar Datos con Metadatos
El etiquetado eficiente de metadatos permite a los equipos de aprendizaje automático etiquetar conjuntos de datos estructurados para una identificación y recuperación más rápida. Esto es especialmente valioso para equipos que gestionan conjuntos de datos diversos y aislados.
Herramientas automatizadas para la generación de metadatos, como Apache Atlas, pueden ayudar a agilizar el proceso mientras aseguran que los conjuntos de datos permanezcan buscables a través de las operaciones.
7. Priorizar Redundancia y Respaldo de Datos
A pesar de su naturaleza intensiva en cómputo, los esfuerzos de IA dependen en gran medida de la fiabilidad de los datos subyacentes. Asegúrese de hacer copias de seguridad regulares de los datos de entrenamiento e implementar métodos como instantáneas con sistemas de almacenamiento de datos redundantes para prevenir pérdidas catastróficas.
Mantenga al menos 3 copias de sus datos almacenadas en diferentes sistemas. Use proveedores de nube con características de respaldo integradas para datos calientes y fríos físicamente separados por región (geo-redundancia).
8. Planificar la Escalabilidad desde el Principio
Es tentador centrarse en las necesidades de almacenamiento a corto plazo, pero la escalabilidad siempre debe ser parte de la planificación a largo plazo, especialmente para equipos en crecimiento que gestionan conjuntos de datos en vivo.
Invierta en sistemas de almacenamiento que puedan crecer modularmente con sus necesidades, ya sea a través de escala vertical (añadiendo recursos a un sistema existente) o escala horizontal (distribuyendo cargas de trabajo a través de múltiples dispositivos).
9. Monitorear Costos con Modelos de Almacenamiento
Diferentes modelos de almacenamiento se adaptan a diferentes cargas de trabajo y pueden ahorrarle dinero a largo plazo. Por ejemplo, el almacenamiento en bloques es ideal para bases de datos, mientras que el almacenamiento de objetos es más adecuado para datos no estructurados como archivos multimedia. Muchos proveedores de nube ofrecen opciones más especializadas también, como almacenamiento de archivo de bajo costo.
Investigue cómo los diferentes métodos de almacenamiento pueden afectar sus operaciones y presupuesto. Además, vigile los patrones de uso de datos para optimizar la asignación de recursos y detectar cualquier anomalía que pueda indicar un gasto innecesario o posibles brechas de seguridad.
Tendencias Futuras en Almacenamiento para IA
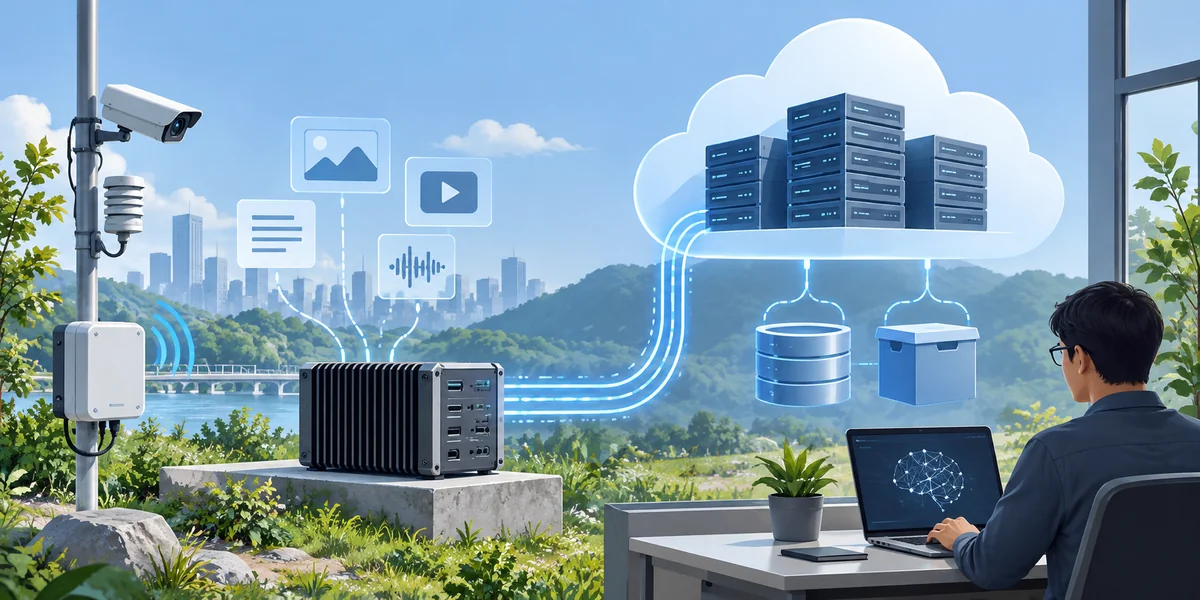
A medida que la tecnología continúa avanzando, la demanda de soluciones de almacenamiento avanzadas para IA también está aumentando. Aquí hay algunas posibles tendencias futuras en almacenamiento para IA:
- Computación en el Borde: Con el auge de los dispositivos IoT y la computación en el borde, se realizará más procesamiento de datos y entrenamiento de IA en estos dispositivos en lugar de depender únicamente de servidores centrales en la nube. Esto requerirá soluciones de almacenamiento que puedan almacenar y gestionar datos eficientemente en el borde.
- Computación en Memoria: La computación en memoria implica almacenar y procesar datos directamente en la RAM, eliminando la necesidad de recuperar datos de una ubicación de almacenamiento separada. Esto puede mejorar enormemente la velocidad y el rendimiento de las aplicaciones de IA, convirtiéndolo en una tendencia potencial en almacenamiento para IA.
- Infraestructura Hiperconvergente (HCI): La HCI combina almacenamiento, computación y redes en un solo sistema, lo que permite una gestión y escalabilidad más fáciles. Esto puede ser beneficioso para las aplicaciones de IA, ya que puede proporcionar un acceso y procesamiento de datos más rápidos.
Conclusión
Optimizar las estrategias de almacenamiento para las cargas de trabajo de aprendizaje automático e IA es fundamental para desbloquear todo el potencial de estas tecnologías. Al aprovechar los avances como la computación en memoria y la infraestructura hiperconvergente, las organizaciones pueden superar los cuellos de botella causados por métodos de almacenamiento tradicionales. Estos enfoques proporcionan una recuperación de datos más rápida, mejor escalabilidad e integración sin interrupciones, todo lo cual es esencial para manejar de manera eficiente los conjuntos de datos masivos requeridos para la IA y el aprendizaje automático.
Artículos relacionados

Cómo Utilizar un Generador de Voz de Marca AI para Preservar Voces Específicas de los Canales

Calidad de Datos en IA: 9 Problemas Comunes y Mejores Prácticas
El Futuro de la Inteligencia Empresarial: IA Modular para Empresas

12 Recursos Principales para Construir un Marco de IA Ética

Orquestando la IA: la Transición de Actos Solitarios a una Sinfonía Completa

Cómo Utilizar Generadores de Anuncios AI para Crear Campañas Publicitarias Personalizadas 5 Veces Más Rápido

Cómo la IA Puede Ser tu Compañero en Recursos Humanos para el Reclutamiento y Compromiso de Empleados
AI para SEO - 7 Consejos Poderosos para Integrar la IA en la Redacción de Contenido SEO

El Centro de Llamadas con IA Ya No es un Mito, Sino una Realidad: 6 Pasos para una Implementación sin Dolor

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal
Formas Inteligentes de Usar IA para la Optimización de Anuncios Móviles
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
