
BentoML: MLOps para Principiantes
En esta página
Desplegar modelos de aprendizaje automático (ML) en aplicaciones del mundo real puede ser un desafío. BentoML, un marco de código abierto, simplifica esto al automatizar el empaquetado, la escalabilidad y el servicio, reduciendo así el esfuerzo manual. Soporta múltiples modelos de ML, garantizando una implementación rápida y eficiente. BentoML proporciona un método consistente para el despliegue de modelos, permitiendo a los desarrolladores convertir modelos entrenados en servicios listos para producción con mínima codificación.
Facilita la escalabilidad y gestión al integrarse sin problemas con sistemas en la nube. Este artículo explora las características clave de BentoML, sus beneficios y técnicas básicas de despliegue. Ya seas principiante o tengas experiencia en MLOps, entender BentoML puede mejorar tu proceso. Al final, serás capaz de aplicar modelos de BentoML eficazmente sin experiencia previa en MLOps.
¿Qué es BentoML?
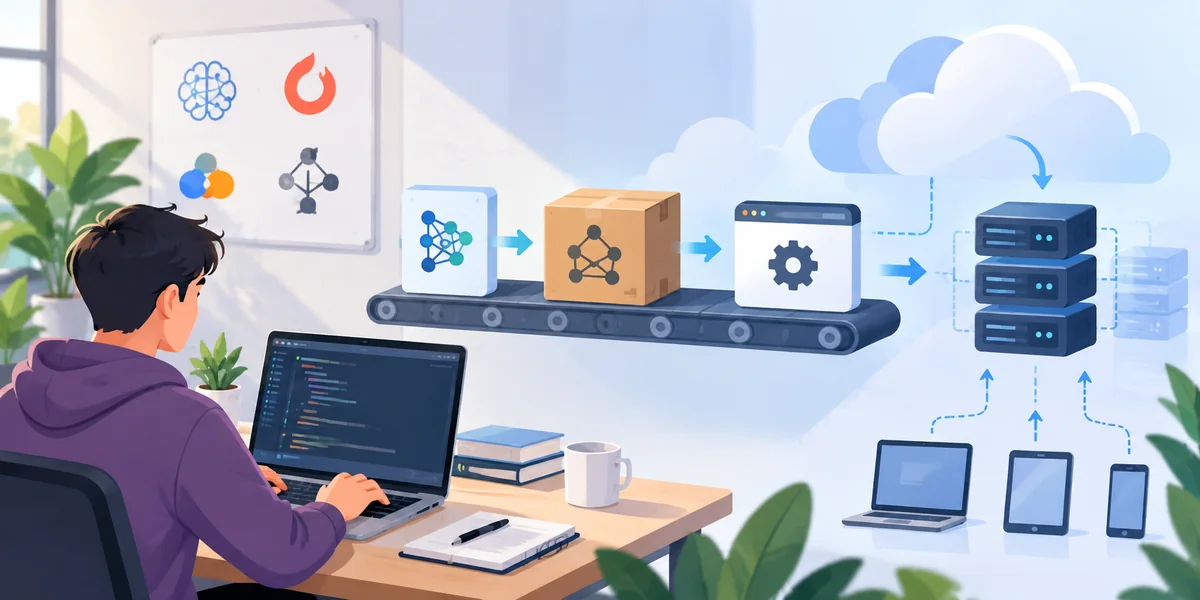
BentoML es un marco robusto diseñado para agilizar el despliegue de modelos de ML. Permite el desarrollo eficiente de paquetes, el servicio y la escalabilidad de modelos. A diferencia de los métodos de despliegue tradicionales, BentoML ofrece un enfoque consistente, asegurando un despliegue sin problemas en diversos entornos. Permite una fácil integración con populares marcos de ML como TensorFlow, PyTorch, Scikit-Learn y XGBoost sin alteraciones significativas. Esta adaptabilidad lo convierte en una opción destacada para procesos de MLOps. BentoML introduce BentoService, un paquete en contenedor que incluye el modelo, dependencias y configuraciones.
Este paquete proporciona escalabilidad y facilidad de gestión en plataformas como servidores locales y servicios en la nube. BentoML ayuda a los desarrolladores a reducir los tiempos de despliegue de semanas a minutos al automatizar procesos críticos, reducir el trabajo manual y simplificar la implementación de modelos. Sus capacidades de automatización, eficiencia y flexibilidad lo convierten en una excelente herramienta para equipos de MLOps, asegurando una transición fluida del desarrollo a la producción mientras mantiene la escalabilidad y fiabilidad.
¿Por Qué Usar BentoML para MLOps?
BentoML asegura que los modelos funcionen eficientemente en producción y simplifica el despliegue de modelos. Aquí hay varias razones clave para usar BentoML en MLOps:
- Fácil Empaquetado de Modelos: BentoML permite a los desarrolladores empaquetar modelos, incluyendo dependencias, configuraciones y código, asegurando consistencia a través de diferentes entornos. Elimina problemas de compatibilidad, simplificando y mejorando la eficiencia del despliegue.
- Servicio Rápido de Modelos: BentoML proporciona un servidor de modelos optimizado, asegurando baja latencia y excelente rendimiento para aplicaciones en tiempo real. Esto mejora significativamente los tiempos de respuesta y es ideal para aplicaciones que requieren inferencias rápidas.
- Despliegues Escalables: BentoML se integra con sistemas en la nube como Kubernetes para una escalabilidad sin problemas. Los modelos manejan efectivamente altos niveles de tráfico, asegurando operaciones de producción fluidas sin problemas de rendimiento o tiempo de inactividad. Ofrece escalado automático basado en la demanda.
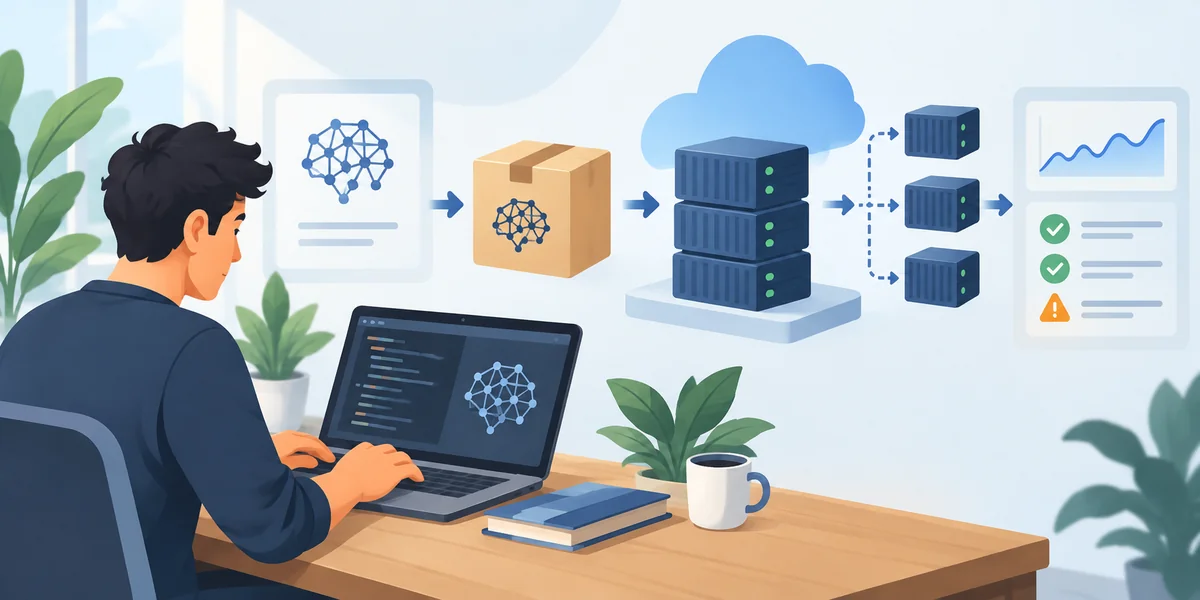
- Reproducibilidad y Monitoreo: BentoML simplifica la depuración al rastrear modelos, dependencias y configuraciones, asegurando la reproducibilidad. Incluye herramientas de monitoreo y registro para una efectiva gestión de versiones de modelos, ciclo de vida y rendimiento, mejorando la fiabilidad general del modelo.
Instalación y Configuración de BentoML
Antes de usar BentoML, necesitas instalarlo. Sigue estos pasos para comenzar:
Paso 1: Instalar BentoML
Instala BentoML y sus dependencias necesarias ejecutando el siguiente comando en tu terminal:
pip install bentoml
Paso 2: Verificar la Instalación
Ejecuta el siguiente comando para asegurarte de que BentoML esté instalado correctamente:
bentoml --help
Paso 3: Importar BentoML en Python
Inicia un script de Python e importa BentoML:
import bentoml
Desplegando un Modelo de Aprendizaje Automático con BentoML
Veamos los pasos para desplegar un modelo de ML usando BentoML.
Paso 1: Entrenar y Guardar el Modelo
Supón que tienes un modelo de Scikit-Learn entrenado. Usa BentoML para guardarlo.
import bentoml
from sklearn.ensemble import RandomForestClassifier

# Entrenar modelo
model = RandomForestClassifier()
model.fit([[1, 2], [3, 4]], [0, 1])

# Guardar modelo
bento_model = bentoml.sklearn.save_model("random_forest_model", model)
Paso 2: Crear un Servicio Bento
Define un servicio para cargar y servir el modelo.
from bentoml.io import JSON
from bentoml import Service, runners

# Cargar modelo
model_runner = bentoml.sklearn.get("random_forest_model").to_runner()

# Crear servicio
svc = Service("rf_service", runners=[model_runner])

@svc.api(input=JSON(), output=JSON())
def predict(data):
    return model_runner.predict.run(data["features"])
Paso 3: Ejecutar el Servicio Bento
Inicia el servicio usando el siguiente comando:
bentoml serve service.py
Escalando y Desplegando Modelos de BentoML
BentoML se adapta a diversas necesidades permitiendo el despliegue en múltiples plataformas.
1. Despliegue con Docker
Considera empaquetar tu modelo de aprendizaje automático como un contenedor Docker para un despliegue y escalabilidad fáciles.
bentoml containerize rf_service:latest
Luego, ejecútalo usando:
docker run -p 3000:3000 rf_service:latest
2. Despliegue con Kubernetes
Para proyectos a gran escala, utiliza Kubernetes al enviar el contenedor Docker a un registro de contenedores.
docker push your-docker-repo/rf_service:latest
A continuación, crea un archivo de despliegue de Kubernetes y aplícalo:
kubectl apply -f deployment.yaml
Mejores Prácticas para Usar BentoML
Maximiza los beneficios de BentoML siguiendo estas mejores prácticas:
- Mantén las Dependencias Mínimas: Incluye solo las bibliotecas necesarias para reducir el tamaño del paquete y mejorar el rendimiento. Las dependencias innecesarias complican los despliegues y ralentizan la ejecución.
- Usa el Control de Versiones: Rastrear múltiples versiones de modelos para asegurar la reproducibilidad y prevenir conflictos. El control de versiones te permite volver a versiones estables cuando sea necesario, manteniendo la consistencia.
- Optimiza para la Velocidad: Habilita la aceleración de hardware y usa arquitecturas de modelos eficientes para maximizar la velocidad de inferencia, mejorando la experiencia del usuario y reduciendo la latencia.
- Monitorea el Rendimiento: Revisa regularmente los tiempos de respuesta del modelo, latencia y uso de recursos. El monitoreo asegura actualizaciones oportunas y operaciones fluidas en producción.
- Protege tu API: Implementa autenticación y limitación de tasa para proteger contra el uso indebido y asegurar información sensible. Las medidas de seguridad efectivas mantienen la integridad del sistema.
Conclusión:
BentoML simplifica el despliegue de modelos de ML al manejar el empaquetado, servicio y escalabilidad con mínimo esfuerzo. Soporta diversos marcos, incluyendo TensorFlow, PyTorch y Scikit-Learn, asegurando una integración sin problemas. Con Docker y Kubernetes, puedes desplegar, servir y escalar modelos eficientemente. Al permitir un despliegue rápido y consistente, BentoML reduce la complejidad y el trabajo manual, permitiéndote enfocarte en desarrollar mejores modelos. Asegura consistencia, rapidez en el despliegue y eficiencia operacional mejorada. BentoML agiliza el despliegue de ML mediante automatización y adaptabilidad. Comienza a optimizar tu flujo de trabajo de servicio de modelos con BentoML hoy.
Artículos relacionados
Comprendiendo los Modelos Semánticos de Power BI para un Análisis Más Inteligente
Comprendiendo el Impacto de la IA en la Escritura Creativa
El Papel de la IA en el Análisis de Mercado y la Predicción del Comportamiento del Cliente
Integración de Creación y Colaboración GenAI Micro-Personalizada en tus Flujos de Trabajo y Datos
Estadísticas Prácticas: 10 Repositorios de GitHub que te Ayudan a Aprender
Reutilización de Contenidos con IA: 5 Formas de Reutilizar tu Contenido para un Impacto Máximo
Cómo la Representación del Conocimiento en la IA Construye Sistemas más Inteligentes
Clasificación de Imágenes en IA: Cómo las Máquinas Aprenden a Reconocer Imágenes
Perceptrón: El Pilar de las Redes Neuronales
Una Guía para Principiantes sobre Algoritmos de PLN y su Rol en la IA
Búsqueda en Haz Explicada: Decodificación NLP Más Inteligente para un Mejor Resultado de Texto
El Poder de la Clasificación de Texto: Cómo la IA Organiza la Información
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
