
Una Guía Completa sobre Desnormalización en Sistemas de Bases de Datos Modernos
En esta página
El rendimiento y la velocidad son cruciales en las aplicaciones impulsadas por datos, ya que determinan la efectividad de un sistema. Con el aumento de los volúmenes de datos y las demandas de los usuarios por acceso en tiempo real, los desarrolladores a menudo buscan más allá de la normalización tradicional de bases de datos para alcanzar objetivos de rendimiento. Una estrategia para mejorar el rendimiento es la desnormalización.
La desnormalización es una técnica ampliamente utilizada en la gestión de bases de datos, especialmente cuando los sistemas priorizan el rendimiento de lectura y la eficiencia en la generación de informes. Mientras que la normalización busca eliminar la redundancia de datos y promover la integridad, la desnormalización acepta un nivel de redundancia controlada para mejorar el rendimiento. Esta publicación ofrece una comprensión integral de la desnormalización, incluidos sus objetivos, ventajas, compensaciones y mejores prácticas para su implementación.
Comprendiendo la Desnormalización
La desnormalización implica introducir deliberadamente redundancia en una estructura de base de datos previamente normalizada para optimizar el rendimiento de consultas. Combina tablas o agrega campos de datos redundantes para reducir la complejidad de las consultas, especialmente en entornos intensivos en lectura.
Mientras que la normalización estructura los datos en múltiples tablas relacionadas para eliminar duplicaciones y asegurar la consistencia, la desnormalización fusiona o aplana las estructuras de datos. Este enfoque ayuda a reducir el número de uniones necesarias en las consultas, mejorando así la velocidad y la capacidad de respuesta del sistema.
Ventajas de la Desnormalización
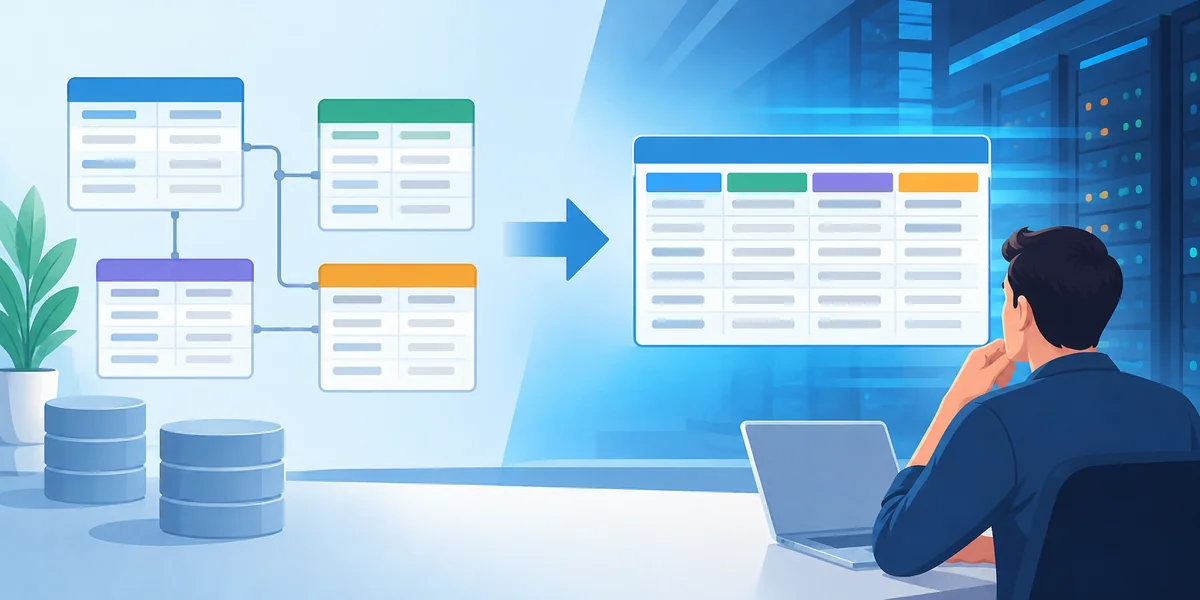
La desnormalización ofrece varios beneficios, haciéndola atractiva en sistemas críticos para el rendimiento. Estas son las principales ventajas:
Mejora del Rendimiento de Consultas
La desnormalización reduce la necesidad de uniones complejas al consolidar datos relacionados. Mejora significativamente el tiempo de respuesta de las consultas, especialmente al recuperar grandes conjuntos de datos o realizar operaciones de lectura frecuentes. Esto es particularmente beneficioso en aplicaciones con grandes volúmenes de datos y expectativas de rendimiento estrictas.
Lógica de Consultas Simplificada
Con menos tablas y dependencias reducidas, las consultas se vuelven más fáciles de escribir, mantener y entender. Los desarrolladores y analistas pueden crear consultas SQL más sencillas, lo que conduce a una mayor productividad y menor tiempo de depuración.
Menor Carga en la Base de Datos
Al minimizar el número de uniones y agregaciones durante las consultas, la desnormalización reduce la carga de procesamiento en el servidor de la base de datos. Esto conduce a una mejor utilización de los recursos, menos bloqueos y mejor concurrencia, especialmente durante períodos de alto tráfico.
Mejoras en Informes y Análisis
Las esquemas desnormalizados soportan una generación de informes más rápida al reducir la necesidad de agregaciones sobre la marcha. Los datos resumidos, totales o valores frecuentemente accedidos pueden almacenarse directamente dentro del esquema, permitiendo operaciones analíticas rápidas sin recalculaciones repetidas.
Acceso Más Rápido a los Datos
Las estructuras desnormalizadas hacen que los datos frecuentemente necesarios estén disponibles dentro de una sola tabla. Esto minimiza las operaciones de búsqueda y mejora el rendimiento para aplicaciones intensivas en lectura donde la velocidad es crítica.
Compensaciones y Consideraciones
Aunque la desnormalización proporciona claras ventajas de rendimiento, viene con compensaciones que deben evaluarse cuidadosamente. Una implementación incorrecta puede llevar a serios desafíos en la gestión de datos.
Aumento de la Redundancia
El inconveniente más evidente de la desnormalización es la duplicación de datos. Los datos redundantes pueden causar un aumento en el almacenamiento y aumentar el riesgo de inconsistencias, especialmente cuando los mismos datos se actualizan en múltiples lugares.
Mantenimiento de Datos Complejo
Mantener la consistencia de los datos en una estructura desnormalizada requiere un esfuerzo adicional. Las actualizaciones y eliminaciones deben propagarse cuidadosamente a través de campos redundantes para evitar discrepancias, aumentando la complejidad operativa de la base de datos.
Requisitos de Almacenamiento Más Altos
Almacenar datos redundantes aumenta el tamaño total de la base de datos. Aunque los costos de almacenamiento han disminuido con el tiempo, una gestión ineficiente de los datos puede tener implicaciones significativas en sistemas que manejan conjuntos de datos muy grandes.
Impacto en Operaciones de Escritura
La desnormalización puede afectar negativamente el rendimiento de escritura. Cada operación de inserción, actualización o eliminación puede requerir múltiples cambios en diferentes campos o tablas, resultando en tiempos de transacción más lentos y mayor latencia durante operaciones intensivas en escritura.
Riesgos de Inconsistencia de Datos
Sin mecanismos robustos de validación y sincronización, la desnormalización puede llevar a datos desfasados o inconsistentes. Esto es particularmente peligroso en sistemas donde los datos precisos son críticos para las operaciones o el cumplimiento.
Cuándo Usar la Desnormalización
La desnormalización no debe usarse indiscriminadamente. Es más beneficiosa cuando se aplica en entornos que cumplen las siguientes condiciones:
- Cargas de Trabajo Intensivas en Lectura: Los sistemas con muchas más lecturas que escrituras pueden beneficiarse significativamente de una complejidad de consultas reducida.
- Cuellos de Botella de Rendimiento: Si las uniones y agregaciones están ralentizando el rendimiento de las consultas, la desnormalización puede ayudar a agilizar las operaciones.
- Necesidades Complejas de Informes: Las aplicaciones que dependen en gran medida de informes y análisis a menudo se benefician de tablas resumen o valores pre-agregados.
- Acceso a Datos en Tiempo Real: En escenarios donde el acceso inmediato a los datos es esencial, como paneles o flujos en tiempo real, la desnormalización proporciona una recuperación más rápida.
- Patrones Frecuentes de Acceso a Datos: Si se accede repetidamente a datos específicos en el mismo formato, almacenarlos de manera redundante puede reducir la carga y aumentar la velocidad.
Es importante analizar los patrones de acceso a datos y los registros de consultas antes de implementar la desnormalización para asegurarse de que se alinea con las necesidades reales de rendimiento.
Técnicas para la Desnormalización
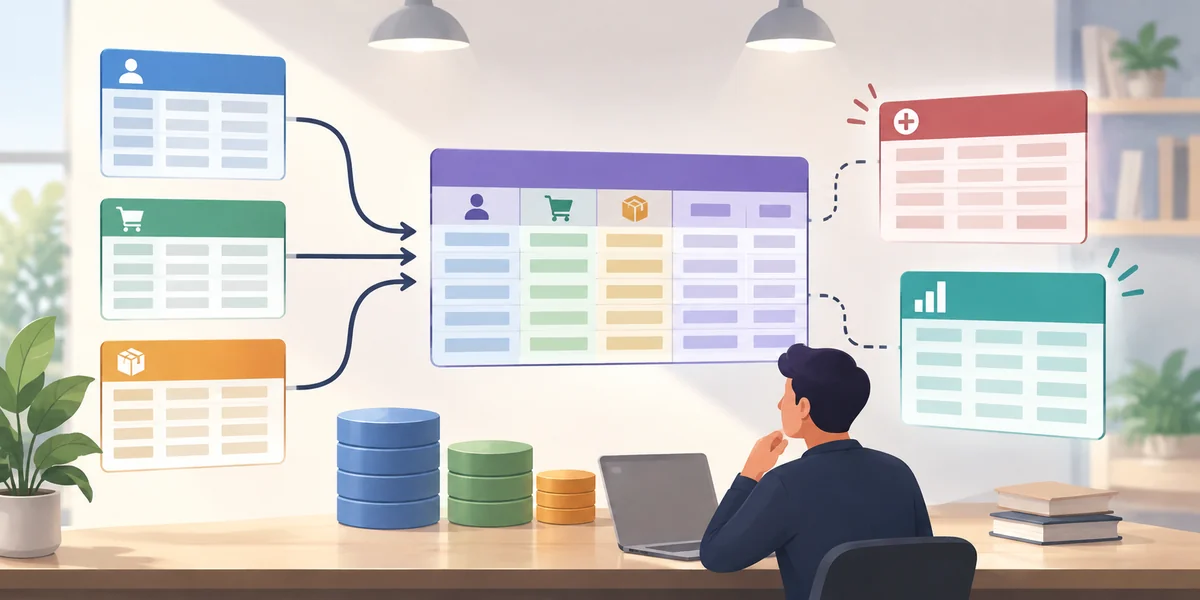
La desnormalización se implementa utilizando varios cambios estructurales y decisiones de diseño, dependiendo del esquema de la base de datos y los objetivos de rendimiento. Las técnicas comunes incluyen:
- Fusión de Tablas: Combinar tablas relacionadas en una para eliminar la necesidad de uniones.
- Agregar Columnas Redundantes: Almacenar valores frecuentemente accedidos o calculados dentro de una tabla para evitar el recálculo.
- Creación de Tablas Resumen: Tablas pre-agregadas que almacenan totales, promedios o recuentos para consultas más rápidas.
- Almacenar Datos Derivados: Incluir campos para métricas calculadas como porcentajes, clasificaciones o resúmenes estadísticos directamente en la base de datos.
Cada técnica debe elegirse en función de su impacto en el rendimiento, la mantenibilidad y la consistencia de los datos.
Conclusión
La desnormalización es una herramienta estratégica en el conjunto de herramientas del diseñador de bases de datos, particularmente al abordar problemas de rendimiento en entornos intensivos en lectura. Al introducir inteligentemente la redundancia, los desarrolladores pueden mejorar significativamente la velocidad de las consultas, simplificar los análisis y reducir la sobrecarga del sistema.
Sin embargo, debe implementarse con cuidado. Las compensaciones, como el aumento del mantenimiento, el almacenamiento y el riesgo de inconsistencias, requieren una comprensión clara de los requisitos del sistema y los patrones de uso. Cuando se aplica de manera reflexiva y se monitorea continuamente, la desnormalización puede transformar una base de datos lenta en un sistema de alto rendimiento adaptado a las demandas modernas.
Artículos relacionados

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
Cómo la IA está transformando las estrategias y procesos de marketing en 2025
El Poder de la IA en Conectar a las Personas con Información de Salud Confiable
Una Guía para Bloquear Celdas en Excel Fácilmente y Proteger tus Datos Efectivamente
Medir la Adopción e Impacto de la IA
Rompiendo Barreras Lingüísticas: El Papel de la IA en la Educación Multilingüe

La IA en la Educación: Abordando Desafíos Éticos en las Pruebas Estandarizadas
Construir un chatbot de IA que capture leads
3 Historias Inspiradoras de Líderes en IA
7 Mejores Estrategias (Además de los Portales de Empleo) para Conseguir Trabajos Bien Pagados en 2025
Análisis de Clúster en R: Descubriendo Estructuras de Datos Ocultas
Mejora la Seguridad del Hogar con Cámaras de IA y Herramientas de Detección Inteligente
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
