
¿Cuál es el límite de tokens de ChatGPT y cómo mantenerse dentro de él inteligentemente?
En esta página
ChatGPT se ha convertido en una herramienta ampliamente utilizada para escribir, aprender, proporcionar soporte y generar ideas. Sin embargo, a pesar de sus impresionantes capacidades, opera dentro de ciertos límites definidos. Uno de los más críticos es el límite de tokens. Esta restricción técnica regula cuánto input y output puede procesar el modelo en una sola interacción.
Comprender los límites de tokens es esencial para desarrolladores, empresas y usuarios cotidianos que buscan sacar el máximo provecho de ChatGPT. Las restricciones de tokens influyen en cuán detallada puede ser una pregunta, cuánto puede extenderse una respuesta y cuánta información el modelo retiene durante las interacciones en curso. La cuestión de si estos límites pueden ser excedidos se plantea a menudo, pero la realidad es más matizada.
Este artículo explica por qué los límites de tokens de ChatGPT importan, cómo difieren según el modelo y cómo los usuarios pueden trabajar dentro de estos límites para mantener el rendimiento y el contexto.
¿Por qué importan los límites de tokens?
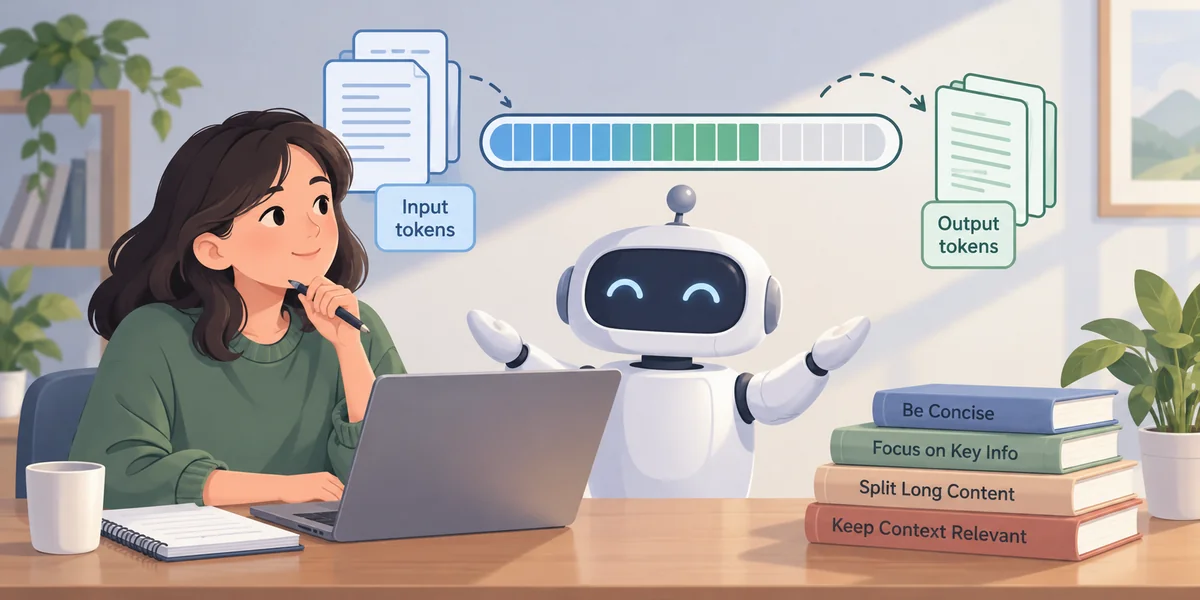
Los límites de tokens dictan cuánta información puede manejar el modelo a la vez. Incluye tanto:
- Los tokens del prompt (input)
- Los tokens de la respuesta (output)
Cada modelo de la familia GPT se construye con una capacidad máxima de tokens específica, que determina el número total de tokens—input más output—que pueden procesarse a la vez. Si un prompt es demasiado largo, el modelo puede no ser capaz de responder completamente, y si la respuesta misma se acerca al límite de tokens, puede ser cortada a media oración o devuelta incompleta. Ambos escenarios pueden reducir la calidad y utilidad de la interacción.
Comprender cómo funcionan los límites de tokens permite a los usuarios crear prompts más eficientes, establecer expectativas realistas y mantener la integridad de conversaciones más largas. Para los usuarios de la API, el uso de tokens también influye directamente en la facturación, ya que los cargos se calculan por cada 1,000 tokens utilizados.
Límites de tokens por modelo
Los diversos modelos de lenguaje de OpenAI vienen con un límite máximo de tokens predefinido, que representa el número total de tokens—tanto de entrada (prompt) como de salida (completion)—que pueden procesarse en una sola interacción. Esta restricción es fundamental para el funcionamiento de estos modelos, ya que afecta directamente su capacidad de memoria, profundidad de razonamiento y la complejidad de las respuestas que pueden generar.
Estos límites de tokens varían según el tamaño y las capacidades del modelo, así como la versión específica que se esté utilizando. Los modelos con mayor capacidad de tokens pueden manejar documentos más largos, conversaciones de múltiples turnos o razonamientos más detallados sin necesidad de truncar o restablecer el contexto. A continuación se presenta un desglose de los modelos más comúnmente utilizados y sus respectivos límites de tokens:
| Modelo | Tokens Máximos |
| Ada | 2,048 tokens |
| Babbage | 2,048 tokens |
| Curie | 2,048 tokens |
| DaVinci | 4,096 tokens |
| GPT-3.5 | 4,096 tokens |
| GPT-4 (versión 8K) | 8,192 tokens |
| GPT-4 (versión 32K) | 32,768 tokens |
| GPT-4-turbo | 128,000 tokens |
El límite de tokens representa el número total de tokens utilizados tanto en el prompt como en la respuesta. Por ejemplo, si un usuario envía un prompt de 1,500 tokens a GPT-3.5, el modelo puede generar hasta 2,596 tokens en respuesta antes de alcanzar el límite de 4,096 tokens.
Modelos más grandes como GPT-4-32K o GPT-4 Turbo son ideales para manejar documentos largos, conversaciones extendidas o instrucciones complejas. Elegir el modelo adecuado ayuda a garantizar interacciones fluidas sin encontrarse con cortes basados en tokens.
Límites de tokens de ChatGPT: ¿Se pueden superar y cómo trabajar dentro de ellos?
La respuesta corta y directa es no—los usuarios no pueden exceder el límite de tokens de un modelo en una sola interacción. Estos límites están firmemente establecidos dentro de la arquitectura del modelo de lenguaje. Una vez que el total combinado de tokens de entrada y salida se acerca al límite máximo designado para el modelo en uso, el sistema puede truncar la respuesta, devolver una respuesta parcial o incluso rechazar el prompt por completo si no se puede procesar dentro del límite de tokens.
Estos límites no son arbitrarios; existen para preservar la eficiencia computacional, asegurar un rendimiento confiable y prevenir el uso excesivo de memoria durante la inferencia. Cada modelo—ya sea GPT-3.5, GPT-4-8K o GPT-4-32K—está configurado para operar dentro de una ventana de contexto de tokens predefinida que equilibra el poder de procesamiento y la latencia.
Sin embargo, aunque los usuarios no pueden eludir o anular estas restricciones técnicas, existen estrategias prácticas para trabajar dentro o alrededor de los límites de tokens para tareas más largas o complejas:
- Dividir tareas grandes en interacciones más pequeñas y secuenciales: En lugar de pedir al modelo que analice o genere un bloque extenso de contenido en un solo prompt, los usuarios pueden dividir la solicitud en partes lógicas. Este enfoque modular mantiene la coherencia entre los prompts mientras se permanece dentro de los límites de tokens.
- Resumir o comprimir respuestas anteriores: Al mantener una conversación continua o retroalimentar información al modelo, las salidas previas pueden destilarse en resúmenes concisos. Esto reduce la carga de tokens y permite espacio para seguimientos más elaborados o una mayor elaboración.
- Aprovechar modelos con mayor capacidad de tokens: Para aplicaciones que requieren un contexto extenso—como contenido de formato largo, análisis de documentos o razonamiento de múltiples pasos—modelos como GPT-4-32K ofrecen ventanas de contexto significativamente más amplias. Con una capacidad de 32,768 tokens, estos modelos pueden manejar conversaciones mucho más largas y complejas sin la necesidad de segmentación constante.
Aunque estas soluciones no superan técnicamente los límites de tokens, proporcionan métodos viables para extender la funcionalidad, permitiendo a los usuarios continuar interacciones de alto contexto a lo largo de múltiples turnos. Efectivamente, permiten a los usuarios simular un mayor alcance de memoria y mantener la continuidad del tema sin romper las restricciones arquitectónicas del modelo.
Adoptando un enfoque estratégico para el diseño de prompts y la gestión de tokens, los usuarios pueden evitar interrupciones, preservar la calidad de las respuestas y desbloquear todo el potencial de ChatGPT, incluso dentro de los límites claramente definidos de tokens.
Conclusión
Los límites de tokens son una parte fundamental del funcionamiento de ChatGPT y otros modelos de lenguaje grandes. Aunque los usuarios no pueden exceder estos límites predefinidos, comprender cómo funcionan los tokens y cómo optimizar su uso puede mejorar significativamente la experiencia con la IA. Al seleccionar el modelo apropiado, crear prompts eficientes y gestionar el contexto estratégicamente, los usuarios pueden mantener interacciones de alta calidad incluso dentro de estos límites.
El sistema de tokens de ChatGPT puede parecer una barrera técnica, pero en realidad, proporciona el marco que hace posible un diálogo estructurado y receptivo. Con un uso informado, estos límites se convierten menos en un obstáculo y más en una guía para una comunicación significativa y eficiente.
Artículos relacionados
Límites de Longitud de Entrada de ChatGPT y Técnicas Inteligentes para Superarlos
5 Tareas de Codificación que ChatGPT No Puede Hacer
10 Extensiones de Chrome Imprescindibles que Potencian tu Experiencia con ChatGPT
Cómo usar ChatGPT de OpenAI para Escribir Correos Electrónicos de Negocios Automáticamente
Cómo Asegurar que las Respuestas de ChatGPT Permanezcan Justas e Imparciales
Cómo Construir un ChatGPT Personalizado Usando Tus Propios Datos y la API de OpenAI
9 Razones para Actualizar a ChatGPT Plus: ¿Vale la Pena?
¿Qué es ChatGPT Vision y para qué puedes usarlo?
¿Vale la Pena ChatGPT Plus? Los Verdaderos Pros y Contras
ChatGPT Search: Información sobre el revolucionario motor de búsqueda de OpenAI
Por qué la Herramienta de Voz a Texto de ChatGPT es un Cambio Revolucionario para la Productividad
Cómo la Función de Memoria de ChatGPT Mejora la Interacción Personal
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
