
Desbloqueando el Aprendizaje Automático con la Divergencia KL: Un Avance en Teoría de la Información
En esta página
El aprendizaje automático prospera en los patrones encontrados en las distribuciones de probabilidad. Pero, ¿cómo podemos medir qué tan cercanas están las predicciones de un modelo a la realidad? Ahí es donde entra la Divergencia KL, o Divergencia de Kullback-Leibler. Arraigada en la teoría de la información, es más que una fórmula: es una forma de medir cómo una distribución se desvía de otra. Ayuda a los modelos a reconocer la incertidumbre, ajustar predicciones y refinar el aprendizaje.
La Divergencia KL actúa como una brújula para la optimización, influyendo en todo, desde redes neuronales hasta IA generativa. Silenciosamente, se ha convertido en una herramienta fundamental en el aprendizaje automático moderno. Este artículo desglosa su significado, función e impacto duradero.
Entendiendo la Divergencia KL: El Corazón de la Comparación de Distribuciones
En su núcleo, la Divergencia KL es una medida de cómo una distribución de probabilidad se desvía de una segunda distribución de referencia. Piénsalo así: supongamos que crees que el pronóstico del clima predice un 70% de probabilidad de lluvia mañana. Pero el patrón climático real dice que solo hay un 40% de probabilidad. La diferencia entre lo que esperabas (tu modelo) y la realidad (distribución verdadera) crea una "brecha" informativa. La Divergencia KL cuantifica esa brecha.
Matemáticamente, la Divergencia KL se define para dos distribuciones, P (distribución verdadera) y Q (distribución predicha):
KL(P || Q) = Σ P(x) * log(P(x)/Q(x))
Esta ecuación nos dice cuán ineficiente es usar Q para aproximar P. No es simétrica, lo que significa que KL(P || Q) ≠ KL(Q || P). Eso es importante porque la Divergencia KL no mide solo "distancia" como las métricas euclidianas, se trata de pérdida de información. Cuando un modelo de aprendizaje automático intenta aproximar una distribución real usando una distribución aprendida, la Divergencia KL actúa como una señal de advertencia que dice: "Estás desviado, aquí está por cuánto".
También vale la pena mencionar que la Divergencia KL siempre arroja un valor no negativo. Cuanto más bajo sea el valor, más cercanas están las dos distribuciones. Una Divergencia KL de cero significa superposición perfecta: la distribución predicha coincide completamente con la verdadera.
El Papel de la Divergencia KL en los Modelos de Aprendizaje Automático
La Divergencia KL ocupa un lugar central en el aprendizaje automático moderno, especialmente en modelos que operan sobre distribuciones de probabilidad. Uno de sus roles más notables es en la Inferencia Variacional, donde ayuda a aproximar distribuciones posteriores complejas que de otro modo serían difíciles de calcular. Esta técnica es la base de los Autoencoders Variacionales (VAEs), un modelo generativo popular que aprende representaciones compactas de los datos de entrada.
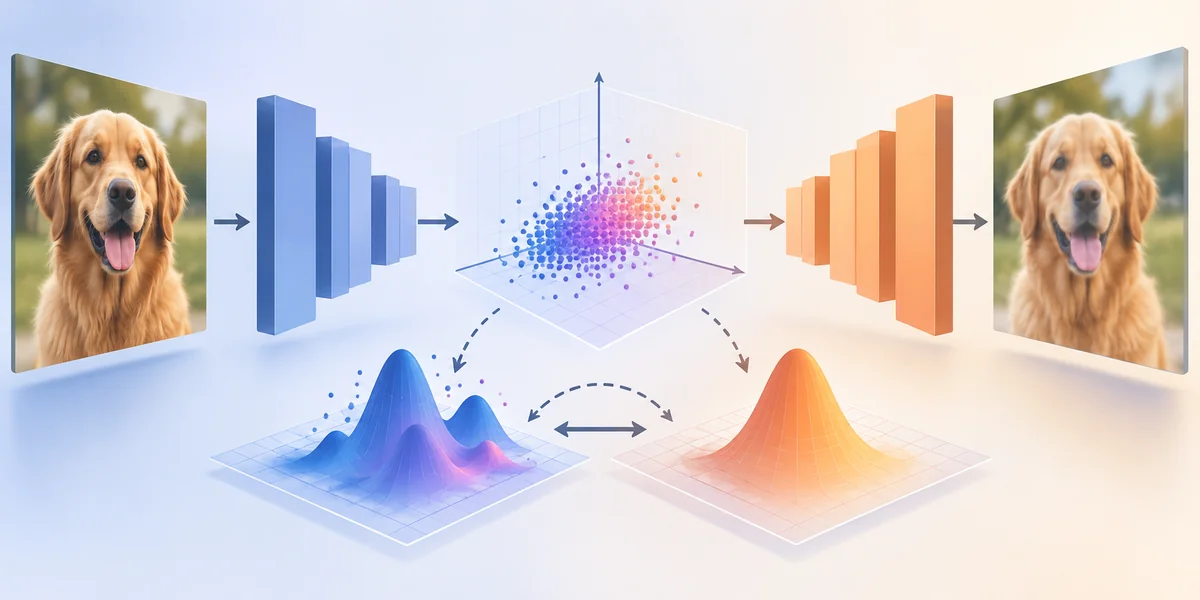
En un VAE, el codificador mapea los datos de entrada a un espacio latente mientras que el decodificador los reconstruye. Sin embargo, en lugar de permitir que el espacio latente se ajuste libremente, el modelo utiliza un término de Divergencia KL como penalización. Esta penalización fomenta que la distribución latente se mantenga cerca de una distribución previa más simple, generalmente una distribución normal estándar. Esto previene el sobreajuste y promueve una mejor generalización en nuevos datos.
La Divergencia KL también es fundamental en la regularización de modelos probabilísticos. En tareas como el modelado del lenguaje o la clasificación, los modelos a menudo predicen distribuciones de probabilidad sobre palabras o etiquetas. Minimizar la Divergencia KL entre estas predicciones y las distribuciones verdaderas agudiza la precisión y consistencia del modelo.
En el aprendizaje por refuerzo, la Divergencia KL desempeña un papel estabilizador. Algoritmos como la Optimización de Políticas Proximales (PPO) la utilizan para limitar la desviación entre políticas actualizadas y sus versiones anteriores, evitando cambios demasiado agresivos que pueden desestabilizar el aprendizaje.
Finalmente, en el aprendizaje automático bayesiano, la Divergencia KL mide qué tan de cerca se ajusta un posterior aproximado al posterior verdadero. Esto es especialmente útil en sistemas conscientes de la incertidumbre, donde las decisiones deben considerar los niveles de confianza, no solo los resultados. Ya sea para compresión, regularización o estabilidad, la Divergencia KL sigue siendo un mecanismo vital que guía a los modelos para aprender de manera más inteligente, confiable y con mayor conciencia de sus limitaciones.
¿Por Qué la Divergencia KL Sobresale Frente a Otras Métricas?
Existen muchas formas de medir las diferencias entre distribuciones, pero la Divergencia KL aporta algo único. A diferencia del error cuadrático medio (MSE) o la pérdida L1, que miden diferencias numéricas simples, la Divergencia KL comprende la estructura de la incertidumbre. Trata cada punto de datos como una pieza de una historia probabilística más amplia y penaliza a los modelos según cómo reconfiguran esa historia.
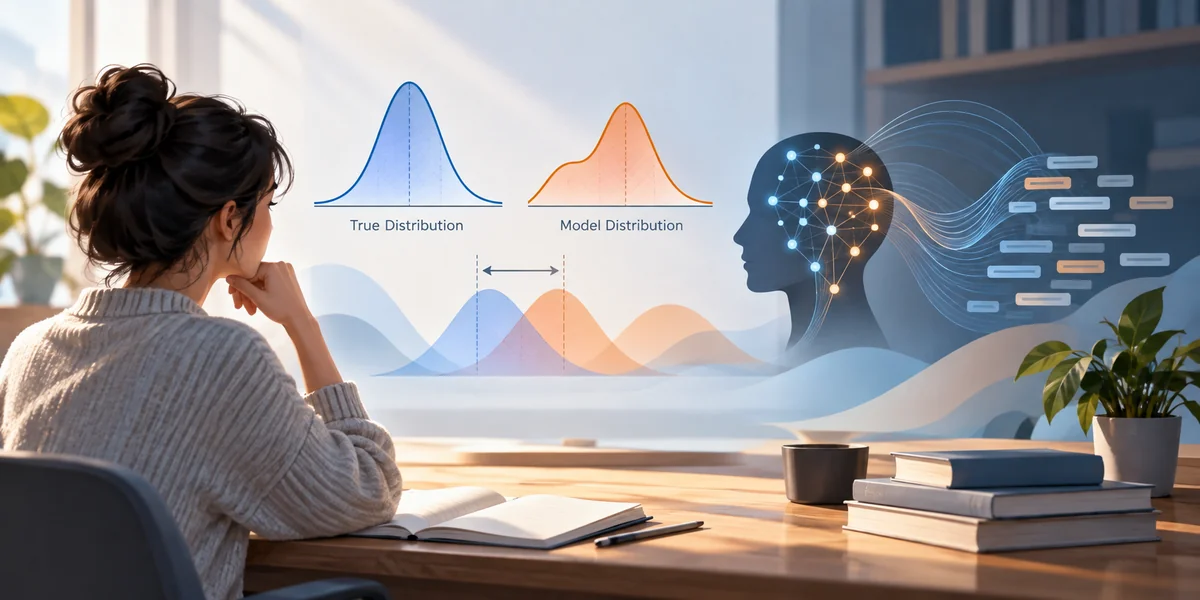
Esto la hace especialmente poderosa para aplicaciones donde la precisión en la probabilidad es crucial. Considera el modelado del lenguaje. Predecir la palabra correcta siguiente no se trata solo de elegir la palabra superior, se trata de distribuir la probabilidad entre palabras probables de una manera que imite el lenguaje natural. La Divergencia KL penaliza a los modelos que asignan alta probabilidad a palabras improbables y recompensa a aquellos que se alinean con patrones de lenguaje reales.
Otra fortaleza de la Divergencia KL es su uso en la ganancia de información. Responde a una pregunta fundamental: "¿Cuánta información extra necesito si uso la distribución Q en lugar de la distribución verdadera P?" Por eso es útil no solo en la evaluación de modelos, sino también en guiar la mejora del modelo.
Sin embargo, no está exenta de limitaciones. Debido a que la Divergencia KL es asimétrica, usarla ciegamente puede llevar a resultados confusos dependiendo de cuál distribución se trate como referencia. También se vuelve inestable cuando Q asigna probabilidad cero a resultados que P considera probables, lo que lleva a una divergencia infinita. Por eso, en la práctica se utilizan versiones suavizadas o modificadas de la Divergencia KL.
A pesar de esto, su impacto es inconfundible. A medida que el aprendizaje automático avanza hacia modelos más probabilísticos y conscientes de la incertidumbre, la capacidad de ajustar y guiar el entrenamiento a través de métricas como la Divergencia KL se vuelve no solo útil, sino necesaria.
Conclusión
La Divergencia KL no es solo una fórmula matemática, es un principio guía en el mundo del aprendizaje automático. Cuantificar cómo una distribución se desvía de otra ofrece a los modelos una forma de medir su comprensión de los datos y hacer correcciones cuando se desvían del curso. Ya sea impulsando modelos generativos profundos, ayudando a que las políticas evolucionen en el aprendizaje por refuerzo, o refinando inferencias probabilísticas, la Divergencia KL está en el núcleo de muchos avances en inteligencia artificial. Su capacidad para traducir la incertidumbre en información procesable la hace indispensable. A medida que el aprendizaje automático continúa evolucionando, el papel de la Divergencia KL solo será más central y significativo.
Artículos relacionados
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
Cómo Estimar el Tiempo y Costo de un Proyecto de Aprendizaje Automático
10 Libros Esenciales para Dominar el Procesamiento de Lenguaje Natural
Aprendizaje Personalizado con IA: Adaptando la Educación a Cada Estudiante
Transferencia de Aprendizaje: La Clave para que la IA Aprenda Más Rápido con Menos Datos
10 Grandes Libros Si Quieres Aprender Sobre Procesamiento de Lenguaje Natural
Comprendiendo el Álgebra Lineal y el Cálculo en Modelos de Aprendizaje Automático
Libros electrónicos gratuitos sobre Inteligencia Artificial para leer en 2025
Los Pros y Contras de Usar JavaScript para Aprendizaje Automático
5 CURSOS GRATUITOS sobre IA y ChatGPT para Llevarte de 0 a 100
El Poder de las Redes Generativas Adversariales (GAN): Un Análisis Profundo
Comprendiendo PyTorch: El Poderoso Marco para el Aprendizaje Profundo
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
