
Comprendiendo la Prueba de Turing y la Evaluación Moderna de la IA
En esta página
En 1950, Alan Turing planteó una pregunta que daría forma al futuro de la inteligencia artificial: ¿Pueden las máquinas pensar? Su respuesta fue la ahora famosa Prueba de Turing: una forma de juzgar la inteligencia de una máquina por su capacidad para imitar la conversación humana. Aunque fue revolucionaria en su momento, ahora la prueba se siente desfasada.
Los sistemas de IA de hoy generan respuestas similares a las humanas con facilidad, pero ¿significa eso que realmente entienden? La línea entre rendimiento e inteligencia se ha difuminado. En un mundo de redes neuronales y modelos de lenguaje grande, es hora de mirar más allá de la imitación y replantearnos cómo evaluamos lo que realmente significa para una máquina "pensar".
¿Qué Mide Realmente la Prueba de Turing?
La Prueba de Turing a menudo se malinterpreta. No prueba si una máquina puede pensar en el sentido humano. Verifica si una máquina puede simular respuestas similares a las humanas lo suficientemente bien como para engañar a alguien. Hay una gran diferencia entre realizar un acto convincente y poseer una comprensión real.
El poder de la Prueba de Turing radica en su simplicidad. Evita discusiones filosóficas profundas al centrarse únicamente en el comportamiento. Si una máquina puede simular una conversación humana, pasa la prueba. La prueba no pregunta cómo se derivan las respuestas, solo si son buenas. Valora el rendimiento sobre el proceso, lo que la convierte en un medio ordenado, aunque limitado, de evaluar la inteligencia artificial.
Pero ese también es el problema. Algunos sistemas pasan la Prueba de Turing eludiendo respuestas directas, desviando preguntas o simulando discursos emocionales vagos, estrategias que no indican una comprensión profunda. Este marco basado en el rendimiento puede premiar la imitación superficial, no la inteligencia real. Por eso la mayoría de los investigadores consideran ahora la Prueba de Turing como un comienzo, no un final.
¿Por Qué Ya No Es Suficiente?
La IA ha avanzado mucho más allá de lo que Turing imaginó. No solo estamos hablando con robots, estamos asignando tareas, resolviendo problemas y creando contenido con redes neuronales sofisticadas. Estos programas procesan datos de formas que los humanos nunca podrían. Sin embargo, aún no pueden percibir como lo hacemos nosotros. Carecen de creencias, emociones y conciencia, solo patrones y probabilidades.
La palabra clave principal — La Prueba de Turing — no captura esta complejidad. Es como juzgar un libro por lo bien que coincide con tu caligrafía en lugar de su contenido. La evaluación necesita ir más allá. Los investigadores ahora observan cómo los modelos razonan, si pueden generalizar a nuevos problemas y si muestran algún signo de sentido común, incluso en dominios estrechos.
Aquí es donde entran los puntos de referencia modernos. En lugar de preguntar, "¿Puede engañarme?", los evaluadores preguntan:
- ¿Puede la IA resolver un problema matemático que no ha visto antes?
- ¿Puede inferir detalles faltantes de un párrafo?
- ¿Puede manejar preguntas inesperadas?
Estos son desafíos más difíciles. Revelan lo que la Prueba de Turing oculta: que la imitación no es lo mismo que la inteligencia.
La prueba original de Turing se centró únicamente en la interacción basada en texto, ignorando la complejidad de la inteligencia del mundo real. Hoy en día, la IA navega por imágenes, sonidos y movimientos, mucho más allá de lo que la prueba mide. Captura solo una pequeña porción de capacidad en un entorno controlado, quedándose corta en una era donde la IA opera en entornos dinámicos como hogares, hospitales y dispositivos cotidianos.
Nuevos Métodos de Evaluación de la IA
Los investigadores ahora utilizan una amplia variedad de herramientas de evaluación, muchas de las cuales no intentan medir la "humanidad" en absoluto. En cambio, se centran en el rendimiento medible a través de tareas. ¿Qué tan preciso es el resultado? ¿Qué tan consistente? ¿Qué tan seguro?
Un cambio importante ha sido hacia los puntos de referencia basados en tareas. Estos conjuntos de datos presentan a la IA una variedad de desafíos, desde la traducción de idiomas y el reconocimiento de imágenes hasta acertijos lógicos y programación. El objetivo no es imitar a los humanos, sino completar tareas de manera eficiente y correcta, lo que hace que los resultados sean más fáciles de puntuar y comparar.
Otra técnica es la prueba de interpretabilidad. ¿Qué tan transparente es la toma de decisiones del modelo? Si proporciona una respuesta incorrecta, ¿podemos decir por qué? Un modelo de caja negra puede ser poderoso, pero es difícil de confiar. Los investigadores ahora se preocupan tanto por la explicabilidad como por la calidad del resultado.
La evaluación ética también está creciendo. No se trata solo de lo que la IA puede hacer, sino de lo que debería hacer. ¿El sistema refuerza el sesgo? ¿Puede ser engañado para producir contenido peligroso? Estas preocupaciones no formaban parte de la Prueba de Turing original, pero son vitales ahora.
Es importante destacar que muchas de estas pruebas son abiertas. No hay un umbral fijo que superar, como "engañar a un juez". Es un proceso continuo de refinamiento del rendimiento, adaptación a nuevos estándares e identificación de debilidades. La evaluación de la IA se ha convertido en un ecosistema vivo, no en una sola línea de meta.
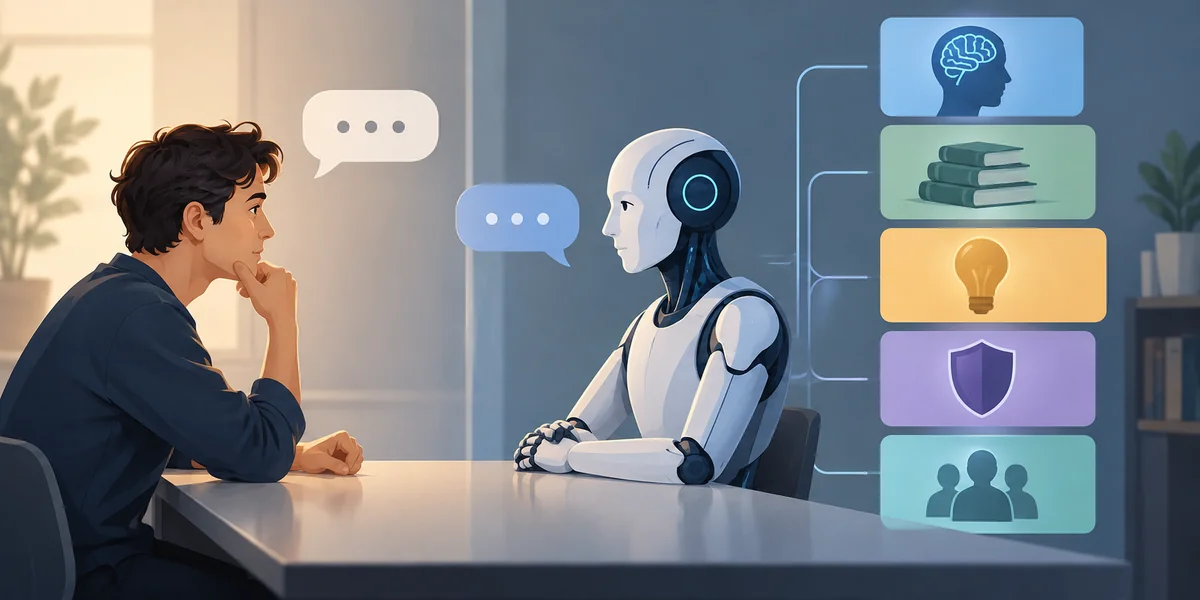
Mientras que la palabra clave secundaria—evaluación de la IA—aparece a menudo en estos círculos, se trata menos de una prueba específica y más de un cambio de mentalidad completo. Estamos aprendiendo que la inteligencia es en capas. No es binaria. Crece en fragmentos: razonamiento, memoria, creatividad, seguridad, y cada capa necesita su método de evaluación.
¿Hacia Dónde Vamos Desde Aquí?
La Prueba de Turing todavía tiene un valor simbólico. Nos recuerda que cómo se comporta un sistema puede importar al juzgar la inteligencia. Pero ya no es el punto de referencia que utilizamos para seguir el progreso de la IA. Ese papel ahora pertenece a formas más amplias y exigentes de evaluación de la IA.
Su simplicidad una vez la hizo poderosa. Pero esa misma elegancia puede haber estrechado nuestro pensamiento, centrando demasiado en la imitación y no lo suficiente en la comprensión más profunda. La IA moderna necesita más que una prueba de conversación.
Hoy en día, observamos cómo la IA razona, se adapta y se explica a sí misma. Una sola prueba ya no funciona. En cambio, necesitamos evaluaciones en capas, que cubran seguridad, transparencia, ética y rendimiento a través de tareas reales.
Entonces, la pregunta está cambiando. Ya no es "¿Pueden las máquinas pensar?" Ahora es "¿Podemos confiar en cómo piensan?" La Prueba de Turing todavía importa, solo que no de la manera que solía hacerlo.
Conclusión
La Prueba de Turing provocó una conversación vital sobre la inteligencia de las máquinas, pero la IA de hoy exige más. Aunque todavía tiene un valor simbólico, ya no es suficiente simplemente imitar la conversación humana. La evaluación moderna de la IA debe profundizar más, probando el razonamiento, la transparencia y el comportamiento ético. La inteligencia ahora se ve como algo en capas y complejo, requiriendo una variedad de herramientas para medirla adecuadamente. A medida que la IA continúa evolucionando, nuestros métodos para evaluarla deben evolucionar también, con confianza, equidad y comprensión real en el centro.
Artículos relacionados
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
Cómo la Representación del Conocimiento en la IA Construye Sistemas más Inteligentes
IA Tradicional vs IA Generativa
9 Grandes Beneficios de Usar IA en Tu Negocio Minorista
Más de 20 Prompts de Correo Electrónico con IA para Escribir Emails de Marketing que Generen Conversiones
El Papel de la IA en la Reducción de Costos de Marketing de Contenidos
Construyendo un Chatbot de IA: Una Guía Paso a Paso
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Más de 20 Prompts de Imágenes AI que Realmente Funcionan para Campañas de Marketing
10 Proyectos de ChatGPT en una Hoja de Trucos
Soluciones de IA Personalizadas vs. Productos Listos para Usar: Factores Clave a Considerar
¿Qué es Gemma? Explicación del modelo de IA de código abierto de Google
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
