
Esenciales de los Datos de Entrenamiento: Construyendo Mejores Modelos de Aprendizaje Automático
En esta página
Los datos de entrenamiento forman la columna vertebral de los modelos de IA y aprendizaje automático, asegurando su efectividad y precisión. Al proporcionar conjuntos de datos diversos y de alta calidad, estos sistemas pueden aprender patrones, hacer predicciones y mejorar con el tiempo. Sin datos de entrenamiento bien curados, el rendimiento de las aplicaciones de IA corre el riesgo de ser poco fiable, sesgado o incapaz de satisfacer las necesidades del mundo real.
La Base del Aprendizaje: Comprendiendo el Papel de los Datos de Entrenamiento
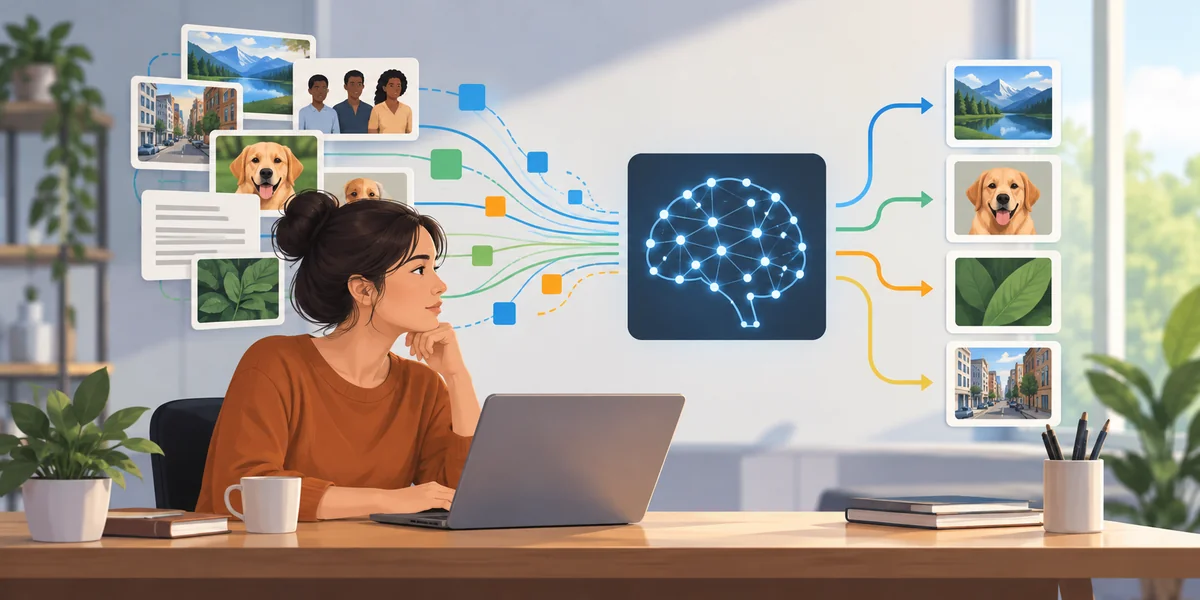
Los datos de entrenamiento son el conjunto inicial de ejemplos proporcionados a un modelo de aprendizaje automático para ayudarle a reconocer patrones, identificar relaciones y predecir resultados esperados. Al igual que los humanos aprenden a través de experiencias y repeticiones, los modelos de IA dependen de la exposición a información relevante y de alta calidad para construir su comprensión de tareas o problemas específicos.
Un modelo logra mejor precisión y fiabilidad en la identificación de su tarea cuando los datos de entrenamiento representan escenarios del mundo real con información diversa y exacta. Por ejemplo, un modelo entrenado en diferentes patrones de habla y acentos ofrecerá un mejor rendimiento en tareas de reconocimiento de voz en diversos grupos demográficos. Los datos de entrenamiento de baja calidad que contienen información incompleta o sesgada llevan a modelos que se vuelven inexactos y poco fiables, desarrollando también sesgos no intencionados. Estos problemas pueden llevar a disturbios menores y consecuencias severas, dependiendo del tipo de aplicación dirigida.
Sin datos de entrenamiento, el aprendizaje automático permanece meramente teórico, ya que los datos deciden directamente cómo se comportarán los modelos de inteligencia artificial cuando se pongan en práctica. La calidad, junto con la cantidad de ejemplos en los datos de entrenamiento, determina el éxito de los sistemas que logran objetivos equitativos junto con ser efectivos en su propósito diseñado.
La Calidad de los Datos Influye Directamente en el Rendimiento del Modelo
La frase "basura entra, basura sale" se aplica perfectamente al aprendizaje automático. Si un modelo se entrena con datos inexactos, incompletos o engañosos, sus predicciones y resultados serán defectuosos.
Los datos de entrenamiento de alta calidad aseguran:
- Precisión: El modelo hace predicciones correctas al analizar efectivamente los datos de entrada e identificar patrones, asegurando que los resultados se alineen estrechamente con los valores o etiquetas verdaderos.
- Generalización: El modelo se desempeña bien con datos nuevos y no vistos, demostrando su capacidad para aplicar el conocimiento aprendido del entrenamiento a diferentes conjuntos de datos y escenarios del mundo real, evitando el sobreajuste.
- Fiabilidad: El modelo entrega consistentemente resultados confiables en varios escenarios y condiciones, manteniendo el rendimiento bajo diferentes entradas y asegurando que los usuarios puedan confiar en sus resultados a lo largo del tiempo.
Por ejemplo, una IA de diagnóstico médico entrenada con datos de pacientes de alta calidad ofrecerá mejor asistencia a los médicos que una entrenada con registros inconsistentes o erróneos.
La Diversidad y Representatividad Previenen el Sesgo
El sesgo en la IA es un problema serio que puede llevar a resultados injustos o perjudiciales. A menudo, el sesgo no proviene del propio algoritmo, sino de los datos de entrenamiento utilizados.
Si los datos reflejan solo un segmento estrecho de la población o carecen de variación, el modelo de IA adoptará estas limitaciones. Los datos de entrenamiento diversos y representativos aseguran que los modelos sean justos, éticos y aplicables a una amplia gama de usuarios y situaciones.
Etiquetado y Anotación: Dando Significado a los Datos
Los datos en bruto por sí solos no son suficientes. Para métodos de aprendizaje supervisado, los datos deben estar etiquetados, lo que significa que cada entrada está asociada con la salida correcta. Este etiquetado guía al modelo para entender las conexiones correctas.
La anotación adecuada ayuda en:
- Enseñar a los modelos a distinguir entre categorías, como identificar si una imagen contiene un perro o un gato, ayuda a mejorar su capacidad para reconocer y clasificar datos visuales con precisión.
- Guiar a los modelos en la predicción, como diagnosticar enfermedades a partir de escaneos médicos, implica entrenarlos con datos etiquetados para identificar patrones y entregar resultados precisos que puedan ayudar en la toma de decisiones críticas.
- Mejorar la evaluación del modelo a través de puntos de referencia claros asegura pruebas y validaciones consistentes, ayudando a medir el rendimiento de un modelo de manera efectiva e identificar áreas para un mayor refinamiento.
Sin un etiquetado preciso, los modelos lucharán por aprender efectivamente, sin importar cuán sofisticado sea el algoritmo.
La Cantidad Importa, pero la Calidad Importa Más
Si bien grandes cantidades de datos a menudo son necesarias para modelos complejos, la cantidad por sí sola no garantiza el éxito. Un gran conjunto de datos lleno de errores, sesgos o información irrelevante puede ser más perjudicial que un conjunto de datos más pequeño y de alta calidad.
El mejor enfoque equilibra ambos:
- Suficientes datos para capturar la variabilidad y complejidad
- Datos de alta calidad que sean precisos, relevantes y representativos
Este equilibrio asegura que el modelo desarrolle un aprendizaje profundo sin sobreajuste o subajuste.
Los Datos de Entrenamiento Definen las Limitaciones del Modelo
Un modelo de IA solo puede operar dentro de los límites definidos por sus datos de entrenamiento. Si nunca encuentra una situación particular durante el entrenamiento, es poco probable que se desempeñe bien cuando se enfrente a ella en el mundo real.
Por ejemplo:
- Un modelo de predicción del clima entrenado solo con datos de climas templados puede fallar cuando se aplique a regiones tropicales.
- Un modelo de traducción automática de idiomas entrenado en texto formal puede tener dificultades con el habla informal o coloquial.
Por lo tanto, la selección y preparación cuidadosa de los datos de entrenamiento son vitales para asegurar la capacidad del modelo en sus aplicaciones previstas.
Actualizaciones Continuas de Datos: Mantener la Relevancia del Modelo
En muchos campos, los patrones de datos cambian con el tiempo. Las preferencias del consumidor, la dinámica del mercado e incluso el uso del lenguaje evolucionan. Los modelos entrenados con datos obsoletos rápidamente pierden relevancia y efectividad.
La actualización continua de los datos de entrenamiento permite a los modelos de IA:
- Adaptarse a nuevas tendencias y comportamientos
- Mejorar sus predicciones a lo largo del tiempo
- Evitar volverse obsoletos
Ciclos regulares de actualización de datos son esenciales para cualquier sistema de IA destinado a un despliegue a largo plazo.
Desafíos en la Adquisición de Datos de Entrenamiento de Calidad
Aunque la importancia de los datos de entrenamiento es clara, reunirlos y prepararlos puede ser desafiante. Algunos obstáculos comunes incluyen:
- Preocupaciones de privacidad de datos: Especialmente en campos sensibles como la atención médica y las finanzas
- Costos de etiquetado de datos: La anotación manual puede ser laboriosa y costosa
- Conjuntos de datos desequilibrados: Algunas clases o categorías pueden estar subrepresentadas
- Ruido y errores: Datos incorrectos o irrelevantes pueden corromper el entrenamiento
Abordar estos desafíos requiere inversión en estrategias de recopilación de datos, revisión experta y directrices éticas para el uso de datos.
Datos Sintéticos: Un Sistema de Apoyo Emergente
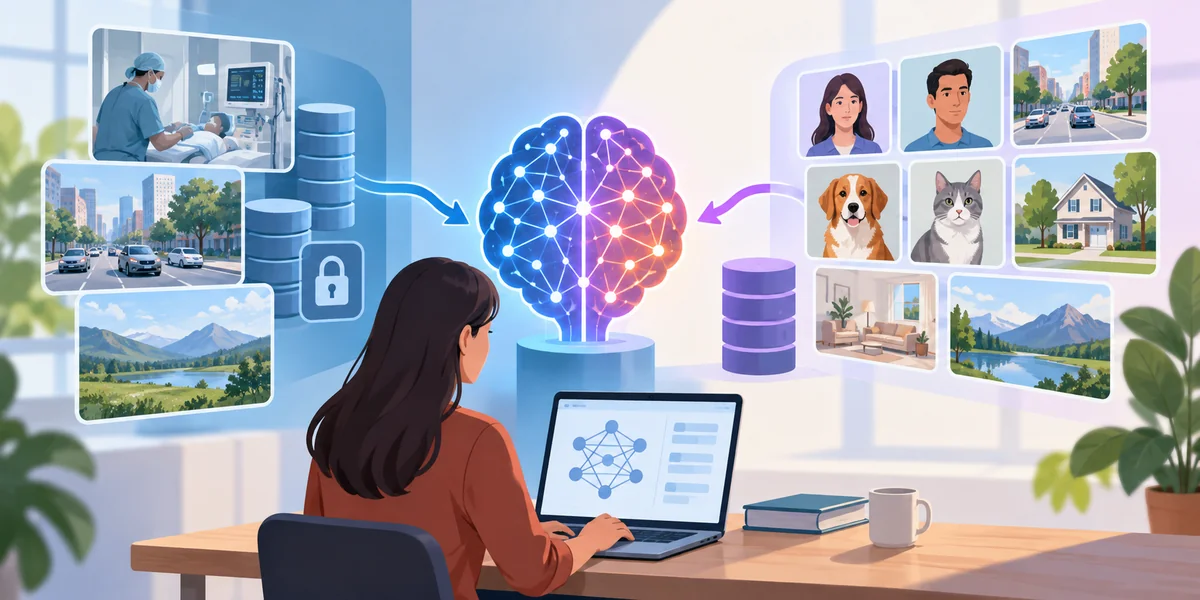
Cuando los datos del mundo real son limitados o difíciles de recolectar, los datos sintéticos pueden ayudar. Los datos sintéticos son información generada artificialmente que imita escenarios del mundo real sin comprometer la privacidad o enfrentar problemas de accesibilidad.
Los beneficios de los datos sintéticos incluyen:
- Ampliar el tamaño de los conjuntos de datos de entrenamiento
- Introducir escenarios raros o de casos límite para mejorar la robustez del modelo
- Mejorar la privacidad al evitar el uso de información personal real
Sin embargo, los datos sintéticos deben ser validados cuidadosamente para asegurar que representen con precisión los casos de uso previstos.
Conclusión:
Los datos de entrenamiento no son una idea de último momento, son la piedra angular de los sistemas exitosos de IA y aprendizaje automático. La calidad, diversidad, etiquetado y gestión continua de los datos de entrenamiento determinan directamente si un modelo tiene éxito o fracasa. Las organizaciones que buscan construir soluciones de IA confiables deben priorizar las inversiones en datos de entrenamiento de alta calidad tanto como invierten en algoritmos de vanguardia. Los datos no son solo un recurso, son el alma de la inteligencia artificial.
Artículos relacionados

12 Recursos Principales para Construir un Marco de IA Ética

Cómo Utilizar un Generador de Voz de Marca AI para Preservar Voces Específicas de los Canales

IA en el Blogging: Ventajas y Desventajas que Debes Conocer
3 Historias Inspiradoras de Líderes en IA

Orquestando la IA: la Transición de Actos Solitarios a una Sinfonía Completa

Cómo la IA Puede Ser tu Compañero en Recursos Humanos para el Reclutamiento y Compromiso de Empleados

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal

La IA en la Educación: Abordando Desafíos Éticos en las Pruebas Estandarizadas
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
Cómo la Representación del Conocimiento en la IA Construye Sistemas más Inteligentes
La Importancia de los Marcos Éticos de la IA para las Empresas Modernas
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
