
Domina la Clasificación de Texto Zero-Shot y Few-Shot Usando Scikit-LLM
En esta página
En el mundo impulsado por datos de hoy, las empresas y los desarrolladores a menudo se enfrentan al desafío de clasificar texto sin una gran cantidad de datos etiquetados. Los modelos tradicionales de aprendizaje automático dependen en gran medida de ejemplos anotados, lo que puede ser tanto lento como costoso de preparar. Aquí es donde entran en juego las técnicas de clasificación de texto zero-shot y few-shot.
Con Scikit-LLM, una innovadora biblioteca de Python, los desarrolladores pueden realizar tareas de clasificación de texto de alta calidad utilizando modelos de lenguaje extenso (LLMs) incluso cuando los datos etiquetados son limitados o inexistentes. Scikit-LLM se integra perfectamente con el popular ecosistema de scikit-learn, permitiendo a los usuarios construir clasificadores inteligentes con solo unas pocas líneas de código.
Esta publicación explora cómo Scikit-LLM facilita el aprendizaje zero-shot y few-shot para la clasificación de texto, destaca sus ventajas y proporciona ejemplos del mundo real para ayudar a los usuarios a comenzar con un esfuerzo mínimo.
¿Qué es Scikit-LLM?
Scikit-LLM es una biblioteca ligera pero poderosa que actúa como un puente entre los LLMs como el GPT de OpenAI y scikit-learn. Al combinar la estructura intuitiva de scikit-learn con el poder de razonamiento de los LLMs, Scikit-LLM permite a los usuarios construir avanzados flujos de trabajo de NLP utilizando indicaciones en lenguaje natural en lugar de datos de entrenamiento tradicionales.
Admite el aprendizaje zero-shot y few-shot permitiendo a los desarrolladores especificar etiquetas de clasificación o proporcionar un puñado de ejemplos etiquetados. La biblioteca maneja automáticamente la generación de indicaciones, la comunicación con el modelo y el análisis de respuestas.
Clasificación de Texto Zero-Shot vs. Few-Shot
Comprender la diferencia entre el aprendizaje zero-shot y few-shot es crucial antes de sumergirse en el código.
Clasificación Zero-Shot
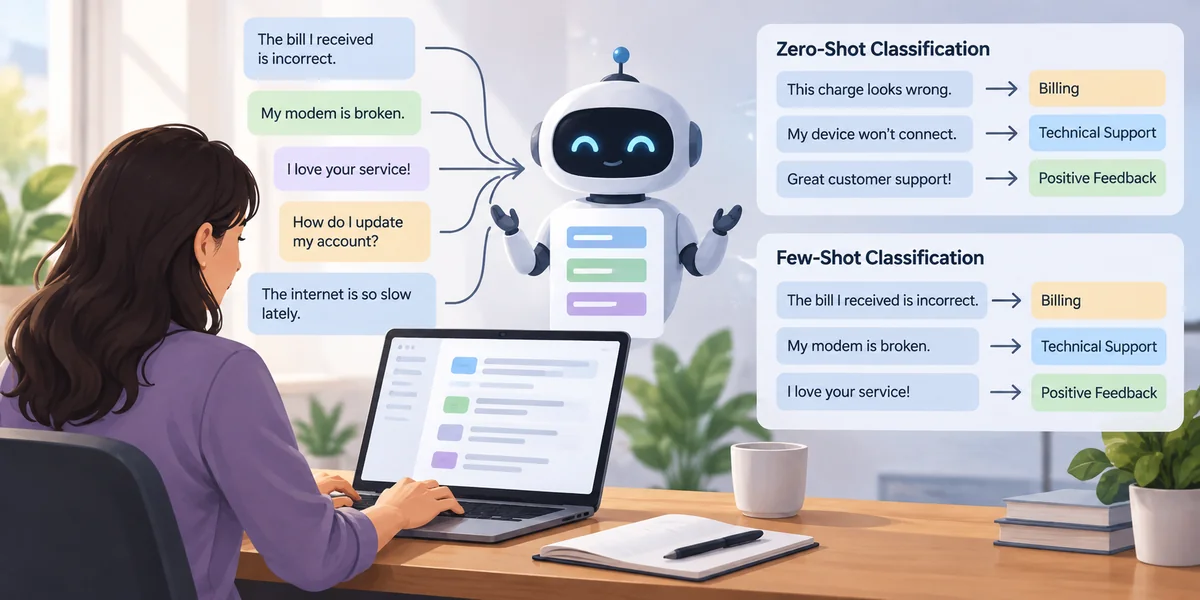
En clasificación zero-shot, el modelo no ve ningún ejemplo etiquetado de antemano. En su lugar, se basa completamente en los nombres de las categorías y su comprensión interna del lenguaje para predecir qué etiqueta se ajusta mejor al texto de entrada.
Por ejemplo, un modelo puede categorizar la frase “El internet no funciona” como “soporte técnico” sin ningún ejemplo previo. Aprovecha su conocimiento general del lenguaje y el contexto.
Clasificación Few-Shot
La clasificación few-shot implica proporcionar al modelo un pequeño conjunto de ejemplos etiquetados para cada categoría. Estas muestras guían al modelo para comprender mejor el tono y el contexto de cada etiqueta, mejorando la precisión.
Por ejemplo, al mostrarle al modelo ejemplos como:
- “La factura que recibí es incorrecta” – facturación
- “Mi módem está roto” – soporte técnico
El modelo puede clasificar mejor mensajes similares entrantes con mayor precisión.
Instalación de Scikit-LLM
Para comenzar a usar Scikit-LLM, necesitas instalarlo a través de pip:
pip install scikit-llmAdemás, necesitarás una clave de API de un proveedor de LLM compatible (como OpenAI o Anthropic) ya que la biblioteca depende de LLMs externos para procesar y generar respuestas.
Ejemplo de Clasificación de Texto Zero-Shot
Una de las características destacadas de Scikit-LLM es lo fácilmente que realiza la clasificación zero-shot. A continuación, se muestra un ejemplo básico que demuestra esta capacidad.
Código de Ejemplo:
from sklearn.pipeline import make_pipeline
from skllm.models.gpt import GPTClassifier

X = [
    "Gracias por la rápida respuesta",
    "Mi pago no se efectuó",
    "La aplicación sigue fallando en mi teléfono"
]

labels = ["elogio", "problema de facturación", "problema técnico"]
clf = GPTClassifier(labels=labels)
pipeline = make_pipeline(clf)
predictions = pipeline.predict(X)

print(predictions)
En este ejemplo, no se proporcionan datos de entrenamiento. El clasificador utiliza su comprensión de los nombres de las etiquetas y los textos de entrada para asignar la categoría más adecuada.
Ejemplo de Clasificación de Texto Few-Shot
Para refinar aún más el rendimiento del modelo, los desarrolladores pueden cambiar al aprendizaje few-shot agregando algunos ejemplos para cada categoría.
Código de Ejemplo:
examples = [
    ("Me encanta lo amable que es su equipo", "elogio"),
    ("¿Por qué me cobraron dos veces este mes?", "problema de facturación"),
    ("Mi pantalla se queda en negro después de abrir la aplicación", "problema técnico")
]

clf = GPTClassifier(labels=labels, examples=examples)
pipeline = make_pipeline(clf)

X = [
    "¡Realmente aprecio su ayuda!",
    "La tarifa de suscripción es demasiado alta",
    "No carga cuando presiono el botón de inicio"
]

predictions = pipeline.predict(X)

print(predictions)
Al proporcionar solo un ejemplo por etiqueta, el modelo obtiene una idea más clara de lo que representa cada categoría. Esta técnica a menudo resulta en mejores resultados en escenarios del mundo real.
¿Por Qué Usar Scikit-LLM para la Clasificación de Texto?
Scikit-LLM simplifica el uso de LLMs y ofrece numerosos beneficios para desarrolladores y empresas por igual.
Beneficios Clave:
- No se Requiere Entrenamiento: Los modelos pueden usarse instantáneamente sin necesidad de grandes conjuntos de datos de entrenamiento.
- Funciona con Datos Mínimos: Solo se necesitan unos pocos ejemplos para comenzar.
- Integración Perfecta: Se integra fácilmente en flujos de trabajo existentes de scikit-learn.
- Soporte Multi-Modelo: Compatible con LLMs populares como GPT, Claude y otros.
- Prototipado Rápido: Ideal para probar rápidamente nuevas ideas y aplicaciones.
Casos de Uso Comunes
Scikit-LLM puede aplicarse en diversas industrias y flujos de trabajo. A continuación, algunos casos de uso prácticos:
- Soporte al Cliente: Etiquetar o clasificar automáticamente los tickets de soporte entrantes.
- Monitoreo de Redes Sociales: Clasificar tweets o comentarios como positivos, negativos o neutrales.
- Categorización de Correos Electrónicos: Enviar correos a los departamentos adecuados (ventas, soporte, etc.).
- Análisis de Encuestas: Agrupar respuestas en temas sin etiquetado manual.
- Moderación de Contenido: Detectar y marcar contenido ofensivo o inapropiado.
Mejores Prácticas para Mejores Resultados
Aunque Scikit-LLM simplifica el proceso de clasificación, seguir algunas mejores prácticas puede ayudar a lograr resultados más confiables.
Consejos:
- Usar Etiquetas Claras y Distintas: Evitar etiquetas que se superpongan en significado.
- Escribir Ejemplos Concisos: Mantener los ejemplos few-shot cortos y directos.
- Limitar la Cantidad de Categorías: Demasiadas etiquetas pueden confundir al modelo.
- Permanecer Relevante al Dominio: Usar ejemplos y etiquetas relevantes para el dominio objetivo.
Desafíos y Consideraciones
A pesar de su facilidad de uso, Scikit-LLM tiene algunas limitaciones que los usuarios deben tener en cuenta:
- Dependencia de APIs Externas: Requiere acceso a Internet y claves de API para LLMs.
- Costo de Uso: Las llamadas a la API pueden incurrir en cargos, dependiendo del proveedor.
- Tiempo de Respuesta: Los tiempos de procesamiento pueden variar según el tamaño del modelo y los retrasos en la cola.
- Privacidad: Los datos sensibles deben manejarse cuidadosamente debido al uso de modelos externos.
Estos problemas pueden abordarse eligiendo el proveedor de modelo adecuado y siguiendo prácticas responsables de inteligencia artificial.
Conclusión
Scikit-LLM ofrece una forma moderna y eficiente de aprovechar el poder de los modelos de lenguaje extensos en flujos de trabajo de clasificación de texto. Al admitir tanto el aprendizaje zero-shot como few-shot, elimina la necesidad de grandes conjuntos de datos etiquetados y abre la puerta a soluciones rápidas, flexibles e inteligentes. Ya sea que el objetivo sea clasificar comentarios de clientes, analizar publicaciones en redes sociales u organizar tickets de soporte, Scikit-LLM permite a los desarrolladores construir poderosas herramientas de NLP con solo unas pocas líneas de código en Python. Su integración perfecta con scikit-learn lo hace accesible incluso para aquellos nuevos en el aprendizaje automático.
Artículos relacionados
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
