
Aprende 8 Técnicas de Segmentación que Mejoran la Recuperación en Sistemas RAG
En esta página
En los sistemas de Generación Aumentada por Recuperación (RAG), la calidad de la respuesta final depende en gran medida de cómo se recupera la información. Una parte crítica de este proceso es la segmentación: la forma en que los documentos se descomponen en piezas más pequeñas y buscables. Elegir la estrategia de segmentación adecuada puede mejorar significativamente la capacidad del sistema para recuperar datos relevantes y entregar respuestas más precisas.
Este artículo explora 8 estrategias de segmentación distintas utilizadas en los sistemas RAG. Cada método sirve a un propósito diferente según la estructura de los datos, la naturaleza del contenido y el caso de uso específico. Para desarrolladores e investigadores que trabajan en aplicaciones de recuperación de conocimiento o inteligencia artificial generativa, comprender estos métodos es clave para construir soluciones más inteligentes.
Por qué la Segmentación es un Paso Crucial en las Pipas RAG
La segmentación es el puente entre grandes bases de conocimiento y modelos de lenguaje. Dado que la mayoría de los sistemas RAG no procesan documentos completos de una vez, dependen de recuperar el "segmento" adecuado que contiene la respuesta. Un documento mal segmentado podría resultar en que el modelo pierda contexto importante o no entregue respuestas útiles.
Razones clave por las que la segmentación es importante:
- Determina qué tan bien se recuperan los datos relevantes.
- Afecta la claridad semántica y la completitud de las respuestas.
- Ayuda a gestionar los límites de tokens controlando el tamaño de entrada.
Al segmentar inteligentemente, los equipos pueden mejorar la eficiencia de recuperación, reducir alucinaciones y aumentar el rendimiento general de sus aplicaciones de inteligencia artificial.
1. Segmentación de Longitud Fija
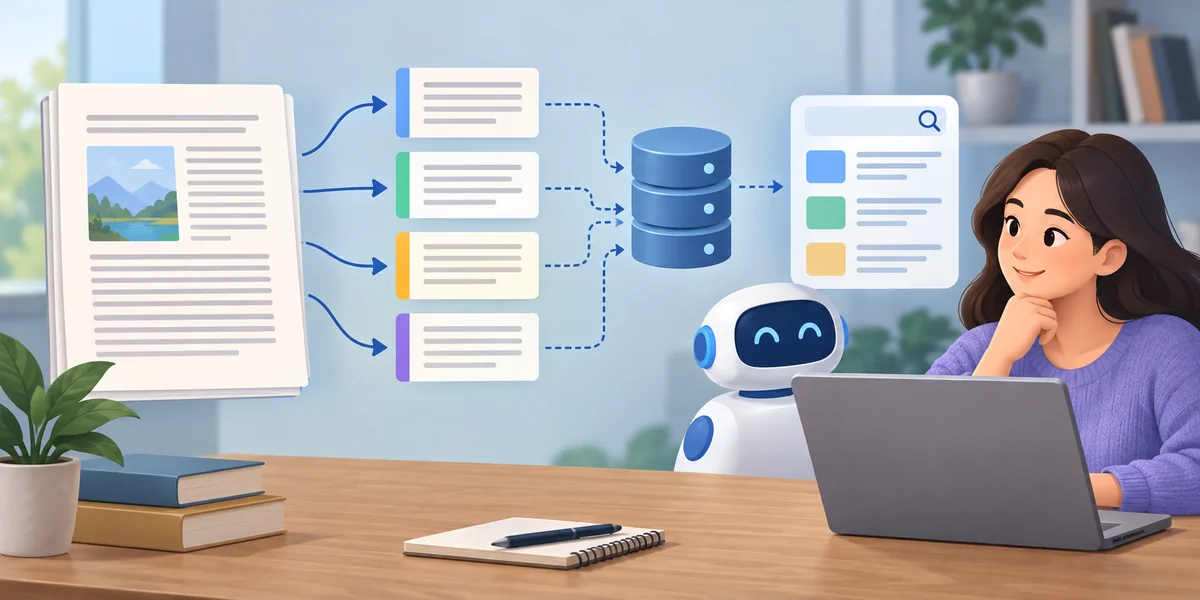
La segmentación de longitud fija es el enfoque más simple. Divide un documento en bloques de tamaño igual basados en el conteo de palabras, longitud de caracteres o límites de tokens.
Cómo funciona:
- El sistema divide el texto en partes fijas, como cada 300 palabras.
- No se presta atención al significado o estructura natural del texto.
Este método se utiliza a menudo para pruebas en etapas tempranas o conjuntos de datos uniformes.
Beneficios:
- Fácil de implementar en cualquier conjunto de datos de texto.
- Garantiza uniformidad en el tamaño de entrada.
Limitaciones:
- Puede cortar oraciones o ideas a la mitad.
- Reduce la coherencia y el contexto en algunos casos.
2. Segmentación Superpuesta
La segmentación superpuesta añade retención de contexto a los enfoques de longitud fija al permitir que partes de segmentos adyacentes se superpongan.
Cómo funciona:
- Una técnica de ventana se desliza a través del documento.
- Cada segmento comienza ligeramente antes de que termine el anterior.
Por ejemplo:
- Segmento 1: Palabras 1–300
- Segmento 2: Palabras 250–550
Garantiza que las oraciones de transición importantes no se pierdan en los límites.
Beneficios:
- Mantiene más información contextual entre segmentos.
- Reduce el riesgo de cortar ideas clave.
3. Segmentación Basada en Oraciones
La segmentación basada en oraciones respeta los límites de las oraciones para asegurar que cada segmento permanezca legible y semánticamente completo. Una ventaja importante es que mantiene intactas las ideas significativas, facilitando que los modelos RAG extraigan la información correcta.
Cómo funciona:
- Las oraciones se agrupan hasta alcanzar una cierta longitud, por ejemplo, 250–300 tokens.
- Los segmentos terminan solo en pausas de oraciones.
Beneficios:
- Preserva la gramática y el flujo de información.
- Funciona bien con documentos que contienen datos narrativos o conversacionales.
Limitaciones:
- Puede resultar en tamaños de segmentos desiguales.
- Requiere herramientas de análisis de oraciones como spaCy o NLTK.
4. Segmentación Semántica
La segmentación semántica utiliza el significado del contenido para formar segmentos, agrupando ideas o temas relacionados. Es especialmente útil para documentos densos o académicos. Un enfoque semántico se basa en herramientas de Procesamiento de Lenguaje Natural (NLP) como incrustaciones de texto, modelos de similitud o segmentación de temas.
Cómo funciona:
- El sistema detecta cambios de tema.
- Cada segmento contiene texto con un significado o tema unificado.
Beneficios:
- Alta relevancia durante la recuperación.
- Ideal para documentos con información rica o con capas.
Desventajas:
- Más complejo de implementar.
- Requiere recursos de cómputo adicionales.
5. Segmentación Basada en Párrafos
Muchos documentos están estructurados naturalmente en párrafos. Este método mantiene esos límites intactos, tratando cada párrafo o grupo de párrafos como un segmento. Es más útil cuando se trabaja con documentos como blogs, manuales o informes que ya tienen pausas lógicas.
Cómo funciona:
- El sistema utiliza caracteres de nueva línea o etiquetas para detectar párrafos.
- Cada párrafo se convierte en un segmento o se fusiona con los adyacentes para cumplir con los requisitos de longitud.
Beneficios:
- Coincide con los estilos de escritura humana.
- Simplifica la recuperación y el post-procesamiento.
Limitaciones:
- La longitud de los párrafos puede variar significativamente.
- No siempre es adecuado para aplicaciones con límites de tokens.
6. Segmentación Basada en Títulos
La segmentación basada en títulos utiliza la estructura del documento, como títulos y subtítulos (por ejemplo, H1, H2, H3), para guiar el proceso de segmentación. Este método es especialmente efectivo para contenido extenso y manuales técnicos. Esta técnica garantiza que cada segmento se centre en un solo tema o subtema.
Cómo funciona:
- El sistema escanea encabezados y agrupa el texto siguiente como un segmento.
- Las subsecciones se pueden dividir aún más según sea necesario.
Beneficios:
- Fácil de entender y navegar.
- Altamente relevante para documentos con temas anidados.
7. Segmentación Recursiva
La segmentación recursiva es un método flexible que intenta primero una segmentación de nivel superior y desciende solo si el segmento excede el límite de tamaño. Este enfoque en capas imita el comportamiento de lectura humano y mantiene una jerarquía limpia.
Cómo funciona:
- Comienza con los segmentos lógicos más grandes (títulos, secciones).
- Si son demasiado grandes, divídelos en más pequeños (párrafos o oraciones).
Beneficios:
- Adapta el tamaño del segmento según la estructura.
- Ayuda a preservar el contexto respetando los límites.
Casos de uso ideales:
- Bases de conocimiento
- Artículos académicos
- Informes de investigación
8. Segmentación Basada en Reglas o Personalizada
Cuando los documentos tienen patrones únicos, la segmentación basada en reglas se vuelve útil. Los desarrolladores definen reglas personalizadas para segmentar basadas en tipos de archivos o contenido específico del dominio.
Ejemplos:
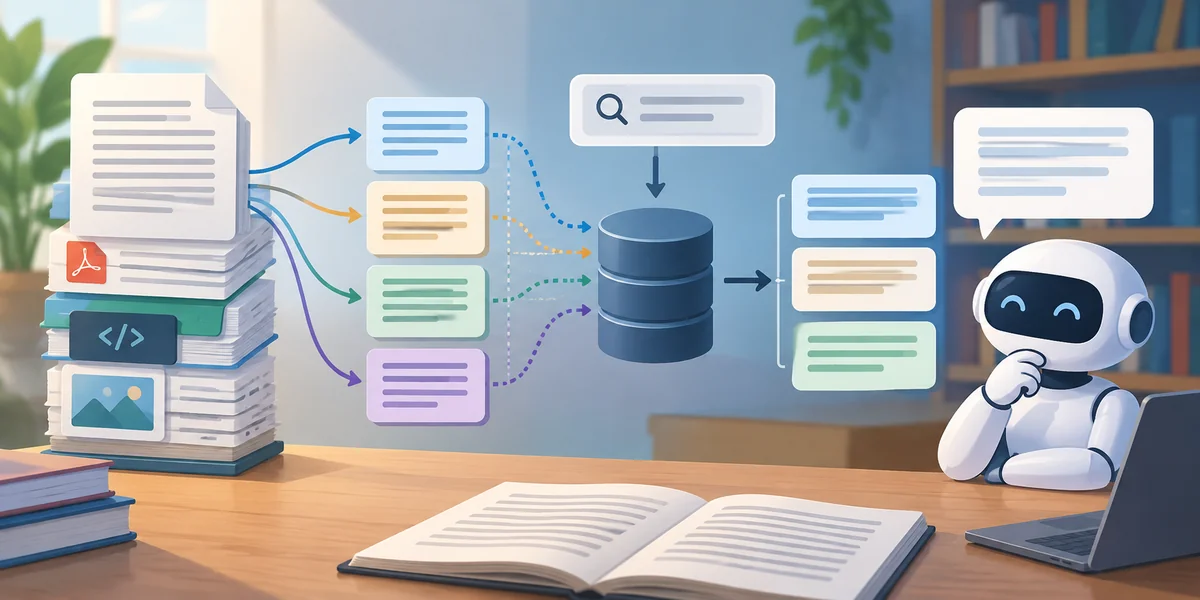
- Dividir transcripciones por marcas de tiempo.
- Dividir documentación de código por función o clase.
- Usar etiquetas HTML en páginas web para segmentar secciones.
Beneficios:
- Ofrece alta precisión.
- Funciona bien para sistemas específicos de dominio como datos legales, médicos o de programación.
Conclusión
La segmentación no es solo un detalle técnico, es un ingrediente clave que define el éxito de cualquier sistema RAG. Cada estrategia de segmentación aporta sus fortalezas, y la elección depende en gran medida del tipo de datos que se manejen. Desde los fundamentos de longitud fija hasta la precisión semántica o basada en reglas, los equipos pueden elegir o combinar métodos para adaptarse a sus objetivos de proyecto específicos. Los desarrolladores deben evaluar siempre el tipo de documento, los tipos de consultas esperadas y los requisitos de rendimiento antes de decidir sobre un método de segmentación. Al comprender y aplicar la técnica de segmentación correcta, las organizaciones pueden mejorar significativamente el rendimiento de recuperación, reducir errores en las respuestas y ofrecer resultados más precisos y similares a los humanos desde sus sistemas de inteligencia artificial.
Artículos relacionados
IA Tradicional vs IA Generativa
Usando IA para Combatir las Noticias Falsas Generadas por IA: Un Enfoque Más Inteligente
Cómo la Inteligencia Artificial está Transformando Sectores Tradicionales
Cómo Mejorar la Eficiencia de tu Servicio con Herramientas de IA y Automatización
IA en Agroalimentación: Transformando los Sistemas Agrícolas de África para un Crecimiento Inclusivo
La IA en la Verificación de Identidad: Prevención de Fraude y Seguridad de Datos
Cómo Asegurar que las Respuestas de ChatGPT Permanezcan Justas e Imparciales
Más de 20 Prompts de Imágenes AI que Realmente Funcionan para Campañas de Marketing
La IA Acaba de Cambiar las Reglas del Juego para la Estrategia de Precios
Soluciones Inteligentes de Tráfico: Cómo la IA Reduce la Congestión y Mejora la Seguridad
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
El Poder del Procesamiento de Imágenes: Cómo Transforma los Datos Digitales
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
