
Cargadores de Documentos Langchain: Potenciando la Entrada de Datos Fluida para LLMs
En esta página
Integrar datos en modelos de lenguaje de gran tamaño (LLMs) es más que cargar un documento; es un proceso estructurado. Los Cargadores de Documentos Langchain agilizan esto extrayendo texto limpio y utilizable de PDFs, HTML, archivos markdown, y más, convirtiendo contenido caótico del mundo real en un formato que los LLMs pueden procesar. Estos cargadores eliminan el ruido, conservan metadatos críticos y preparan el contenido para incrustación, fragmentación y consulta.
Sin ellos, enfrentarías la tediosa tarea de limpiar archivos manualmente o desarrollar analizadores personalizados para cada nueva fuente de datos. Si tu proyecto involucra recuperación, resumen, o preguntas y respuestas sobre documentos, estos cargadores son la columna vertebral silenciosa, asegurando que todo funcione sin problemas.
¿Qué Son Exactamente los Cargadores de Documentos Langchain?
Los Cargadores de Documentos Langchain son componentes modulares diseñados para ingerir y analizar documentos de varios formatos y plataformas en una estructura comprensible por los LLMs. No son simples lectores de archivos; están diseñados para la transformación de contenido. Cuando proporcionas un archivo o te conectas a una fuente (como Notion, Google Drive, o una página web), el cargador extrae el texto relevante, elimina el ruido y genera contenido estructurado como un objeto Documento.
El núcleo de cada Cargador de Documentos es su capacidad de manejo de contenido. El objeto Documento generalmente incluye no solo el texto principal sino también metadatos como el nombre del archivo de origen, marcas de tiempo o información del autor. Estos metadatos son vitales cuando tu sistema de IA necesita referenciar u organizar información contextualmente. Por ejemplo, en un sistema de generación aumentada por recuperación (RAG), conocer el origen de una oración puede ser tan crucial como la oración misma.
Langchain se destaca por su variedad y extensibilidad. Ofrece cargadores integrados para formatos comunes como PDF, CSV, y DOCX y conectores a APIs como Slack, Confluence, y Airtable. Si necesitas funcionalidades adicionales, puedes crear tu propio cargador subclasificando las clases base de Langchain.
¿Cómo Encajan los Cargadores de Documentos en el Pipeline de Langchain?
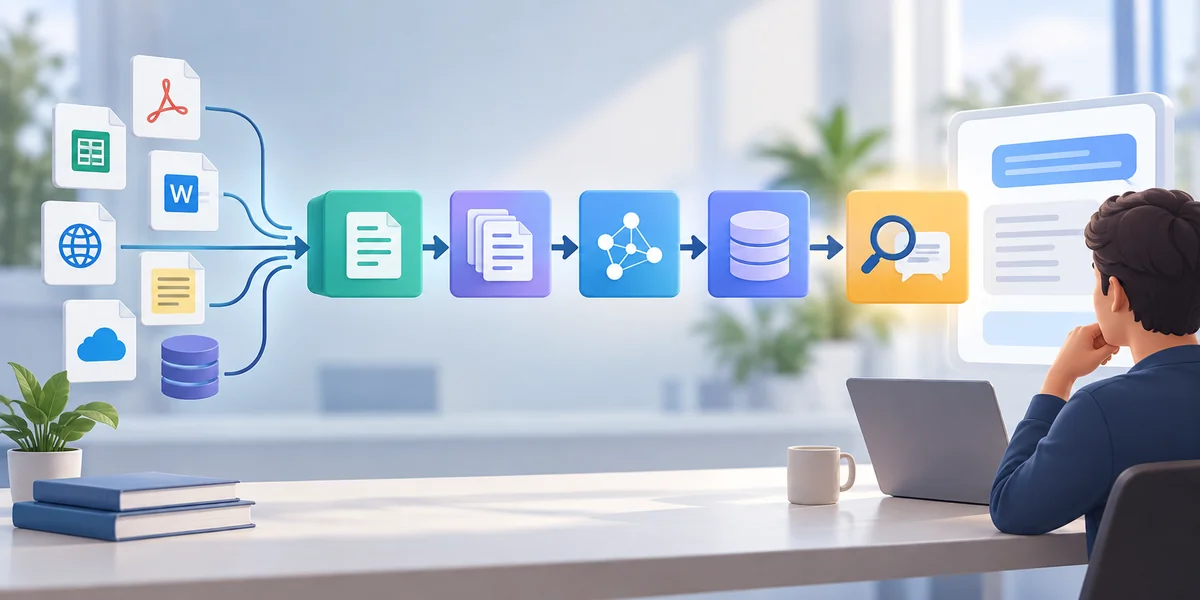
Los Cargadores de Documentos Langchain son el primer paso crítico en un pipeline estructurado de LLM. Convierten contenido bruto de varias fuentes—PDFs, páginas web, archivos markdown, unidades en la nube—en un formato que el sistema puede procesar. Este contenido fluye a través de una cadena:
Fuente de Contenido → Cargador de Documentos → Divisor de Texto → Incrustación → Almacén de Vectores → Recuperación y QA.
El rol del cargador es obtener y limpiar los datos. Un divisor de texto luego lo descompone en fragmentos digeribles, transformados en incrustaciones vectoriales—formatos matemáticos para comparación de contenido semántico. Estas incrustaciones se almacenan en una base de datos vectorial. Cuando un usuario envía una pregunta, el sistema recupera los fragmentos más relevantes de la base de datos y los envía al modelo de lenguaje para una respuesta.
Un cargador defectuoso puede interrumpir esta cadena. Si el texto analizado contiene formato roto o metadatos faltantes, el modelo podría alucinar o proporcionar respuestas fuera de tema, enfatizando la necesidad de confiabilidad del cargador.
Langchain también admite pipelines modulares y encadenables. Un cargador puede extraer contenido de Dropbox, pasarlo a una función de limpieza para quitar HTML, y luego enviarlo directamente a un almacén vectorial. Esta flexibilidad hace que Langchain sea ideal para escalar flujos de trabajo de IA centrados en documentos del mundo real.
Tipos de Cargadores de Documentos Disponibles en Langchain
Langchain proporciona una amplia gama de Cargadores de Documentos adaptados para diversas fuentes y formatos, permitiendo a los desarrolladores construir pipelines de IA adecuados para desafíos de datos del mundo real. Los cargadores de archivos principales incluyen TextLoader, PDFMinerLoader, UnstructuredPDFLoader, y CSVLoader, cada uno diseñado para manejar diferentes estructuras de archivos.
Los PDFs, por ejemplo, son a menudo complejos, con diseños de varias columnas, imágenes y notas al pie. Langchain aborda esto con cargadores que usan OCR o análisis nativo de PDF, permitiendo a los desarrolladores elegir entre velocidad y precisión de extracción.
Para contenido web, WebBaseLoader simplifica el proceso extrayendo texto limpio de URLs. Los cargadores basados en API como NotionDBLoader, SlackLoader, y ConfluenceLoader facilitan la extracción de datos estructurados de plataformas colaborativas.
Langchain también admite la ingestión basada en la nube. Cargadores como GoogleDriveLoader y S3DirectoryLoader permiten el procesamiento de grandes volúmenes de documentos almacenados en unidades en la nube, ideal para casos de uso de datos masivos como registros legales o archivos académicos.
Importante, el marco de Langchain está construido para la extensión. Los desarrolladores pueden crear cargadores personalizados extendiendo BaseLoader o BaseBlobLoader, adaptando el comportamiento a formatos de archivo únicos o APIs privadas. Esta flexibilidad garantiza que los Cargadores de Documentos Langchain puedan manejar cualquier fuente, haciéndolos indispensables en aplicaciones LLM centradas en documentos.
¿Por Qué los Cargadores de Documentos Langchain Son Importantes para Aplicaciones del Mundo Real?
Los Cargadores de Documentos Langchain son cruciales en aplicaciones de IA del mundo real, puenteando la brecha entre datos desordenados y no estructurados y la entrada estructurada que necesitan los modelos de lenguaje de gran tamaño. La mayoría de los documentos valiosos—como contratos escaneados, correos electrónicos reenviados, blogs con código incrustado, o transcripciones multilingües—raramente están limpios. Los Cargadores de Langchain gestionan esta complejidad analizando y estructurando contenido de una manera que los LLMs pueden entender.
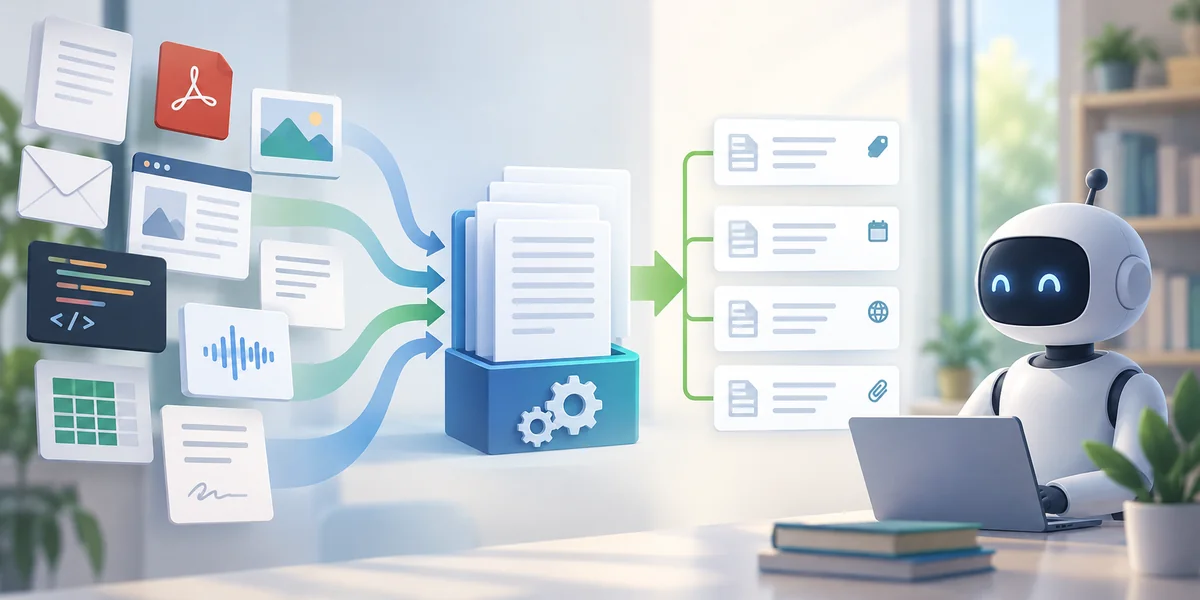
Por ejemplo, si estás desarrollando un asistente de soporte al cliente que extrae información de wikis en Markdown o páginas HTML exportadas, los cargadores de Langchain pueden aislar las secciones relevantes. En herramientas de investigación, manejan documentos científicos con ecuaciones, citas, y notas al pie. Esta precisión los hace indispensables en flujos de trabajo de alto valor y centrados en documentos.
Una ventaja significativa es la integración de metadatos. Cada documento analizado incluye contexto como su origen o marca de tiempo, apoyando la trazabilidad—una característica crítica para aplicaciones en campos de salud, finanzas o legales. Los cargadores también ahorran valioso tiempo de desarrollo. En lugar de escribir código de extracción personalizado para cada nueva fuente de datos, los equipos pueden configurar un cargador preconstruido o extender uno según sea necesario.
A medida que los LLMs demandan entradas de mayor calidad para un rendimiento confiable, los Cargadores de Documentos Langchain sirven como el primer y más crucial filtro, asegurando que todo lo que sigue se construya sobre datos sólidos y bien preparados.
Conclusión
Los Cargadores de Documentos Langchain son esenciales para preparar contenido bruto y no estructurado para modelos de lenguaje. Al convertir diversos formatos de archivo en datos limpios y estructurados, simplifican la construcción de sistemas de IA precisos y confiables. Ya sea tratando con PDFs, sitios web, o fuentes basadas en la nube, estos cargadores eliminan la necesidad de preprocesamiento manual y permiten un desarrollo más rápido y escalable. Son el paso crítico inicial en cualquier pipeline de LLM, asegurando que tu modelo siempre comience con una entrada de calidad.
Artículos relacionados
Mejores 6 LLMs para Codificación para Impulsar el Desarrollo de Software en 2025

Guía para Principiantes sobre la Integración de LLMs en tus Proyectos de Ciencia de Datos
IA Móvil de Próxima Generación: Cómo los LLMs Están Cambiando los Smartphones para Siempre
Los 6 Mejores Libros para Dominar la Generación Aumentada por Recuperación en IA
Mistral se Diferencia con Nueva API de OCR: Un Cambio de Juego en la Digitalización de Documentos
5 Maneras de Comenzar a Usar la IA en el Marketing
AI para SEO - 7 Consejos Poderosos para Integrar la IA en la Redacción de Contenido SEO
25+ Ideas de IA para Escribir Entradas de Blog Más Rápidamente
5 Mejores Ejemplos de Páginas de Aterrizaje y Cómo Crearlas con Creadores de Contenido AI
Los Mejores Editores de Fotos con IA
Los 7 mejores generadores de imágenes por IA en 2025
9 Herramientas de SEO con IA que Debes Probar en 2025
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
