
Cómo Bloquear el GPTBot de OpenAI para que No Extraiga el Contenido de tu Sitio Web
En esta página
A medida que las herramientas de inteligencia artificial se vuelven más potentes y extendidas, la demanda de datos de entrenamiento de alta calidad ha crecido dramáticamente. OpenAI, la organización detrás de ChatGPT, utiliza un rastreador llamado GPTBot para recopilar datos web públicos que ayudan a mejorar el rendimiento de sus modelos. Sin embargo, no todos los propietarios de sitios web están cómodos con que su contenido sea accedido, indexado o reutilizado por sistemas automatizados.
Si eres un editor, bloguero, propietario de negocio o desarrollador que prefiere mantener un control estricto sobre su contenido web, puedes estar buscando una forma de detener a los bots de OpenAI para que no rastreen tu sitio. Afortunadamente, existen métodos claros y efectivos para hacerlo.
Este artículo te guiará a través de todo lo que necesitas saber sobre cómo bloquear el rastreador web de OpenAI para que no acceda a tu sitio, incluyendo qué es GPTBot, por qué recopila datos de la web y cómo puedes evitar que acceda a tu propiedad digital.
Bloqueo de GPTBot Usando robots.txt
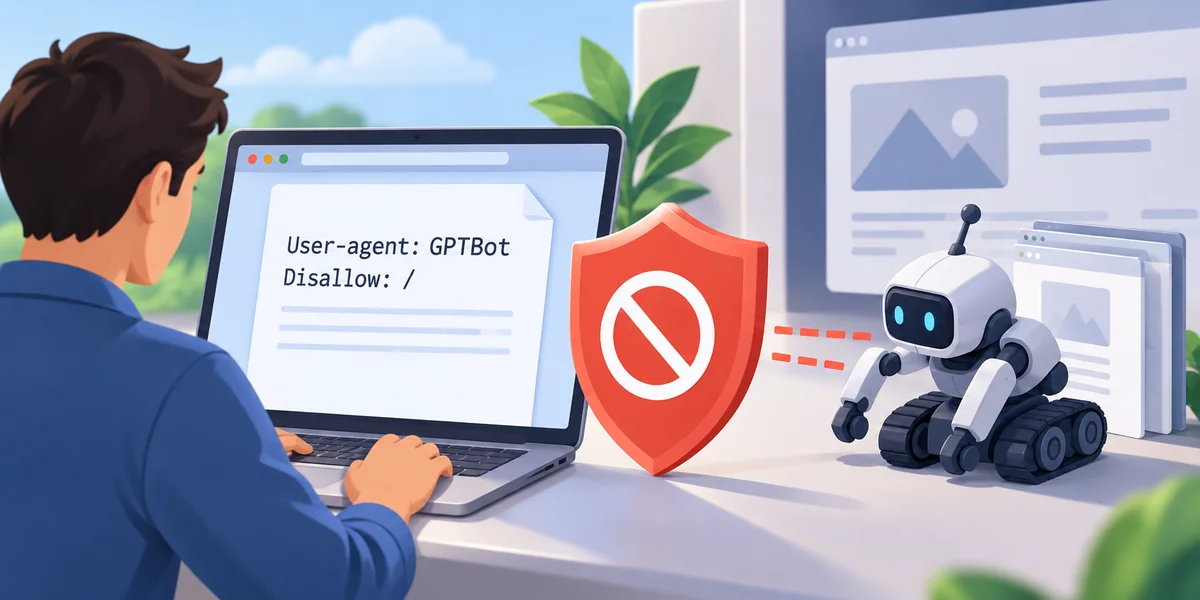
La forma más práctica y ampliamente aceptada de detener al GPTBot de OpenAI de extraer contenido de tu sitio web es configurando un archivo robots.txt. Este archivo de texto plano se aloja en la raíz de tu dominio (por ejemplo, tusitio.com/robots.txt) y actúa como una guía para los rastreadores web que cumplen con las normas. Su propósito principal es indicar a los bots qué se les permite o no hacer al visitar tu sitio.
Cuando un bot como GPTBot intenta acceder a un sitio web, primero verifica este archivo. Si hay reglas definidas para su agente de usuario específico, se espera que las siga. Según la documentación de OpenAI, GPTBot respeta estas directivas, lo que significa que puedes controlar su comportamiento directamente a través de una configuración simple.
¿Cómo Bloquear Completamente a GPTBot?
Para evitar que GPTBot acceda a cualquier parte de tu sitio web, tu archivo robots.txt debe incluir una directiva que apunte específicamente a GPTBot, seguida de una regla de desautorización para todo el sitio. Esta configuración le dice al bot que no es bienvenido para rastrear ninguna URL en tu dominio.
Una entrada correctamente escrita incluiría:
- Una declaración de GPTBot como agente de usuario.
- Una regla de desautorización que se aplique universalmente a tu sitio.
Una vez añadida, GPTBot ya no buscará ni indexará ninguno de tus contenidos, siempre que cumpla con las reglas como se supone. Es una medida simple pero efectiva para recuperar el control del contenido.
¿Por Qué Funciona Este Método?
La razón por la que robots.txt sigue siendo el método preferido es su compatibilidad en todas las plataformas, servidores y entornos de alojamiento. No requiere codificación de backend, bloqueo de API ni reglas de firewall, solo un archivo de texto bien estructurado. También es reconocido y respetado por la mayoría de los rastreadores importantes, no solo GPTBot, lo que significa que puede servir para múltiples propósitos de protección de contenido.
Además, no necesitas instalar complementos o herramientas de terceros, lo que lo hace liviano y de bajo mantenimiento. La mayoría de las plataformas CMS como WordPress o Joomla también permiten el acceso directo al archivo robots.txt, por lo que se pueden realizar cambios sin modificar la base de código de tu sitio web.
Restricciones Parciales: Bloquear Solo Ciertas Secciones
Mientras que bloquear a GPTBot en todo el sitio es un enfoque fuerte, puede que no sea necesario para todos los sitios web. En muchos casos, es posible que desees permitir el acceso de GPTBot a páginas de información general, como entradas de blog o preguntas frecuentes, mientras evitas que rastree áreas sensibles como:
- Contenido exclusivo para miembros
- Datos de precios de productos
- Recursos con pago
- Investigación o documentación propietaria
Es aquí donde el acceso selectivo a través de robots.txt es útil. Puedes configurar el archivo para permitir y desautorizar directorios específicos o incluso URLs individuales. Por ejemplo, podrías permitir que GPTBot indexe /blog/ pero restringir el acceso a /private/ o /members/.
Este control dirigido ofrece una solución intermedia. Preserva la visibilidad donde es beneficioso (como aumentar la autoridad de marca a través de contenido público) mientras protege el contenido que consideras sensible, exclusivo o monetizable.
Estructuración de Reglas Selectivas
Las reglas en robots.txt se pueden personalizar no solo por ruta sino también por tipo de rastreador. Esto significa que GPTBot puede ser manejado independientemente de motores de búsqueda como Googlebot o Bingbot. Si tu estrategia de SEO depende de la visibilidad a través de motores de búsqueda tradicionales, pero no quieres que tu contenido se use para entrenar IA, este enfoque selectivo te da un equilibrio.
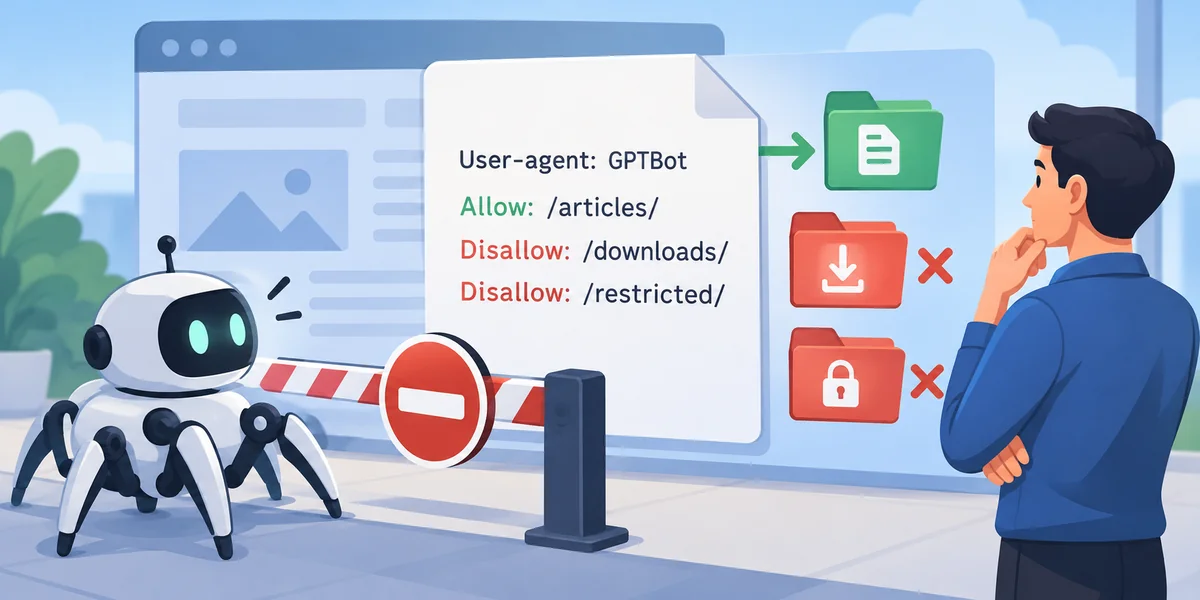
Puedes usar la directiva Allow para permitir explícitamente que GPTBot acceda a carpetas específicas mientras usas la directiva Disallow para negar el acceso a otras, todo dentro del mismo archivo.
Por ejemplo, esta estructura podría reflejar tal preferencia:
- Permitir que GPTBot rastree /articles/
- Bloquear a GPTBot de /downloads/ o /restricted/
Este tipo de estratificación de reglas hace que robots.txt sea una herramienta de control de acceso flexible y eficiente para bots responsables.
Consideraciones Adicionales al Usar robots.txt
Aunque este método es simple, es importante tener en cuenta algunas advertencias:
1. No Bloqueo Retrospectivo
Bloquear el acceso con robots.txt previene el rastreo futuro. No borra ni revoca el acceso al contenido que GPTBot ya haya rastreado. Si el contenido fue indexado antes de que se añadiera el bloqueo, permanece en el conjunto de datos de OpenAI a menos que ofrezcan un método para eliminación manual, lo cual actualmente no está documentado públicamente.
2. Solo Funciona con Rastreadorres Cumplidores
Los bots éticos como GPTBot y Googlebot siguen las reglas de robots.txt, pero algunos rastreadores, especialmente aquellos utilizados para scraping o inteligencia competitiva, pueden ignorarlo. Aunque se ha confirmado que GPTBot cumple, este método no detendrá a actores malintencionados que desprecian las pautas para rastreadores. Para ellos, puede ser necesario el bloqueo a nivel de servidor.
3. Conflictos de Visibilidad y SEO
Si utilizas reglas de desautorización amplias, ten cuidado de no impactar tus clasificaciones SEO de manera no intencionada. Bloquear a GPTBot no perjudicará directamente tus clasificaciones, pero si reutilizas las mismas reglas para los bots de motores de búsqueda, podría limitar tu visibilidad. Asegúrate siempre de que las directivas se apliquen solo a los bots que deseas bloquear.
Conclusión
Para cualquiera que esté preocupado por el uso de su contenido web en el entrenamiento de modelos de lenguaje grandes, robots.txt sigue siendo la forma más sencilla y transparente de optar por no participar. Bloquear el GPTBot de OpenAI no requiere habilidades técnicas de codificación, complementos ni permisos especiales, solo unas pocas líneas de texto en el lugar adecuado.
Al configurar las restricciones apropiadas en tu robots.txt, defines los límites de cómo los rastreadores de IA pueden interactuar con tu propiedad digital, en tus propios términos.
Artículos relacionados
8 Plugins de ChatGPT para Fitness y Bienestar que Impulsan tus Metas de Salud
Qué Ofrece ChatGPT Enterprise y Cómo se Diferencia de Otros Planes
¿Qué es el Intérprete de Código de ChatGPT y Por Qué Es un Cambio de Juego?
ChatGPT: La Herramienta de IA para Compartir tu Historia y Conquistar tu Mercado
Todo lo que Necesitas Saber sobre la App de ChatGPT para iOS y sus Características
Una Guía Completa de las Funciones de Audio de OpenAI, Herramientas y Casos de Uso Reales
Los Do’s y Don’ts de Usar ChatGPT como Asistente de Escritura Freelance
Cómo ChatGPT Puede Ayudarte a Dominar el Arte de Contar Historias Creativas
Límites de Longitud de Entrada de ChatGPT y Técnicas Inteligentes para Superarlos
Aprende a Escribir un Libro de Poesía Usando las Capacidades Creativas de ChatGPT
5 Herramientas Gratuitas de ChatGPT para Redactar Emails de Forma Más Inteligente y Controlar tu Bandeja de Entrada
8 Maneras de Usar ChatGPT para Crecer y Automatizar Tu Pequeño Negocio
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
