
Cómo Funciona el Aprendizaje Profundo y Por Qué Es Importante
En esta página
El aprendizaje profundo es una subcategoría del aprendizaje automático que utiliza redes neuronales artificiales para imitar cómo los humanos procesan la información. Permite a los sistemas aprender y tomar decisiones a partir de grandes conjuntos de datos, impulsando avances en tareas como el reconocimiento de imágenes, el procesamiento del lenguaje natural y los sistemas autónomos. Su potencial sigue transformando industrias en todo el mundo.
¿Qué es el Aprendizaje Profundo?
El aprendizaje profundo es un tipo de aprendizaje automático que se encuentra bajo el paraguas más amplio de la inteligencia artificial. A diferencia del aprendizaje automático tradicional, que a menudo necesita datos estructurados y selección manual de características, el aprendizaje profundo puede encontrar automáticamente patrones y características en datos no estructurados como imágenes, audio y texto.
La función principal del aprendizaje profundo opera a través de estructuras llamadas redes neuronales artificiales, que imitan procesos cognitivos similares a los cerebros humanos. Las redes profundas obtienen su nombre porque organizan capas que extraen características progresivamente más intrincadas de las entradas originales sin guía humana en la definición de características.
¿Cómo Difere el Aprendizaje Profundo del Aprendizaje Automático Tradicional?
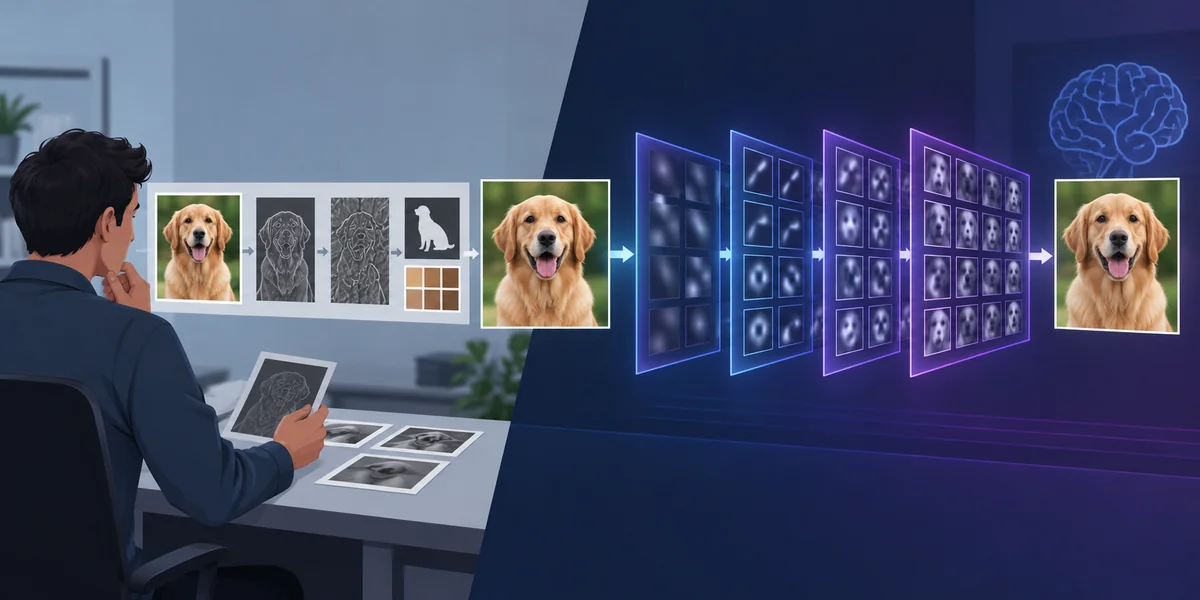
Los sistemas de aprendizaje automático tradicionales requieren selección de características de entrada hechas por humanos, mientras que los modelos de aprendizaje profundo desarrollan estas características por sí mismos. Un sistema que sigue métodos tradicionales requiere personal para extraer bordes, formas y colores manualmente durante los procedimientos de reconocimiento de imágenes. Durante el entrenamiento, un modelo de aprendizaje profundo adquiere los elementos que difieren del método utilizado por los sistemas de aprendizaje automático convencionales.
La distinción principal surge a través del rendimiento escalable. Los modelos de aprendizaje profundo procesan enormes cantidades de datos, superando las capacidades de los modelos convencionales. El aprendizaje profundo logra un mejor rendimiento a medida que aumenta el volumen de datos, lo que lo hace óptimo para los sistemas contemporáneos ricos en datos.
Los Componentes Básicos del Aprendizaje Profundo:
Redes Neuronales Artificiales:
Las redes neuronales artificiales forman la base esencial del aprendizaje profundo. Las redes neuronales básicas operan con la siguiente secuencia de componentes:
- Datos brutos, como los valores de píxeles de una imagen digital, se ingresan a través de la capa de entrada.
- Muchas operaciones computacionales se llevan a cabo en capas sucesivas, conocidas como capas ocultas. La extracción de características ocurre capa por capa desde la salida anterior.
- Capa de Salida: Produce la predicción o clasificación final.
Cada conexión entre neuronas lleva un peso, que se ajusta a medida que la red aprende, ayudando al modelo a hacer predicciones más precisas con el tiempo.
Funciones de Activación:
Las funciones de activación dan vida a las redes neuronales al añadir no linealidad, permitiéndoles aprender y adaptarse a patrones complejos. Algunas de las funciones de activación más populares incluyen:
- ReLU (Unidad Lineal Rectificada): Permite que las redes aprendan más rápido al permitir que solo pasen valores positivos.
- Función Sigmoide: Útil para probabilidades entre 0 y 1.
- Función Tanh: Escala los valores de entrada entre -1 y 1.
Elegir la función de activación adecuada es crucial para el rendimiento y la estabilidad del modelo.
Funciones de Pérdida:
Las funciones de pérdida son clave para refinar las predicciones de un modelo: miden qué tan cerca está la salida del modelo de los resultados reales. Piénsalas como el GPS que guía a tu modelo hacia un mejor rendimiento. Durante el entrenamiento, el objetivo es simple: minimizar la función de pérdida y aumentar la precisión.
Aquí hay dos funciones de pérdida populares:
- Error Cuadrático Medio: Perfecto para problemas de regresión, asegura que las predicciones sean lo más cercanas posible al objetivo.
- Pérdida de Entropía Cruzada: Es la opción preferida para tareas de clasificación, ayudando al modelo a distinguir mejor entre categorías.
Cuanto menor sea la pérdida, más inteligente se vuelve tu modelo. Es como darle a tu IA un curso intensivo en excelencia.
El Proceso de Entrenamiento en Aprendizaje Profundo:
Entrenar un modelo de aprendizaje profundo involucra varios pasos críticos:
1. Propagación Hacia Adelante
En la propagación hacia adelante, los datos de entrada pasan a través de la red capa por capa, y se realiza una predicción. Cada neurona procesa la entrada usando una suma ponderada seguida por una función de activación.
2. Cálculo de Pérdida
Después de obtener una predicción, el modelo calcula el error (o pérdida) comparando el valor predicho con el valor real.
3. Propagación Hacia Atrás
La propagación hacia atrás, o retropropagación, es donde realmente ocurre el aprendizaje. El modelo ajusta los pesos calculando los gradientes de la función de pérdida con respecto a cada peso. Luego, se aplican técnicas de optimización como el descenso de gradiente para actualizar los pesos y minimizar la pérdida.
4. Aprendizaje Iterativo
Este proceso hacia adelante y hacia atrás se repite a lo largo de muchas iteraciones (épocas) hasta que el modelo alcanza un rendimiento satisfactorio.
Arquitecturas Populares de Aprendizaje Profundo:
El aprendizaje profundo incluye varias arquitecturas especializadas, cada una adecuada para tipos particulares de datos y tareas.
Redes Neuronales Convolucionales (CNNs):
Las Redes Neuronales Convolucionales se utilizan principalmente para procesar datos visuales como imágenes y videos. Aplican capas convolucionales para detectar automáticamente bordes, texturas y patrones, haciéndolas altamente efectivas en tareas como el reconocimiento de imágenes y la detección de objetos.
Redes Neuronales Recurrentes (RNNs):
Las Redes Neuronales Recurrentes destacan en datos secuenciales como series temporales, habla y texto. Tienen memoria interna para capturar información de pasos anteriores, permitiéndoles entender el orden y el contexto de las entradas.
Variantes como las redes de Memoria a Largo Corto Plazo (LSTM) resuelven problemas como los gradientes que desaparecen, permitiendo a las RNNs aprender mejor dependencias a largo plazo.
Modelos de Transformadores:
Los transformadores han revolucionado campos como el procesamiento del lenguaje natural. A diferencia de las RNNs, los transformadores procesan todos los datos de entrada simultáneamente en lugar de secuencialmente. Los mecanismos de atención dentro de los transformadores permiten al modelo enfocarse en partes importantes de la entrada, haciéndolos extremadamente poderosos para tareas como la traducción de idiomas y el resumen de textos.
Aplicaciones del Aprendizaje Profundo:
El aprendizaje profundo ya está integrado en muchas tecnologías que las personas usan diariamente:
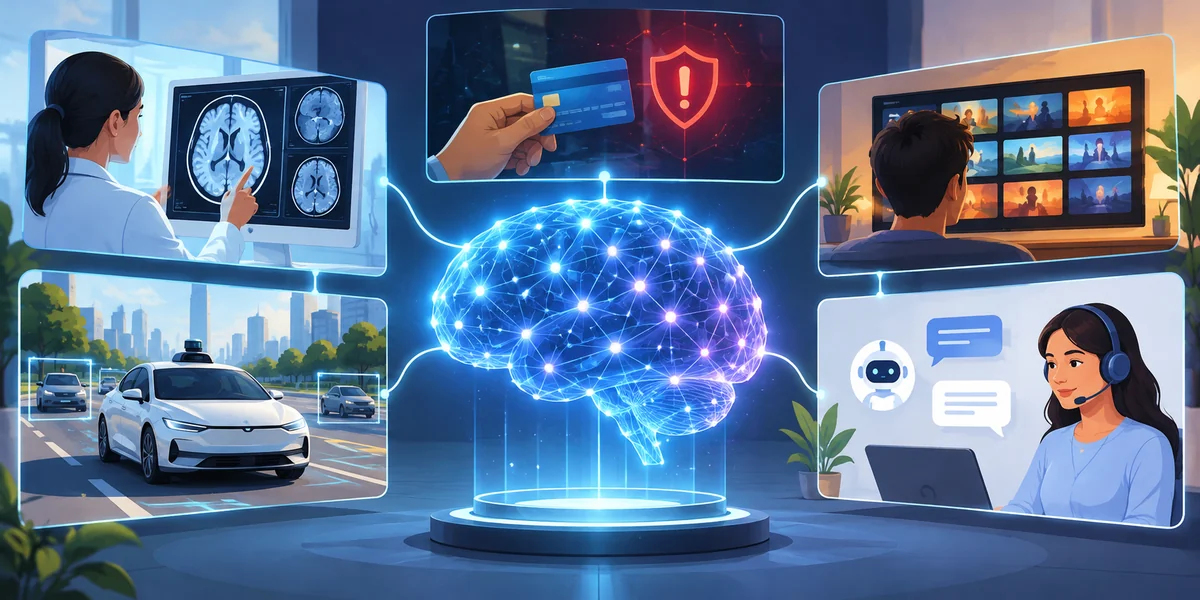
- Salud: Asistiendo en el diagnóstico a través del análisis de imágenes médicas.
- Vehículos Autónomos: Impulsando sistemas de percepción para autos autónomos.
- Finanzas: Detectando transacciones fraudulentas.
- Entretenimiento: Mejorando sistemas de recomendaciones para plataformas de transmisión de música y video.
- Servicio al Cliente: Automatizando respuestas a través de chatbots inteligentes.
Su versatilidad asegura que su impacto seguirá expandiéndose a través de los sectores.
Desafíos en el Aprendizaje Profundo:
A pesar de su éxito, el aprendizaje profundo enfrenta varios desafíos:
Requisitos de Datos:
Los modelos de aprendizaje profundo requieren grandes cantidades de datos etiquetados para funcionar bien. Recolectar y anotar dichos conjuntos de datos puede ser un proceso costoso y que consume tiempo.
Poder Computacional:
Entrenar redes profundas demanda recursos computacionales significativos, a menudo requiriendo hardware especializado como Unidades de Procesamiento Gráfico (GPUs) o Unidades de Procesamiento de Tensores (TPUs).
Interpretabilidad:
Los modelos de aprendizaje profundo son a menudo criticados por ser "cajas negras". Entender por qué un modelo tomó una decisión específica puede ser difícil, lo cual es problemático en campos que requieren rendición de cuentas, como la salud y las finanzas.
Sobreajuste:
Si un modelo aprende demasiado bien los datos de entrenamiento, incluyendo su ruido y valores atípicos, puede desempeñarse mal en datos no vistos. Las técnicas de regularización y la evaluación cuidadosa del modelo son esenciales para mitigar el sobreajuste.
Conclusión:
El aprendizaje profundo ha emergido como una piedra angular de la inteligencia artificial, transformando industrias y habilitando tecnologías que alguna vez se pensaron como ciencia ficción. Al comprender sus principios, arquitecturas y aplicaciones, se obtiene una valiosa perspectiva del motor que impulsa la revolución de la IA actual. Aunque quedan desafíos, el potencial de cambio positivo a través del aprendizaje profundo es vasto, y apenas estamos comenzando a aprovecharlo.
Artículos relacionados

Cómo Utilizar un Generador de Voz de Marca AI para Preservar Voces Específicas de los Canales
Resolviendo Problemas Específicos para Impulsar la Adopción Empresarial de la IA
¿Por Qué Sucede? Enseñando a la IA con Aprendizaje Profundo Causal
Adopción de IA en el Lugar de Trabajo: Esperanzas y Preocupaciones de la Generación Z
El Alcance Creciente del Aprendizaje Profundo Fuera de los Gigantes Tecnológicos
Libros electrónicos gratuitos sobre Inteligencia Artificial para leer en 2025

12 Recursos Principales para Construir un Marco de IA Ética

Orquestando la IA: la Transición de Actos Solitarios a una Sinfonía Completa

Cómo Utilizar Generadores de Anuncios AI para Crear Campañas Publicitarias Personalizadas 5 Veces Más Rápido

Cómo la IA Puede Ser tu Compañero en Recursos Humanos para el Reclutamiento y Compromiso de Empleados

El Centro de Llamadas con IA Ya No es un Mito, Sino una Realidad: 6 Pasos para una Implementación sin Dolor

Marco de Trabajo Ágil Agno para la Creación Rápida de Agentes de IA Multimodal
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
