
Cómo los Ataques Adversariales Están Exponiendo los Riesgos de Seguridad en la IA
En esta página
La Inteligencia Artificial parece magia: las máquinas reconocen rostros, conducen autos y responden preguntas en segundos. Pero detrás de este brillo se esconde un problema serio que a menudo pasa desapercibido: los riesgos de seguridad en la IA. Estos riesgos no provienen de hackers típicos que violan sistemas; en cambio, surgen de algo más insidioso: los ataques adversariales.
Los ataques adversariales manipulan los modelos de IA para que tomen decisiones erróneas utilizando tácticas pequeñas e imperceptibles. Una señal de alto podría malinterpretarse como una señal de límite de velocidad, convirtiendo un sistema seguro en uno vulnerable. En un mundo que adopta rápidamente la automatización, comprender estas amenazas encubiertas no solo es sabio, es esencial para salvaguardar la integridad y confiabilidad de la tecnología.
¿Qué Hace que los Riesgos de Seguridad en la IA Sean Tan Peligrosos?
Los riesgos de seguridad en la IA difieren de los problemas tecnológicos convencionales. No se anuncian como contraseñas robadas o intentos de hacking evidentes. En cambio, se infiltran en el núcleo de la máquina, donde aprende, decide y reacciona. Los sistemas de IA dependen de patrones y datos para funcionar. Sin embargo, si los atacantes les proporcionan patrones engañosos o datos astutos, la IA no comete un error menor: interpreta completamente mal la realidad.
Imagina un escenario donde una empresa utiliza el reconocimiento facial para el control de acceso al edificio. Se siente seguro hasta que alguien manipula el sistema para reconocer a un extraño como un empleado autorizado. No suenan alarmas, solo acceso libre. Esto no es ciencia ficción; esto está sucediendo hoy.
¿La parte alarmante? Estos ataques no dejan rastro. Para nosotros, es una foto de un gato. Pero con alteraciones imperceptibles para la IA, un atacante puede hacer que perciba una tostadora o un árbol. Es como ver a un mago engañar a la persona más inteligente de la sala.
El peligro absoluto de los riesgos de seguridad en la IA radica en su capacidad para explotar la principal fortaleza de la IA, el reconocimiento de patrones, y transformarla en vulnerabilidades. La mayoría de las personas no anticiparán estas amenazas hasta que sea demasiado tarde.
El Mundo Encubierto de los Ataques Adversariales
Los ataques adversariales son como juegos mentales para las máquinas. Aprovechan alteraciones mínimas en los datos de entrada, cambios imperceptibles para los humanos, para confundir completamente a los sistemas de IA. Su objetivo es simple: erosionar la confianza entre la percepción humana y la inferencia de la IA.
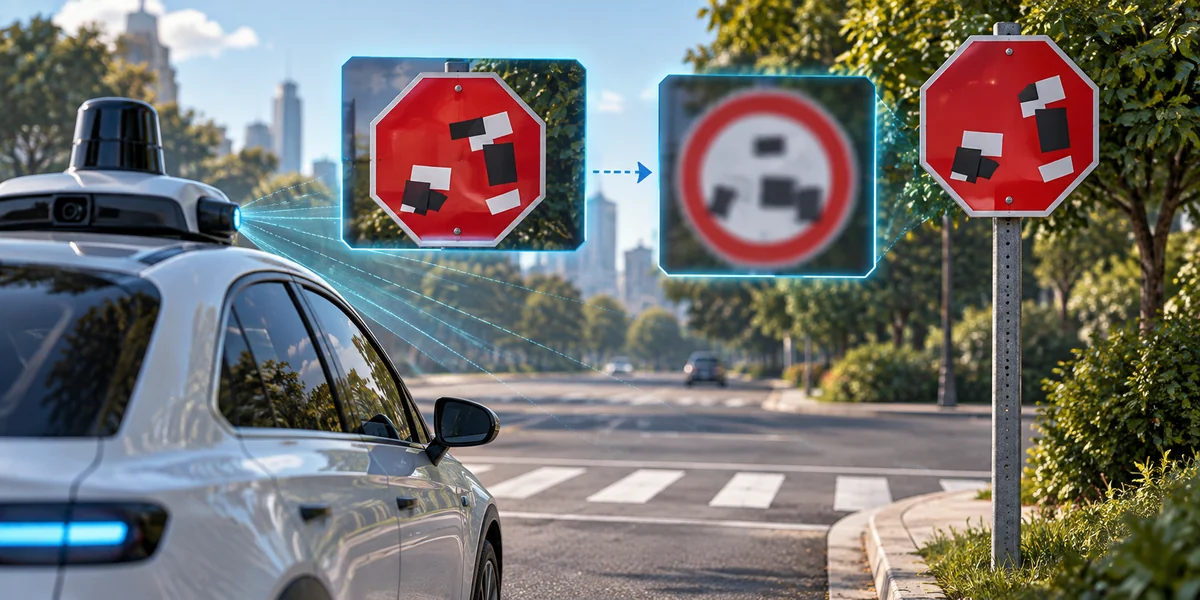
Considera conducir un auto inteligente que se acerca a una señal de alto. Para ti, es inconfundible. Sin embargo, si un atacante coloca estratégicamente calcomanías o marcas en la señal para engañar a la IA del auto, podría malinterpretarla como una señal de límite de velocidad, lo que podría conducir a una situación peligrosa.
Así es como funcionan los ataques adversariales en la realidad: introduciendo ruido digital en imágenes, alterando comandos de audio o manipulando datos de texto para engañar a la IA en su interpretación. ¿Lo más alarmante? Los ataques adversariales están evolucionando rápidamente, con hackers explorando continuamente nuevos métodos para superar las medidas de seguridad.
Estos ataques se extienden más allá de autos y cámaras. Los ataques adversariales están siendo probados en sistemas médicos, herramientas de detección de fraude financiero, asistentes de voz e incluso drones militares. Si la IA lo opera, hay alguien tratando de engañarlo.
¿Por Qué los Ataques Adversariales Son Más Críticos que Nunca?
Las repercusiones de los ataques adversariales trascienden los meros errores embarazosos o fallos técnicos. Implican consecuencias en el mundo real que impactan la seguridad, la protección e incluso la vida humana.
En el cuidado de la salud, un sistema de IA que analiza imágenes médicas podría ser engañado para pasar por alto un tumor o diagnosticar erróneamente una condición. En finanzas, los mecanismos de detección de fraude podrían ser eludidos a través de manipulaciones de datos meticulosamente elaboradas, resultando en pérdidas financieras significativas para las empresas. En hogares inteligentes, los asistentes de voz podrían ser engañados para desbloquear puertas, transferir fondos o revelar información sensible.
Quizás lo más preocupante es el riesgo que representan para los autos autónomos. Una sola señal de tráfico malinterpretada o un peligro en la carretera imperceptible podría desencadenar accidentes. A medida que nuestra dependencia de la IA para decisiones críticas se profundiza, las apuestas aumentan cuando estos sistemas enfrentan ataques.
Los riesgos de seguridad en la IA son una amenaza inminente. No es una cuestión de "si" los atacantes emplearán estas tácticas; está sucediendo ahora mismo. La pregunta fundamental es: ¿Estamos preparados para contrarrestar estas amenazas?
Contrarrestando: Protegiendo la IA Contra los Ataques Adversariales
¿La noticia alentadora? La seguridad de la IA no está estancada. Los desarrolladores e investigadores están activamente diseñando defensas para repeler estos ataques. Sin embargo, al igual que cualquier estrategia de seguridad sólida, no existe una panacea única.
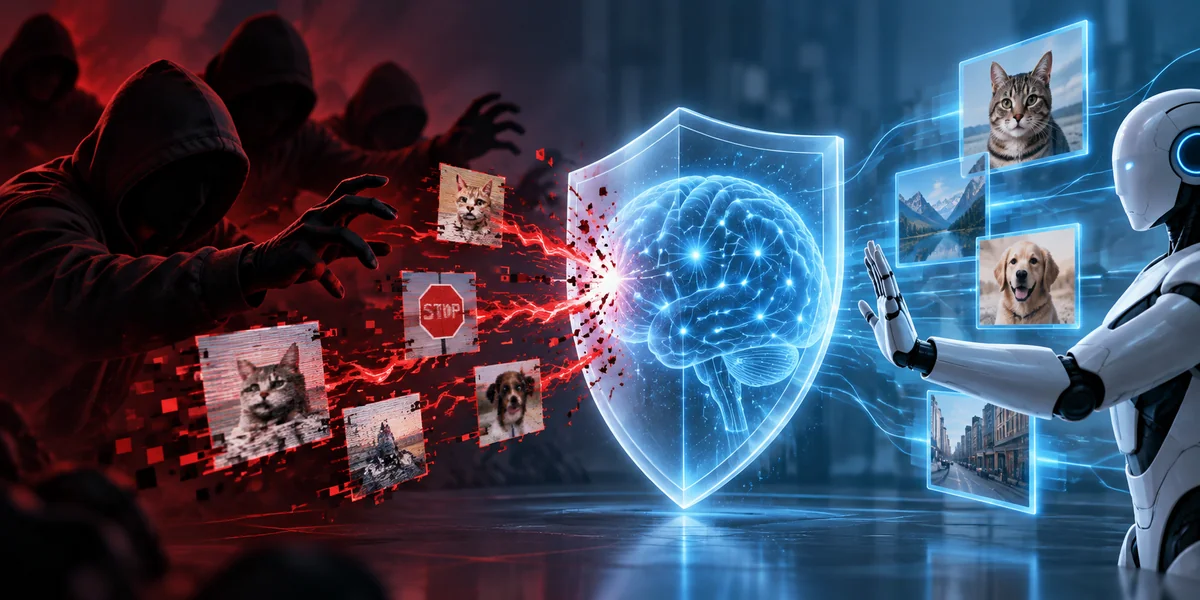
Un enfoque potente es el entrenamiento adversarial. Esto implica someter a los sistemas de IA a ataques adversariales durante su fase de aprendizaje, enseñándoles a discernir estas tretas antes de encontrarlas en escenarios del mundo real. Es como proporcionar a la IA rondas de práctica para anticipar posibles amenazas.
Otra defensa efectiva es la sanitización de entrada. Este método examina y depura todos los datos entrantes antes de que la IA los procese. Si algún dato parece sospechoso, el sistema lo corrige o lo rechaza por completo. Es similar a verificar la identificación de alguien antes de otorgarle acceso a un área segura.
La IA explicable representa otro avance en la defensa. Estos modelos explican la razón detrás de sus decisiones, ayudando a los desarrolladores y equipos de seguridad a identificar anomalías. Si un sistema de IA produce un resultado inesperado, los equipos pueden investigar rápidamente y rectificar el problema.
Naturalm
Artículos relacionados
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
¿Qué es Gemma? Explicación del modelo de IA de código abierto de Google
Construyendo un Chatbot de IA: Una Guía Paso a Paso
Impulsando el Futuro del Comercio Personalizado: IA Generativa en el Marketing Minorista
Cómo la Representación del Conocimiento en la IA Construye Sistemas más Inteligentes
Medir la Adopción e Impacto de la IA
IA Tradicional vs IA Generativa
Más de 20 Prompts de Imágenes AI que Realmente Funcionan para Campañas de Marketing
Reutilización de Contenidos con IA: 5 Formas de Reutilizar tu Contenido para un Impacto Máximo
10 Proyectos de ChatGPT en una Hoja de Trucos
Implicaciones Éticas del Contenido Generado por IA en Medios y Arte
Comprendiendo las Alucinaciones de la IA – Por Qué la Inteligencia Artificial Genera Información Falsa
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
