
Evolución de RAG: De LLMs de Contexto Largo a RAG Agente Autónomo
En esta página
La Inteligencia Artificial sigue evolucionando a un ritmo asombroso, permitiendo a las máquinas no solo comprender y generar lenguaje similar al humano, sino también realizar tareas cada vez más sofisticadas. Uno de los desarrollos más transformadores en este ámbito ha sido la progresión de los modelos de lenguaje grandes tradicionales (LLMs) hacia la Generación Aumentada por Recuperación (RAG) y eventualmente hacia el más autónomo e inteligente RAG Agente.
Este artículo explora el viaje evolutivo de estas tecnologías, comenzando con los LLMs de Contexto Largo, pasando por RAG, y culminando en la avanzada arquitectura de RAG Agente.
Las Limitaciones de los Primeros LLMs
Los LLMs tradicionales como GPT-3 revolucionaron el procesamiento del lenguaje natural al demostrar la capacidad de generar texto fluido, coherente y contextualmente apropiado. Sin embargo, estos modelos tienen limitaciones notables:
- Operan sobre bases de conocimiento estáticas y no pueden acceder a datos en tiempo real o externos.
- Su tamaño de ventana de contexto es limitado, lo que los hace inadecuados para procesar documentos extensos o conversaciones prolongadas.
- Carecen de autonomía, dependiendo únicamente de indicaciones de entrada sin la capacidad de planificar o tomar decisiones.
Como resultado de estas limitaciones, se hizo evidente que los modelos necesitaban comprender contextos más largos, absorber información del mundo exterior y razonar de manera más efectiva. Aquí es donde entraron en juego los LLMs de Contexto Largo y los modelos RAG.
Etapa Uno: LLMs de Contexto Largo
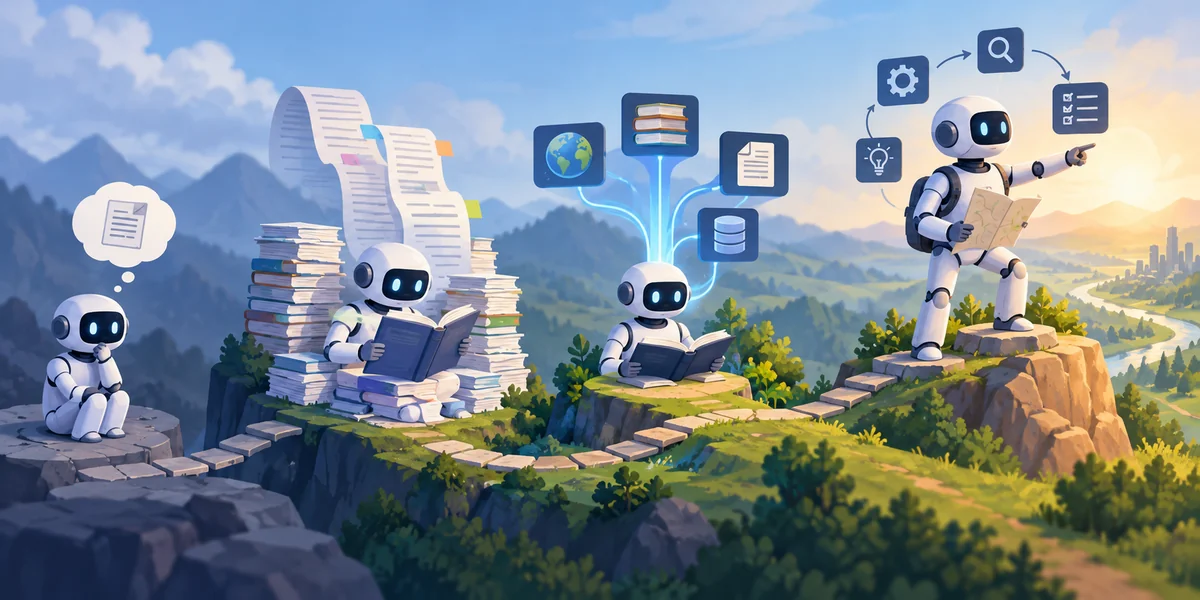
Los LLMs de Contexto Largo son una evolución de los LLMs estándar, diseñados para expandir la ventana de contexto, permitiendo al modelo procesar entradas significativamente más largas. Estos modelos son especialmente útiles para tareas que implican:
- Resumir o analizar grandes documentos
- Mantener la coherencia a lo largo de diálogos extensos
- Navegar a través de indicaciones densas en información
Aunque abordan eficazmente la limitación de tokens, los LLMs de Contexto Largo siguen dependiendo del conocimiento preentrenado. Están limitados cuando se trata de incorporar datos externos o en tiempo real, lo cual es vital en entornos dinámicos o específicos de dominio.
Etapa Dos: Generación Aumentada por Recuperación (RAG)
El siguiente gran hito fue RAG, una arquitectura de modelo que integra mecanismos de recuperación con LLMs. A diferencia de los LLMs de Contexto Largo, los sistemas RAG pueden aumentar el proceso de generación consultando fuentes de datos externas como bases de datos vectoriales o repositorios de documentos.
Cómo Funciona RAG:
- Gestión de Consultas: El sistema procesa la consulta del usuario para optimizar el rendimiento de búsqueda.
- Recuperación de Información: Busca en bases de conocimiento externas documentos relevantes utilizando algoritmos como recuperación densa o búsqueda híbrida.
- Generación de Respuestas: La información recuperada se pasa al LLM, que la utiliza para generar una respuesta más precisa y enriquecida contextualmente.
RAG mejora drásticamente la capacidad de un LLM para generar respuestas precisas, especialmente para consultas que requieren conocimiento actualizado, específico o consciente del dominio. Sin embargo, RAG sigue comportándose como un respondedor pasivo: recupera y genera, pero no planifica ni actúa de manera autónoma.
Etapa Tres: El Auge de RAG Agente
Si bien RAG abordó las limitaciones de conocimiento, no introdujo la toma de decisiones o la planificación estratégica. Esa brecha fue llenada por RAG Agente, un avance que añade una capa de razonamiento autónomo al marco tradicional de RAG.
¿Qué Hace Único a RAG Agente?
- No solo responde a consultas; las evalúa.
- Puede elegir las mejores herramientas, rutas o bases de datos según la complejidad de la tarea.
- Puede decidir si recuperar, generar o usar una herramienta externa como una calculadora o una API de búsqueda.
RAG Agente convierte al LLM en un agente inteligente capaz de orquestar tareas en múltiples pasos. Puede realizar recuperaciones iterativas, autoevaluar la calidad de sus salidas y planificar una secuencia de acciones basadas en sus evaluaciones internas. Este comportamiento orientado a objetivos marca un salto significativo de la generación pasiva al razonamiento activo y la ejecución.
¿Por Qué RAG Agente Importa?
La transición de LLMs de Contexto Largo a RAG y finalmente a RAG Agente es más que una actualización arquitectónica; es un hito evolutivo en el diseño de IA. Cada etapa introdujo una mejora clave: los LLMs de Contexto Largo resolvieron las limitaciones de entrada al extender la ventana de contexto, RAG abordó las limitaciones de conocimiento al recuperar información externa, y RAG Agente resolvió las limitaciones de autonomía al habilitar el razonamiento y la toma de decisiones.
Lo que distingue a RAG Agente es su capacidad para:
- Razonar sobre consultas
- Seleccionar herramientas o estrategias de recuperación de manera dinámica
- Ejecutar tareas de múltiples pasos de manera independiente
Estas capacidades elevan a RAG Agente a una nueva categoría de Sistemas de IA Agente: modelos que no solo son informativos, sino también interactivos y adaptativos. Son esenciales para aplicaciones del mundo real donde la IA debe responder inteligentemente a condiciones complejas y cambiantes. A medida que las industrias avanzan hacia la automatización impulsada por IA, RAG Agente se encuentra a la vanguardia, cerrando la brecha entre el procesamiento de lenguaje estático y la salida inteligente y accionable.
Comparación Arquitectónica: LLMs de Contexto Largo vs. RAG vs. RAG Agente
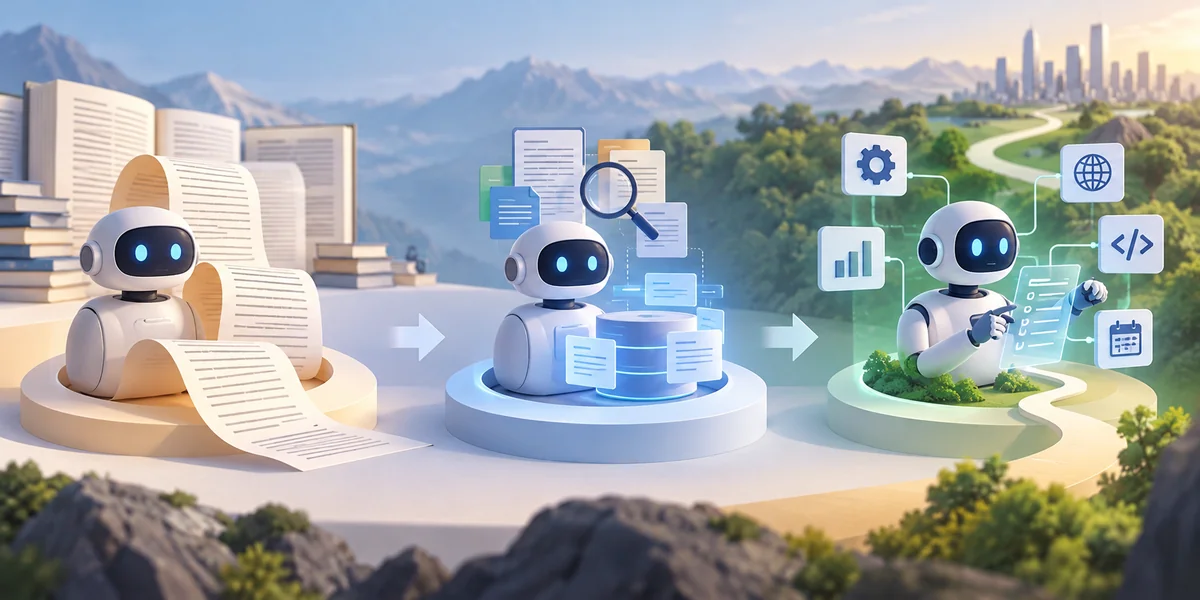
Veamos cómo cada arquitectura se construye sobre la generación anterior:
Característica |
LLMs de Contexto Largo |
RAG |
RAG Agente |
Componentes Básicos |
Solo LLM |
LLM + Módulo de Recuperación |
LLM + Recuperación + Agente de Razonamiento |
Acceso a Datos Externos |
No |
Sí |
Sí |
Toma de Decisiones |
No |
Limitada |
Autónoma |
Uso de Herramientas |
Ninguno |
Solo Recuperación |
Uso de Herramientas Habilitado |
Casos de Uso |
Procesamiento de Forma Larga |
Preguntas y Respuestas Contextuales |
Planificación de Tareas, Flujos de Trabajo de Múltiples Pasos |
LLMs de Contexto Largo
Estos modelos son ideales para manejar contextos extendidos pero carecen de acceso a fuentes externas, limitando su utilidad en entornos de información dinámicos.
RAG
Mejor para precisión fáctica y tareas de conocimiento especializado, RAG mejora los LLMs al integrar información en tiempo real, pero no toma decisiones de manera independiente.
RAG Agente
RAG Agente, el más avanzado de los tres, transforma la inteligencia artificial de un respondedor a un actor autónomo capaz de razonamiento y desempeño de tareas de múltiples pasos.
Conclusión
La evolución de LLMs de Contexto Largo a RAG y finalmente a RAG Agente representa un cambio importante en cómo los sistemas de IA entienden, razonan y actúan. Mientras que los LLMs de Contexto Largo mejoraron la capacidad de entrada, RAG trajo conocimiento en tiempo real a la mezcla. RAG Agente lleva esto más allá al habilitar la toma de decisiones autónoma y el uso de herramientas, permitiendo a la IA manejar tareas complejas y de múltiples pasos.
Con la introducción de Self-Route, ahora tenemos una fusión inteligente que equilibra el rendimiento y el costo. Este avance por capas muestra una trayectoria clara hacia sistemas de IA más inteligentes y adaptativos. A medida que el campo progresa, RAG Agente está preparado para desempeñar un papel clave en la configuración de la próxima generación de IA autónoma.
Artículos relacionados
Los Mejores Blogs y Sitios Web de IA para Seguir en 2025
Medir la Adopción e Impacto de la IA
IA Tradicional vs IA Generativa
Más de 20 Prompts de Imágenes AI que Realmente Funcionan para Campañas de Marketing
Reutilización de Contenidos con IA: 5 Formas de Reutilizar tu Contenido para un Impacto Máximo
10 Proyectos de ChatGPT en una Hoja de Trucos
Robots Sociales y Amigos Virtuales: El Nuevo Rostro de la Compañía AI
Mejorando el Razonamiento Clínico: El Rol de la IA en la Atención Médica Moderna
Cómo los Benchmarks de IA y las Métricas de Rendimiento Definen el Éxito de la IA Moderna
Implicaciones Éticas del Contenido Generado por IA en Medios y Arte
Oracle Lanza Nuevo Estudio de Agentes de IA en la Suite Fusion

IA en el Cuidado de la Salud: Avances Actuales y Oportunidades Futuras
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
