
Cómputo y Almacenamiento de Embeddings Vectoriales con LangChain: Una Guía Completa
En esta página
Detrás de las herramientas de IA que "entienden" el lenguaje se encuentra un concepto simple: números, específicamente embeddings vectoriales. Estos densos y multidimensionales arreglos de números permiten a las máquinas comprender y comparar significados en el lenguaje. Si estás involucrado en el desarrollo de chatbots, sistemas de recomendación o herramientas de búsqueda, eventualmente te encontrarás con embeddings vectoriales.
Sin embargo, los embeddings crudos por sí solos no son suficientes: necesitas generarlos, almacenarlos y hacerlos buscables. Ahí es donde LangChain resulta invaluable. LangChain ayuda a calcular embeddings vectoriales utilizando modelos como OpenAI o Hugging Face y a almacenarlos en bases de datos vectoriales como FAISS, Chroma o Pinecone. Esta guía desglosará el proceso paso a paso, enfocándose en la mecánica central sin adornos innecesarios.
¿Por qué son Cruciales los Embeddings Vectoriales en LangChain?
Los embeddings vectoriales transforman texto en vectores numéricos que transmiten significado semántico. Frases similares producen vectores que están cerca en el espacio vectorial, un principio que impulsa muchos sistemas de IA, desde la búsqueda semántica hasta la respuesta a preguntas basada en recuperación.
LangChain es un marco centrado en modelos de lenguaje, destacando en cómo integra estos modelos con la generación de embeddings y el almacenamiento vectorial. Con LangChain, no necesitas escribir código repetitivo para tokenización, codificación o indexación. En su lugar, puedes usar sus herramientas integradas para calcular embeddings e integrarlos en varias tiendas vectoriales.
Por ejemplo, si estás creando un chatbot de preguntas y respuestas basado en un repositorio de documentos, el proceso es sencillo: divide el texto, embébelo, almacénalo y más tarde recupera fragmentos relevantes usando similitud semántica. LangChain simplifica cada parte de este proceso. Seleccionas un modelo de embedding, introduces tu texto y recibes datos vectoriales listos para almacenamiento y búsqueda.
Guía Paso a Paso: Cómputo de Embeddings Vectoriales con LangChain
LangChain simplifica la generación de embeddings, asumiendo que tu entorno está configurado. Primero, elige un modelo de embedding. LangChain admite varios, incluidos OpenAIEmbeddings y HuggingFaceEmbeddings. Comienza importando tu modelo preferido e inicializándolo con tu clave API o configuración.
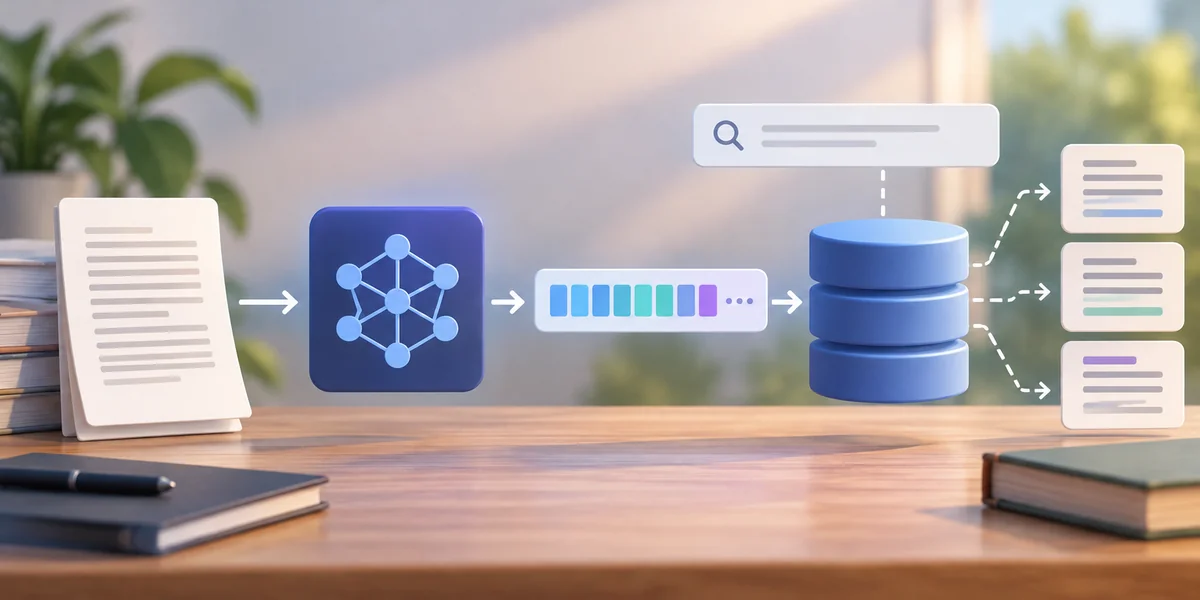
Aquí tienes un ejemplo básico usando OpenAI:
from langchain.embeddings import OpenAIEmbeddings
embeddings = OpenAIEmbeddings()
vector = embeddings.embed_query("LangChain simplifies AI pipelines.")
La función `embed_query` convierte texto en un vector numérico—un arreglo denso de números de coma flotante. Estos vectores son típicamente de 1536 dimensiones (para el modelo text-embedding-ada-002 de OpenAI), permitiendo captar sutilezas semánticas.
El embedding solo no es útil a menos que el resultado se almacene. Ahí es donde entran en juego las tiendas vectoriales como FAISS y Chroma. FAISS es excelente para configuraciones locales, mientras que Chroma ofrece más características de indexación de serie.
Para calcular múltiples embeddings a partir de una lista de textos:
texts = ["LangChain is great for vector search.", "Embeddings are numeric representations.", "Vector stores are essential for retrieval."]
vectors = embeddings.embed_documents(texts)
Ahora has convertido una lista de frases en una lista de embeddings, lista para almacenamiento y búsqueda. LangChain gestiona las llamadas de backend al modelo de embedding, eliminando la necesidad de batching, conversiones de formato o complejidades de tokenización—solo proporciona el texto y recibe vectores utilizables. Esta simplicidad te permite concentrarte en la lógica de la aplicación en lugar de la infraestructura de aprendizaje automático.
Almacenamiento de Embeddings Vectoriales: Haciéndolos Buscables y Útiles
Después de calcular los embeddings, el siguiente paso es almacenarlos. La abstracción de tienda vectorial de LangChain te permite persistir estos vectores junto con metadatos. Ya sea usando FAISS, Chroma o Pinecone, el proceso es similar.
Para almacenar vectores usando FAISS:
from langchain.vectorstores import FAISS
from langchain.docstore.document import Document
docs = [Document(page_content=text) for text in texts]
db = FAISS.from_documents(docs, embeddings)
En este punto, `db` se convierte en tu índice vectorial. Cada documento se embebe y almacena con sus metadatos. Puedes realizar una búsqueda de similitud usando:
query = "What is LangChain used for?"
results = db.similarity_search(query)
LangChain convierte la consulta en un embedding y lo compara con los vectores almacenados. Los resultados incluyen los documentos originales más similares a la consulta, ideal para búsquedas semánticas o agentes basados en conocimiento.
Para asegurar la persistencia—lo que significa que tu base de datos vectorial sobrevive a un reinicio—puedes guardarla y recargarla:
db.save_local("faiss_index")
# Más tarde...
db = FAISS.load_local("faiss_index", embeddings)
Esta capacidad es crucial para aplicaciones en producción, permitiéndote indexar vectores una vez y reutilizarlos a través de sesiones o despliegues. Para despliegues a escala en la nube, puedes cambiar de FAISS a Pinecone o Weaviate con cambios mínimos de código—la interfaz de LangChain se mantiene consistente.
LangChain admite el etiquetado de metadatos, permitiéndote adjuntar detalles como autor, fecha de creación o tema a cada objeto Document. Este contexto adicional ayuda a refinar las búsquedas al permitir filtros basados en metadatos, haciendo que los resultados sean más relevantes y organizados para una recuperación de información más profunda y precisa.
Mejorando las Conversaciones de IA con Generación Aumentada por Recuperación (RAG) en LangChain
El embedding y el almacenamiento forman la base. Sin embargo, el verdadero poder emerge al combinarlo con un modelo de lenguaje usando Generación Aumentada por Recuperación (RAG). Este enfoque recupera documentos relevantes basados en una consulta y los utiliza para generar una respuesta fundamentada y consciente del contexto.
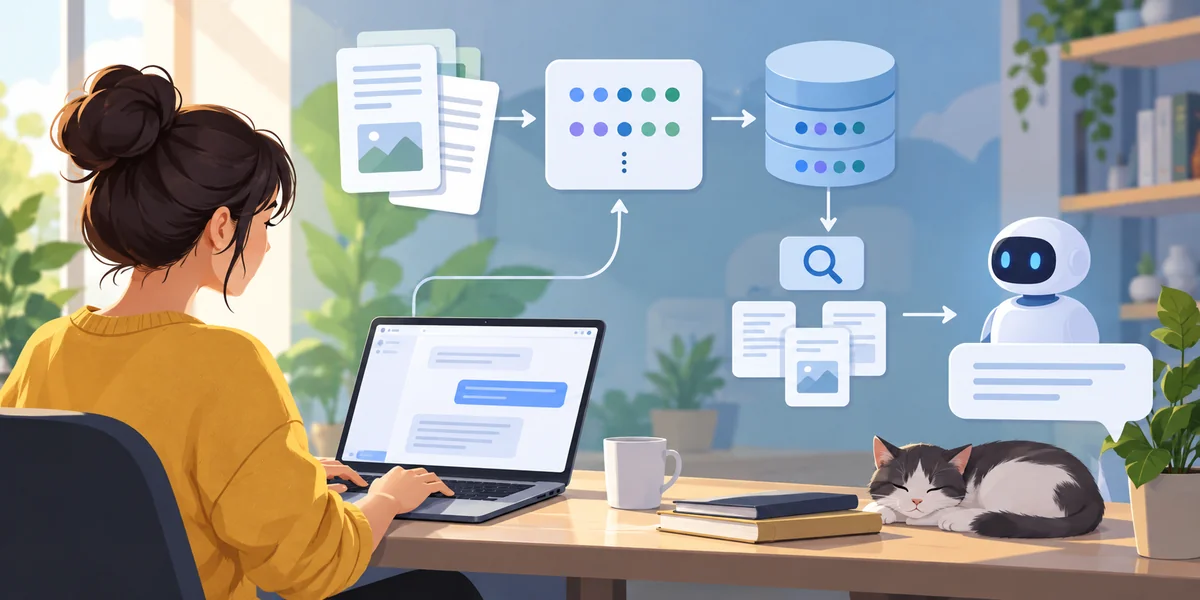
Con LangChain, esto se logra con solo unas pocas líneas:
from langchain.chains import RetrievalQA
from langchain.llms import OpenAI
qa = RetrievalQA.from_chain_type(llm=OpenAI(), retriever=db.as_retriever())
answer = qa.run("How does LangChain handle embeddings?")
Aquí, tu pregunta es embebida, los documentos relevantes se recuperan de la tienda vectorial, y el modelo los utiliza para generar una respuesta. Esto reduce las alucinaciones y produce salidas más precisas, especialmente útil en dominios intensivos en conocimiento.
LangChain gestiona el flujo de trabajo: calcula el embedding de la consulta, encuentra documentos similares, fusiona el contenido en un prompt y obtiene una respuesta del modelo. Puedes extender esto añadiendo memoria, prompts personalizados o encadenando herramientas adicionales, todo dentro del marco de LangChain.
Esta configuración—embeddings, tienda vectorial y LLM—forma la base de muchas aplicaciones avanzadas de IA, unidas sin problemas por LangChain.
Conclusión
Los embeddings vectoriales son vitales para sistemas de IA que interpretan y recuperan lenguaje efectivamente. LangChain simplifica el proceso de calcular, almacenar y buscar estos embeddings a través de un flujo de trabajo consistente y sencillo. Desde la generación de vectores hasta su gestión en diversas tiendas vectoriales, LangChain simplifica pasos complejos en partes manejables. Cuando se empareja con generación basada en recuperación, LangChain permite la creación de aplicaciones más inteligentes y conscientes del contexto. Ya sea que estés desarrollando un chatbot o una herramienta de búsqueda semántica, este enfoque facilita el desarrollo avanzado de IA con menos complicaciones y mayor flexibilidad.
Artículos relacionados
Vast Data Apunta al Desarrollo de IA Agéntica Segura y Rápida
Transforma Tu Estrategia PPC con IA en 3 Pasos Prácticos
Maximizar la Eficiencia: Obtén MÁS Resultados con ChatGPT 101
Por qué combinar la IA con la automatización revolucionará tu flujo de trabajo
Cómo usar ChatGPT de OpenAI para Escribir Correos Electrónicos de Negocios Automáticamente
Cómo la gestión de proyectos con IA puede impulsar la productividad

Desbloqueando Tu Idea de Libro Más Vendido con ChatGPT

La Verdadera Manera de Hacer que el Contenido se Vuelva Viral con ChatGPT
10 Libros Esenciales para Dominar el Procesamiento de Lenguaje Natural
Accesibilidad Cotidiana: Cómo la IA Está Transformando la Vida de las Personas con Discapacidades
Impulsando la Eficiencia Empresarial con Toma de Decisiones Impulsada por IA
Una Guía Completa para el Algoritmo de Backtracking con Aplicaciones Reales
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
