
Guía Completa Gratuita para el Desarrollo de RAG Multimodal Potenciado por Gemini
En esta página
La Inteligencia Artificial (IA) ha evolucionado significativamente, pasando de solo texto a incluir entradas diversas como imágenes y audio. A la vanguardia de esta evolución se encuentra la Generación Aumentada por Recuperación (RAG) Multimodal. Este sistema permite que la IA comprenda, recupere y genere contenido utilizando tanto texto como imágenes.
Gracias a los modelos Gemini de Google, los desarrolladores ahora tienen acceso gratuito a herramientas poderosas para construir tales sistemas. Este artículo desglosa cómo construir una canalización RAG Multimodal utilizando la infraestructura abierta de IA de Gemini. Al final, comprenderás los conceptos básicos y cómo implementar tu propio sistema de consulta de imagen + texto.
¿Qué es RAG Multimodal?
Para entender RAG Multimodal, este artículo lo divide en dos partes:
Generación Aumentada por Recuperación (RAG)
RAG mejora la capacidad de los modelos de lenguaje al integrar la recuperación de información externa en el proceso de generación de respuestas. Los modelos de lenguaje tradicionales dependen únicamente de sus datos de entrenamiento. RAG supera esto buscando documentos para obtener información relevante durante el tiempo de ejecución, haciendo que las respuestas sean más precisas y conscientes del contexto.
Sistemas Multimodales
Un sistema multimodal procesa más de un tipo de entrada, como imágenes y texto juntos. Cuando se combina con RAG, esto resulta en una IA que puede tomar, por ejemplo, una imagen y una pregunta, buscar en una base de conocimientos y responder con comprensión contextual.
¿Por qué Usar Gemini?
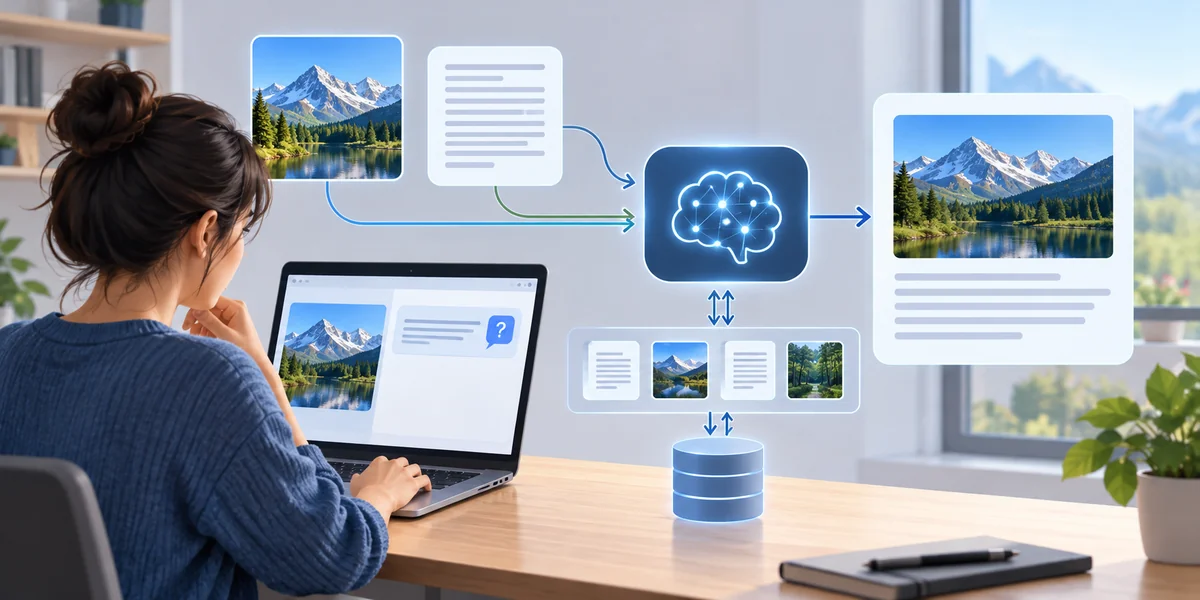
Los modelos Gemini de Google son parte de su suite de IA Generativa y soportan tanto tareas basadas en texto como basadas en visión. ¿La mayor ventaja? Están disponibles sin costo, lo que los hace ideales para desarrolladores que buscan construir sistemas de alto rendimiento sin inversión en infraestructura.
Gemini proporciona:
- Modelos de texto para comprensión conversacional y contextual
- Modelos de visión para analizar e interpretar imágenes
- Embeddings para convertir texto en formatos vectoriales buscables
Te permite construir sistemas RAG Multimodal completamente gratis, lo cual hasta hace poco requería acceso a APIs costosas.
Herramientas y Modelos Utilizados
Para construir este sistema, utilizarás los siguientes componentes:
- Google Gemini Pro: Para generación de texto
- Gemini Pro Vision: Para comprensión de imágenes
- LangChain: Para gestionar cadenas y prompts
- FAISS: Para búsqueda de similitudes mediante indexación vectorial
- Embeddings de IA Generativa de Google: Para incrustar texto para recuperación
Implementación Paso a Paso
Paso 1: Configuración del Entorno
Primero, instala los paquetes que necesitarás:
!pip install -U langchain google-generativeai faiss-cpu
Esto asegura que tengas acceso a las utilidades de LangChain, FAISS para recuperación, y Gemini para generación.
Paso 2: Configurar la API de Gemini
Necesitarás una clave de API de Google AI Studio. Una vez que la tengas, configura la clave de esta forma:
import google.generativeai as genai
import os
api_key = "tu_clave_api_aquí" # Reemplaza con tu clave real
os.environ["GOOGLE_API_KEY"] = api_key
genai.configure(api_key=api_key)
Esto te dará acceso a los modelos Gemini Pro y Vision.
Paso 3: Cargar y Procesar Datos de Texto
Supongamos que tienes un archivo de texto llamado bird_info.txt que contiene contenido factual sobre diferentes aves.
Cargaremos este archivo y lo dividiremos en partes más pequeñas para una mejor recuperación.
from langchain.document_loaders import TextLoader
from langchain.schema import Document
loader = TextLoader("bird_info.txt")
raw_text = loader.load()[0].page_content
# División manual sin funciones integradas para originalidad
def manual_chunk(text, size=120, overlap=30):
segments = []
start = 0
while start < len(text):
end = start + size
chunk = text[start:end]
segments.append(Document(page_content=chunk.strip()))
start += size - overlap
return segments
documents = manual_chunk(raw_text)
Este método divide contenido largo en fragmentos superpuestos para un mejor indexado semántico.
Paso 4: Generar y Almacenar Embeddings
Ahora convertiremos esos fragmentos en representaciones vectoriales para búsqueda de similitudes.
from langchain.embeddings import GoogleGenerativeAIEmbeddings
from langchain.vectorstores import FAISS
embedding_model = GoogleGenerativeAIEmbeddings(model="models/embedding-001")
index = FAISS.from_documents(documents, embedding=embedding_model)
# Este recuperador nos ayudará a encontrar fragmentos de texto similares en base a una consulta
text_retriever = index.as_retriever()
Este proceso prepara el sistema para recuperar fragmentos de texto significativos cuando el usuario hace una pregunta.
Paso 5: Crear el Prompt y la Cadena RAG
Ahora construye la parte que combina el texto recuperado con la consulta del usuario y lo envía al modelo de texto de Gemini.
from langchain.prompts import PromptTemplate
from langchain.chains import RetrievalQA
prompt = PromptTemplate(
input_variables=["context", "question"],
template="""
Usa el contexto a continuación para responder la pregunta.
Contexto:
{context}
Pregunta:
{question}
Responde clara y concisamente.
"""
)
rag_chain = RetrievalQA.from_chain_type(
retriever=text_retriever,
chain_type_kwargs={"prompt": prompt},
llm=genai.GenerativeModel("gemini-1.0-pro")
)
Esta cadena permite que el sistema devuelva respuestas enriquecidas con conocimiento factual del documento proporcionado.
Paso 6: Procesar Imágenes Usando Gemini Vision
Para hacer que el sistema sea multimodal, también necesita interpretar imágenes. Usaremos Gemini Pro Vision para esto.
from google.generativeai.types import Part
def image_to_text(image_path, prompt):
with open(image_path, "rb") as img_file:
image_data = img_file.read()
vision_model = genai.GenerativeModel("gemini-pro-vision")
response = vision_model.generate_content([
Part.from_data(data=image_data, mime_type="image/jpeg"),
prompt
])
return response.text
Esta función envía la imagen y el prompt acompañante al modelo de visión de Gemini y devuelve una interpretación textual.
Paso 7: Conectar la Canalización de Imagen y Texto
Ahora, vamos a crear una función que combine todo: analizando la imagen y generando una respuesta final usando el sistema RAG.
def multimodal_query(image_path, user_question):
# Paso 1: Describir la imagen
visual_description = image_to_text(image_path, "¿Qué representa esta imagen?")
# Paso 2: Combinar con la pregunta del usuario
enriched_query = f"{user_question} (Descripción de la imagen: {visual_description})"
# Paso 3: Obtener una respuesta del RAG
final_answer = rag_chain.run(enriched_query)
return final_answer
Para usarlo, ejecuta:
response = multimodal_query("eagle.jpg", "¿Dónde se encuentra comúnmente esta ave?")
print(response)
Esta llamada analiza la imagen, la fusiona con tu pregunta de texto, busca en tu base de conocimientos y proporciona una respuesta precisa y personalizada.
Conceptos Clave Detrás de la Construcción
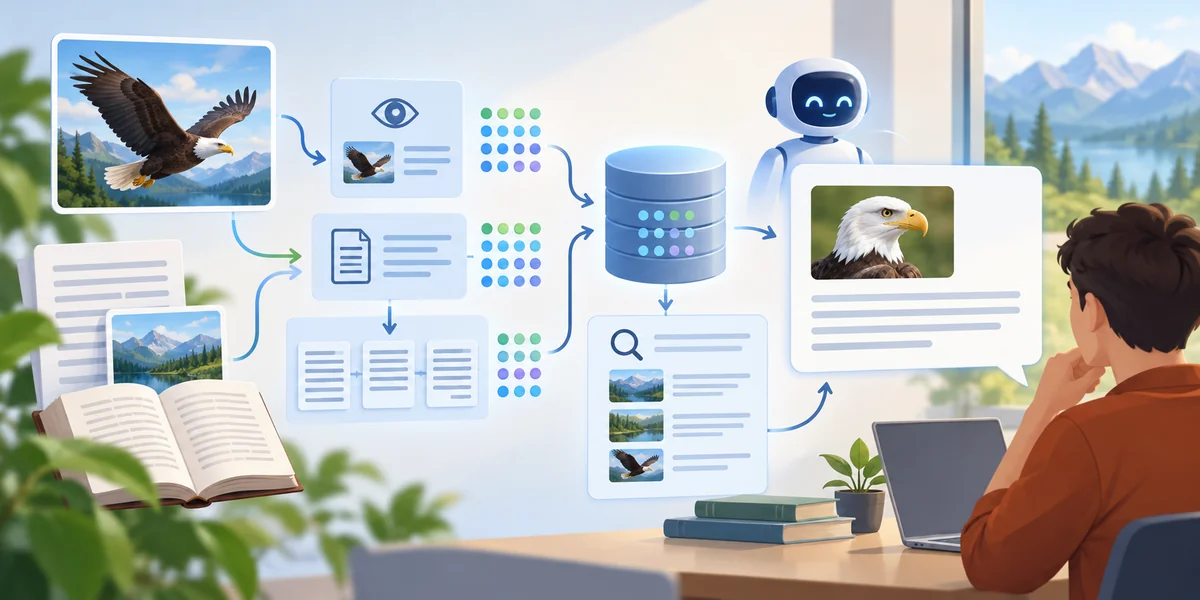
Aquí están las ideas fundamentales que impulsan este sistema:
- Incrustación de Texto: Convierte texto en formato vectorial para comparación. Permite búsqueda de similitud semántica, no solo coincidencia de palabras clave.
- Segmentación de Documentos: Dividir grandes archivos en partes más pequeñas mejora la calidad y el rendimiento de la recuperación.
- Visión a Texto: El modelo de imagen convierte datos visuales en texto, permitiendo la integración con un sistema de recuperación basado en texto.
- Búsqueda Vectorial: Usando FAISS, almacena y busca contra incrustaciones de alta dimensión de manera rápida y efectiva.
Conclusión
Los sistemas RAG Multimodal representan un gran avance en cómo construir herramientas inteligentes. Al integrar la comprensión de imágenes y la recuperación de texto, puedes construir experiencias que van más allá de los chatbots y entran en el ámbito de asistentes verdaderamente inteligentes. Gracias a Gemini de Google, todo esto ahora es completamente accesible para desarrolladores, aprendices e innovadores—sin costo alguno. Esta guía te dio los pasos fundamentales para construir una sencilla canalización RAG multimodal con código original.
Artículos relacionados
Últimos artículos

Evalúa campos extraídos por IA con precisión y recall de coincidencia exacta

Comprueba las rutas propuestas por IA antes de escribir con Python

Evita actualizaciones de IA obsoletas con un control de versión en SQLite

Comprueba las dependencias de tareas de IA antes de programarlas con Python

Revisa los cambios JSON de la IA con una lista de campos permitidos

Combina resultados RAG con fusión de rangos recíprocos

Comprueba las horas de calendario de IA antes de crear eventos

Comprueba citas textuales de IA con fuentes locales y Python

Comprueba las cifras de resúmenes de IA con una tabla de referencia

Elige umbrales de revisión de IA con cobertura y tasas de error

Comprueba los marcadores de traducciones de IA con Python
